どうやってここまで来たのか
計算機械という発想から言語モデルへ、そして自律的なロボットへと、一歩ずつ導いた論文のリスト。
論文で辿る進化
-
1936.05: On Computable Numbers, with an Application to the Entscheidungsproblem
アラン・チューリング。計算そのものを定義した。データとして渡されたどんなプログラムも実行する万能機械。
-
1943.12: A Logical Calculus of the Ideas Immanent in Nervous Activity
ウォーレン・マカロック、ウォルター・ピッツ。最初の数学的ニューロン。重み付きの入力、しきい値、二値の出力。この素子のネットワークは任意の論理関数を計算できる。人工ニューロンはここから始まる。
-
1945.06: First Draft of a Report on the EDVAC
ジョン・フォン・ノイマン。プログラム内蔵方式。プログラムとデータを同じメモリに置き、一つのプロセッサが読み出して実行する。いま最も普及しているパーソナルコンピュータは、フォン・ノイマン型アーキテクチャで作られている。
-
1948.07: A Mathematical Theory of Communication
クロード・シャノン。情報理論。ビット、エントロピー、通信路容量。学習中に見つめる数値である交差エントロピー損失とパープレキシティは、この論文に由来する。英語テキストの最初の n-gram 言語モデルも、ここに載っている。
-
1958.11: The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain
フランク・ローゼンブラット。プログラムされるのではなく、例から重みを学習した最初の機械。線形分類器であり、現代のネットワークのあらゆる層の祖先。
-
1969.08: Gaussian elimination is not optimal
フォルカー・シュトラッセン。2x2 のブロックを 8 回ではなく 7 回の乗算で掛け、n x n 行列のコストを n^3 から O(n^2.81) に下げた。教科書のアルゴリズムが終着点ではないことの最初の証明であり、小さなサイズでは半世紀にわたって破られなかった記録。
-
1986.10: Learning representations by back-propagating errors
デビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズ。多層ネットワークのための誤差逆伝播法を実用にし、有用な隠れ表現を学習できることを示した。いまもあらゆる学習ループが回しているアルゴリズム。
-
1988.08: Learning to Predict by the Methods of Temporal Differences
リチャード・サットン。最終結果を待たず、連続する予測どうしの差から学ぶ。TD-Gammon から AlphaGo の価値ネットワークまで、強化学習の中核をなす更新則。
-
1992.05: Q-learning
クリストファー・ワトキンス、ピーター・ダヤン。環境のモデルなしに、経験だけからあらゆる状態のあらゆる行動の価値を学び、その収束を証明した。のちに DQN が深層ネットワークを載せたアルゴリズム。
-
1992.05: Simple statistical gradient-following algorithms for connectionist reinforcement learning
ロナルド・ウィリアムズ。方策勾配、REINFORCE。報酬を得た行動が起こりやすくなる方向へ、ネットワークの重みを直接動かす。PPO と、RLHF の中の RL ステップの祖先。
-
1995.03: Temporal Difference Learning and TD-Gammon
ジェラルド・テサウロ、IBM。自己対戦と TD 学習でバックギャモンを学び、人間の最強レベルに達したニューラルネットワーク。自己対戦とニューラルな価値関数の組み合わせが機能することの最初の証明。
-
1997.05: Deep Blue
マレー・キャンベル、ジョセフ・ホーン、許峰雄、IBM。毎秒 2 億局面の総当たり探索と手作業で調整した評価関数で、1997 年 5 月にガルリ・カスパロフを破った。これを記述した論文は 2002 年に出た。学習なしのアプローチの頂点であり、のちに AlphaZero が時代遅れにした基準点。
-
1997.11: Long Short-Term Memory (LSTM)
ゼップ・ホッホライター、ユルゲン・シュミットフーバー。ゲートと記憶セルによって勾配が数百ステップを生き延びられるようになり、勾配消失問題を解いた。トランスフォーマーが現れるまでの二十年間、系列モデルの主役だった。
-
2003.03: A Neural Probabilistic Language Model
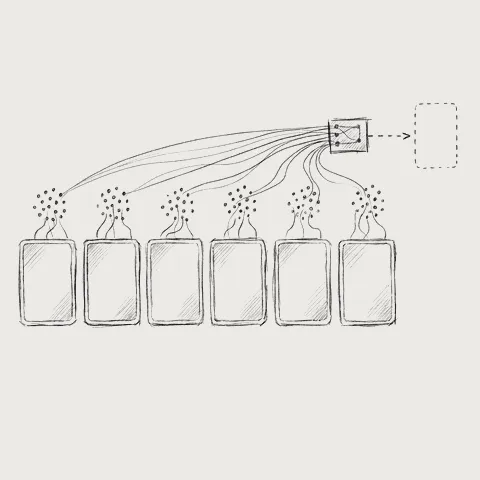
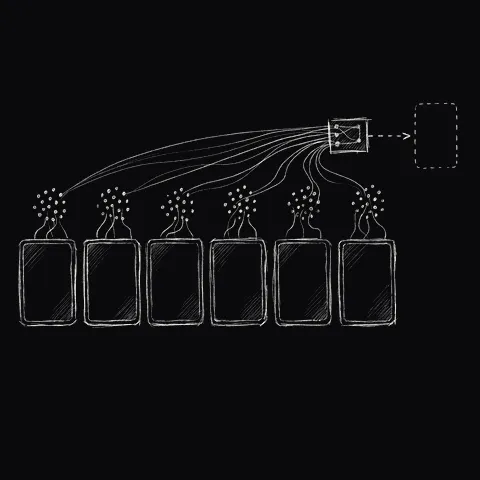
ヨシュア・ベンジオ、レジャン・デュシャルム、パスカル・ヴァンサン、クリスチャン・ジョヴァン。学習した単語ベクトルから次の単語を予測するニューラルネットワーク。GPT がいまも使う埋め込みテーブルと次トークン予測という目的関数は、ここで生まれた。
-
2013.10: Word2Vec (Distributed Representations of Words and Phrases and their Compositionality)
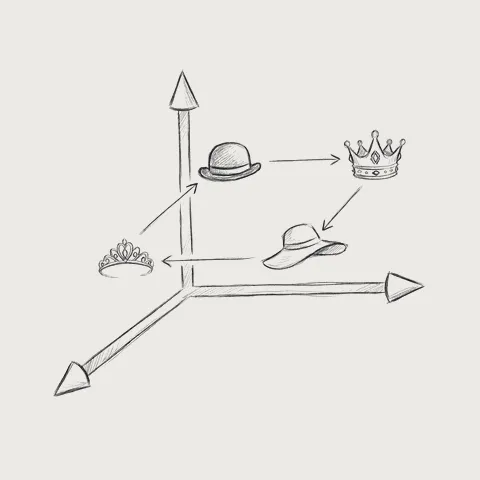
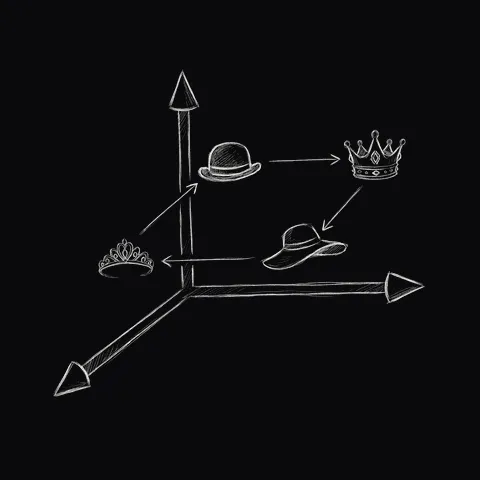
トマーシュ・ミコロフら、Google。negative sampling で学習する安価でスケールする単語埋め込み。king - man + woman ≈ queen のようなベクトル演算。分散表現を標準的な道具にした。
-
2013.12: Playing Atari with Deep Reinforcement Learning
ヴォロディミル・ムニら、DeepMind。生のピクセルを読む畳み込みネットワークによる Q 学習に、経験再生とターゲットネットワークを加え、一つのアーキテクチャで 49 本の Atari ゲームをこなした(Nature 版は 2015 年 2 月)。深層学習と強化学習がここで合流した。
-
2014.09: Seq2Seq (Sequence to Sequence Learning with Neural Networks)
イリヤ・サツケヴァー、オリオル・ヴィニャルス、クォック・リー、Google。LSTM によるエンコーダ・デコーダ。文全体を一つのベクトルに読み込み、そこから別の文を生成する。end-to-end の機械翻訳であり、のちにトランスフォーマーが受け継いだエンコーダ・デコーダ構造。
-
2015.05: Highway Networks
ルペシュ・スリヴァスタヴァ、クラウス・グレフ、ユルゲン・シュミットフーバー。ゲート付きの近道により、数百層のネットワークがそもそも学習できるようになった。七か月後に残差接続が単純化することになるアイデア。
-
2015.12: Deep Residual Learning for Image Recognition
何愷明、張祥雨、任少卿、孫剣、Microsoft Research。残差接続。差分を学習して入力に足す。152 層のネットワークを学習可能にした。トランスフォーマーの各ブロックには、この近道が二つ入っている。
-
2016.01: Mastering the game of Go with deep neural networks and tree search
デビッド・シルバーら、DeepMind。人間の棋譜と自己対戦で学習した方策ネットワークと価値ネットワークが、モンテカルロ木探索を導く。AlphaGo は 2016 年 3 月にイ・セドルを 4 対 1 で破った。予想より十年早かった。
-
2017.06: Attention is All You Need
アシシュ・ヴァスワニら、Google。トランスフォーマー。再帰の代わりに self-attention を使い、系列全体を並列に学習する。GPT、BERT、そしてそれ以降のほぼすべてのアーキテクチャ。
-
2017.07: Proximal Policy Optimization Algorithms
ジョン・シュルマンら、OpenAI。一回の更新で方策が動きすぎないよう、更新をクリップする方策勾配法。単純で安定しており、RLHF の内部も含めて標準の RL 最適化器になった。
-
2017.12: Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm
デビッド・シルバーら、DeepMind。人間の棋譜も手作りの評価関数もなし。AlphaZero はランダムな重みから自己対戦で学び、一つのアルゴリズムでチェス、将棋、囲碁を制した(Science 版は 2018 年 12 月)。Deep Blue から二十年、人間の知識ゼロの探索と学習済みネットワークが最強エンジンを破った。
-
2018.06: GPT-1 (Improving Language Understanding by Generative Pre-Training)
アレック・ラドフォード、カーティク・ナラシンハン、ティム・サリマンス、イリヤ・サツケヴァー、OpenAI。BooksCorpus で次トークン予測を事前学習し、タスクごとに微調整したデコーダのみのトランスフォーマー。1 億 1700 万パラメータ、約 10 億トークン(8 億語、7,000 冊)。
-
2018.10: BERT (BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding)
ジェイコブ・デヴリンら、Google。マスクしたトークンで学習し、双方向に読むエンコーダのみのトランスフォーマー。言語理解タスクを席巻し、事前学習と微調整の組み合わせを NLP の標準にした。
-
2019.02: GPT-2 (Language Models are Unsupervised Multitask Learners)
アレック・ラドフォードら、OpenAI。同じアーキテクチャを拡大。15 億パラメータ、40 GB の WebText、約 100 億トークン。学習していないタスクを zero-shot で解いた。
-
2020.05: GPT-3 (Language Models are Few-Shot Learners)
トム・ブラウンら、OpenAI。1750 億パラメータ、3000 億トークン。文脈内学習。プロンプトに数例を示すだけで、重みを更新せずにタスクをこなす。スケーリングが戦略になった。
-
2020.12: Mastering Atari, Go, chess and shogi by planning with a learned model
ジュリアン・シュリットヴィーザーら、DeepMind。MuZero はルールを教えられることなく、自分で学習した環境モデルの中で計画する。モデルベース強化学習が AlphaZero の水準に達した。
-
2021.03: CLIP (Contrastive Language-Image Pre-training)
アレック・ラドフォード、キム・ジョンウクら、OpenAI。画像とテキストのエンコーダを 4 億組のペアで対照学習し、一つの埋め込み空間を共有させた。zero-shot 画像分類であり、のちのマルチモーダルモデルが立つ橋。
-
2021.07: Highly accurate protein structure prediction with AlphaFold
ジョン・ジャンパーら、DeepMind。アミノ酸配列からタンパク質の立体構造を、残基と残基ペアへの attention によって実験に近い精度で予測する。五十年来のタンパク質フォールディング問題が事実上解かれ、2024 年のノーベル化学賞につながった。
-
2022.03: RLHF (Training language models to follow instructions with human feedback / InstructGPT)
ロン・オウヤンら、OpenAI。教師あり微調整、人間の選好から学習した報酬モデル、そして強化学習。次トークン予測器を、指示に従うアシスタントに変える。ChatGPT の背後にあるレシピ。
-
2022.04: Flamingo: a Visual Language Model for Few-Shot Learning
ジャン=バティスト・アレラックら、DeepMind。凍結した言語モデルと凍結した視覚エンコーダを、少数の学習層でつなぐ。画像とテキストが交互に並ぶ入力での few-shot 学習。最初の強力な視覚言語モデル。
-
2022.10: Discovering faster matrix multiplication algorithms with reinforcement learning
アルフセイン・ファウジら、DeepMind。AlphaTensor は行列乗算アルゴリズムの探索を一人用ゲームに変え、AlphaZero 流の強化学習でそれを遊ぶ。GF(2) 上の 4x4 行列で 47 回の乗算を見つけ、1969 年以来破られなかったシュトラッセンの 49 回を上回った。AI が、分野全体を支えるアルゴリズムを改良した。
-
李俊男ら、Salesforce。小さな Q-Former が凍結した画像エンコーダと凍結した LLM を、わずかな学習コストで橋渡しする。大きなモデルに見る力を与えるために、再学習は要らない。
-
2023.03: PaLM-E: An Embodied Multimodal Language Model
ダニー・ドリースら、Google。ロボットのセンサー値と画像が 5620 億パラメータの言語モデルの中でトークンになり、モデルが行動を計画する。言語モデルがロボティクスに入ってきた。
-
2023.04: LLaVA: Visual Instruction Tuning
劉昊天ら、ウィスコンシン大学マディソン校と Microsoft。視覚エンコーダ、線形射影、オープンな LLM、そして GPT-4 が生成した指示データ。誰でも学習できる、オープンな GPT-4V 風モデル。
-
2023.07: RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
アンソニー・ブローハンら、Google DeepMind。ウェブで事前学習した視覚言語モデルを、ロボットの行動をテキストトークンとして出力するよう微調整した。ウェブの知識がマニピュレーションに転移する。
-
2023.09: GPT-4V System Card
OpenAI。最先端モデルに視覚が加わった。文書の中身はアーキテクチャではなく能力とリスク。マルチモーダルが製品になる。
-
2023.10: Open X-Embodiment: Robotic Learning Datasets and RT-X Models
Google DeepMind を中心とする 21 機関。22 種のロボットから集めた 100 万本の軌道を一つのデータセットにまとめた。その上で学習した RT-X モデルは、異なる身体のあいだで汎化する。ロボティクスが共有コーパスを手に入れた。
-
2024.03: Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context
Google DeepMind。数百万トークンの文脈を持つ Mixture-of-Experts モデル。本一冊、数時間の動画、コードベース全体を一つのプロンプトに。長い文脈が実用になった。
-
2024.05: Octo: An Open-Source Generalist Robot Policy
Octo Model Team、カリフォルニア大学バークレー校ほか。オープンな汎用ロボット方策。80 万本の軌道で学習した 9300 万パラメータのトランスフォーマーで、新しいロボットに数時間で微調整できる。基盤モデルという考え方がロボットに届いた。
-
2024.06: OpenVLA: An Open-Source Vision-Language-Action Model
キム・ムジンら、スタンフォード、バークレー、Google DeepMind、Toyota Research Institute。Open X-Embodiment の 97 万エピソードで学習した 70 億パラメータのオープンな視覚・言語・行動モデル。7 分の 1 のパラメータで RT-2-X を上回った。ロボット制御のためのオープンな重み。
-
2024.08: GPT-4o System Card
OpenAI。テキスト、音声、画像を end-to-end で学習した一つのモデルで、リアルタイムの音声対話を持つ。別々のモデルをつないだパイプラインが、ネイティブなマルチモーダルに置き換わった。
-
2025.01: DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
DeepSeek。正答やテスト通過といった検証可能な報酬による強化学習を言語モデルに直接かけると、長い思考の連鎖による推論がおのずと現れる。OpenAI o1 級のオープンな重み。RL が LLM 学習の中心に戻ってきた。