Как мы тут оказались
Список статей, которые шаг за шагом провели от идеи вычислительной машины к языковым моделям и самостоятельным роботам.
Эволюция в научных статьях
-
1936.05: On Computable Numbers, with an Application to the Entscheidungsproblem
Алан Тьюринг. Определяет само понятие вычисления: универсальная машина, которая выполняет любую программу, поданную ей как данные.
-
1943.12: A Logical Calculus of the Ideas Immanent in Nervous Activity
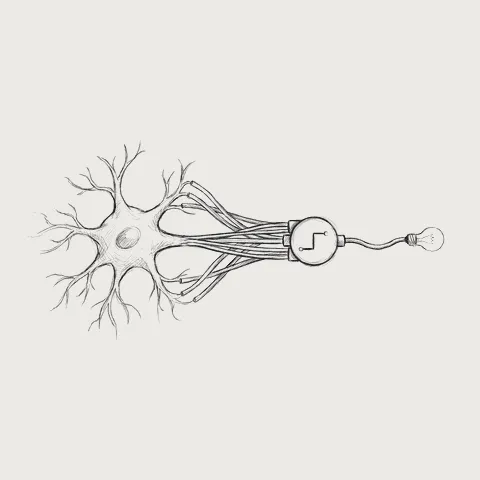
Уоррен Мак-Каллок, Уолтер Питтс. Первый математический нейрон: взвешенные входы, порог, двоичный выход. Сети из таких элементов вычисляют любую логическую функцию. Искусственный нейрон начинается здесь.
-
1945.06: First Draft of a Report on the EDVAC
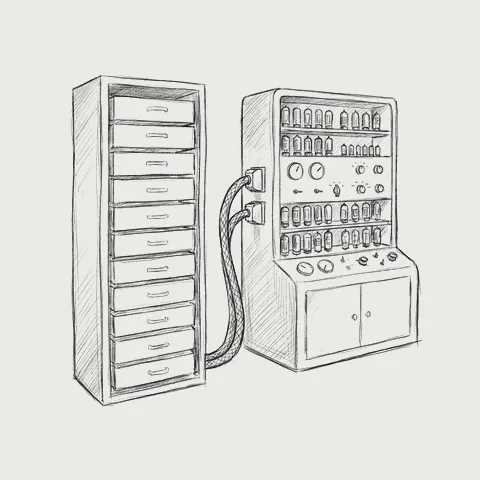
Джон фон Нейман. Архитектура с хранимой программой: программа и данные в одной памяти, один процессор, который их читает и исполняет. Самый распространенный персональный компьютер устроен по архитектуре Фон Неймана.
-
1948.07: A Mathematical Theory of Communication
Клод Шеннон. Теория информации: бит, энтропия, пропускная способность канала. Кросс-энтропия и perplexity, числа, за которыми мы следим при обучении, родом из этой статьи. В ней же первые n-граммные модели английского текста.
-
1958.11: The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain
Фрэнк Розенблатт. Первая машина, которая выучила веса по примерам, а не была запрограммирована. Линейный классификатор и предок каждого слоя современной сети.
-
1969.08: Gaussian elimination is not optimal
Фолькер Штрассен. Умножает блоки 2x2 за 7 умножений вместо 8, и матрицы n x n стоят O(n^2.81) вместо n^3. Первое доказательство, что школьный алгоритм не предел, и рекорд для малых размеров, который продержался полвека.
-
1986.10: Learning representations by back-propagating errors
Дэвид Румельхарт, Джеффри Хинтон, Рональд Уильямс. Обратное распространение ошибки для многослойных сетей: сделано практичным и показано, что оно выучивает полезные скрытые представления. Алгоритм, который до сих пор крутит каждый цикл обучения.
-
1988.08: Learning to Predict by the Methods of Temporal Differences
Ричард Саттон. Учиться на разнице между соседними предсказаниями, не дожидаясь конечного исхода. Базовое правило обновления в обучении с подкреплением, от TD-Gammon до value-сети AlphaGo.
-
1992.05: Q-learning
Кристофер Уоткинс, Питер Даян. Выучить ценность каждого действия в каждом состоянии только из опыта, без модели среды, с доказательством сходимости. Алгоритм, под который DQN позже подставила глубокую сеть.
-
1992.05: Simple statistical gradient-following algorithms for connectionist reinforcement learning
Рональд Уильямс. Policy gradient, REINFORCE: двигать веса сети прямо в ту сторону, где вознаграждённые действия становятся вероятнее. Предок PPO и RL-шага внутри RLHF.
-
1995.03: Temporal Difference Learning and TD-Gammon
Джеральд Тезауро, IBM. Нейросеть, которая выучила нарды, играя сама с собой по TD-обучению, и вышла на уровень лучших людей. Первое доказательство, что self-play плюс нейросетевая оценка позиции работают.
-
1997.05: Deep Blue
Мюррей Кэмпбелл, Джозеф Хоан, Фэн-сюн Сю, IBM. Обыграл Гарри Каспарова в мае 1997 перебором в 200 млн позиций в секунду и оценочной функцией, настроенной вручную; статья с описанием вышла в 2002. Вершина подхода без обучения и планка, которую AlphaZero потом сделала неактуальной.
-
1997.11: Long Short-Term Memory (LSTM)
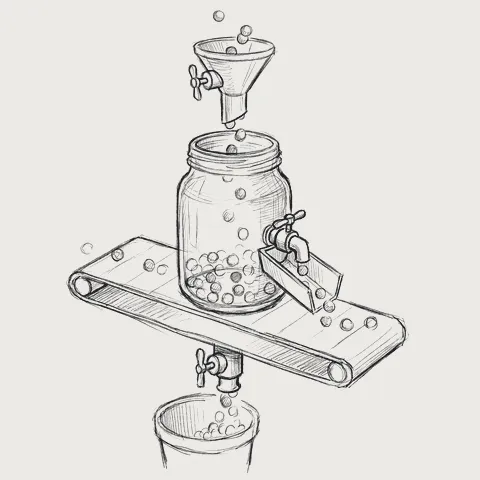
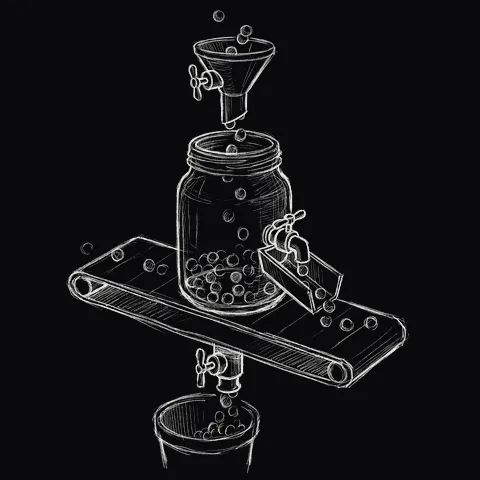
Зепп Хохрайтер, Юрген Шмидхубер. Вентили и ячейка памяти позволяют градиенту выживать сотни шагов, решая проблему затухающего градиента. Главная модель последовательностей двадцать лет, до трансформера.
-
2003.03: A Neural Probabilistic Language Model
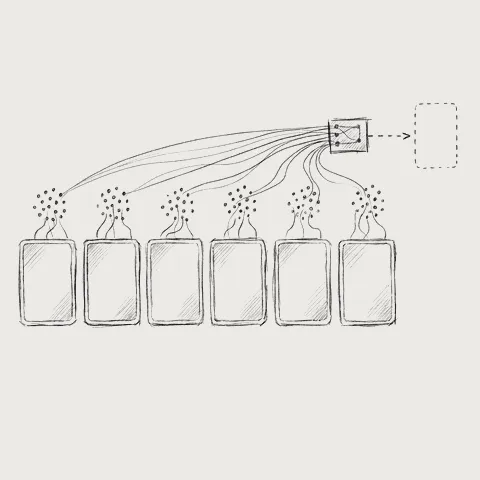
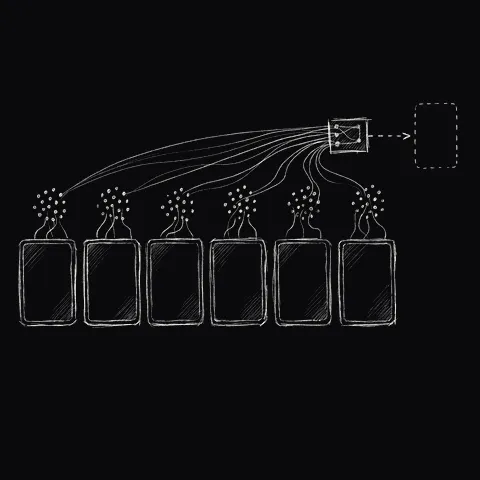
Йошуа Бенджио, Режан Дюшарм, Паскаль Венсан, Кристиан Жовен. Нейросеть, которая предсказывает следующее слово по выученным векторам слов. Таблица эмбеддингов плюс задача «предскажи следующий токен», на которых до сих пор стоит GPT, родились здесь.
-
2013.10: Word2Vec (Distributed Representations of Words and Phrases and their Compositionality)
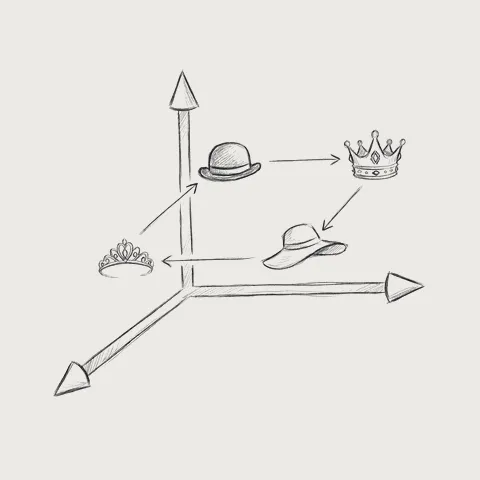
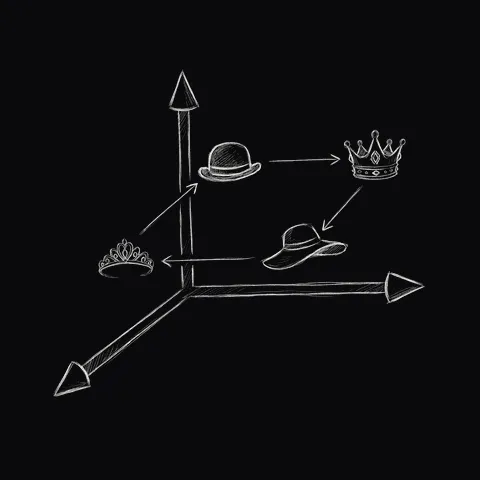
Томаш Миколов и др., Google. Дешёвые масштабируемые эмбеддинги слов с negative sampling; векторная арифметика вроде king - man + woman ≈ queen. Сделали распределённые представления стандартным инструментом.
-
2013.12: Playing Atari with Deep Reinforcement Learning
Володимир Мних и др., DeepMind. Q-learning со свёрточной сетью, читающей сырые пиксели, плюс experience replay и target network: одна архитектура на 49 игр Atari (версия в Nature, февраль 2015). Глубокое обучение и обучение с подкреплением соединились.
-
2014.09: Seq2Seq (Sequence to Sequence Learning with Neural Networks)
Илья Суцкевер, Ориол Виньялс, Куок Ле, Google. Энкодер-декодер на LSTM: прочитать целое предложение в вектор и породить из него другое предложение. Сквозной машинный перевод и схема энкодер-декодер, которую позже унаследовал трансформер.
-
2015.05: Highway Networks
Рупеш Шривастава, Клаус Грефф, Юрген Шмидхубер. Вентильные обходные пути, благодаря которым сети в сотни слоёв вообще стали обучаться. Идея, которую через семь месяцев упростили остаточные связи.
-
2015.12: Deep Residual Learning for Image Recognition
Каймин Хэ, Сянъюй Чжан, Шаоцин Жэнь, Цзянь Сунь, Microsoft Research. Остаточная связь: выучить разницу и прибавить её ко входу. Сделала обучаемыми сети в 152 слоя; в каждом блоке трансформера два таких обхода.
-
2016.01: Mastering the game of Go with deep neural networks and tree search
Дэвид Сильвер и др., DeepMind. Policy- и value-сети, обученные на партиях людей и self-play, направляют поиск по дереву Монте-Карло. AlphaGo обыграла Ли Седоля 4:1 в марте 2016, на десять лет раньше, чем ожидали.
-
2017.06: Attention is All You Need
Ашиш Васвани и др., Google. Трансформер: self-attention вместо рекуррентности, поэтому вся последовательность обучается параллельно. Архитектура GPT, BERT и почти всего, что было после.
-
2017.07: Proximal Policy Optimization Algorithms
Джон Шульман и др., OpenAI. Метод policy gradient, который обрезает каждое обновление, чтобы политика не уходила слишком далеко за шаг. Простой, устойчивый и ставший RL-оптимизатором по умолчанию, в том числе внутри RLHF.
-
2017.12: Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm
Дэвид Сильвер и др., DeepMind. Без партий людей и без ручной оценки: AlphaZero учится self-play со случайных весов, один алгоритм для шахмат, сёги и го (Science, декабрь 2018). Через двадцать лет после Deep Blue поиск плюс выученная сеть без человеческих знаний обыграли сильнейшие движки.
-
2018.06: GPT-1 (Improving Language Understanding by Generative Pre-Training)
Алек Рэдфорд, Картик Нарасимхан, Тим Салиманс, Илья Суцкевер, OpenAI. Трансформер только из декодера, предобученный предсказывать следующий токен на BooksCorpus, затем дообученный под каждую задачу. 117 млн параметров, около 1 млрд токенов (800 млн слов, 7 000 книг).
-
2018.10: BERT (BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding)
Джейкоб Девлин и др., Google. Трансформер только из энкодера, обученный на замаскированных токенах и читающий в обе стороны. Захватил задачи понимания текста и сделал «предобучение плюс дообучение» нормой в NLP.
-
2019.02: GPT-2 (Language Models are Unsupervised Multitask Learners)
Алек Рэдфорд и др., OpenAI. Та же архитектура, но крупнее: 1,5 млрд параметров, 40 ГБ WebText, около 10 млрд токенов. Решала задачи, которым её не учили, zero-shot.
-
2020.05: GPT-3 (Language Models are Few-Shot Learners)
Том Браун и др., OpenAI. 175 млрд параметров, 300 млрд токенов. Обучение в контексте: покажи несколько примеров в промпте, и модель делает задачу без изменения весов. Масштабирование стало стратегией.
-
2020.12: Mastering Atari, Go, chess and shogi by planning with a learned model
Джулиан Шриттвизер и др., DeepMind. MuZero планирует внутри модели среды, которую выучила сама, не зная правил. RL с моделью выходит на уровень AlphaZero.
-
2021.03: CLIP (Contrastive Language-Image Pre-training)
Алек Рэдфорд, Чон Ук Ким и др., OpenAI. Энкодеры картинки и текста, обученные контрастно на 400 млн пар так, чтобы делить одно пространство эмбеддингов. Zero-shot классификация изображений и мост, на котором стоят последующие мультимодальные модели.
-
2021.07: Highly accurate protein structure prediction with AlphaFold
Джон Джампер и др., DeepMind. Предсказывает трёхмерную структуру белка по последовательности аминокислот с точностью, близкой к экспериментальной, через attention по остаткам и их парам. Задача фолдинга белка, стоявшая полвека, по сути решена; в 2024 за это дали Нобелевскую премию по химии.
-
2022.03: RLHF (Training language models to follow instructions with human feedback / InstructGPT)
Лонг Оуян и др., OpenAI. Дообучение с учителем, модель вознаграждения по человеческим предпочтениям, затем обучение с подкреплением. Превращает предсказатель следующего токена в ассистента, который выполняет инструкции; рецепт ChatGPT.
-
2022.04: Flamingo: a Visual Language Model for Few-Shot Learning
Жан-Батист Алейрак и др., DeepMind. Замороженная языковая модель и замороженный визуальный энкодер, соединённые несколькими обучаемыми слоями. Few-shot на чередующихся картинках и тексте; первая сильная визуально-языковая модель.
-
2022.10: Discovering faster matrix multiplication algorithms with reinforcement learning
Альхусейн Фавзи и др., DeepMind. AlphaTensor превращает поиск алгоритма умножения матриц в игру для одного игрока и играет в неё RL в духе AlphaZero. Нашла 47 умножений для матриц 4x4 над GF(2) против 49 у Штрассена, державшихся с 1969 года. ИИ улучшил алгоритм, на котором работает вся отрасль.
-
Цзюньнань Ли и др., Salesforce. Небольшой Q-Former связывает замороженный энкодер картинок и замороженную LLM за малую долю стоимости обучения. Чтобы большие модели увидели, их не нужно переобучать.
-
2023.03: PaLM-E: An Embodied Multimodal Language Model
Дэнни Дрисс и др., Google. Показания датчиков робота и изображения становятся токенами внутри языковой модели на 562 млрд параметров, и она планирует действия. Языковые модели приходят в робототехнику.
-
2023.04: LLaVA: Visual Instruction Tuning
Хаотянь Лю и др., Университет Висконсина в Мэдисоне и Microsoft. Визуальный энкодер, линейная проекция, открытая LLM и инструкции, сгенерированные GPT-4. Открытая модель в духе GPT-4V, которую мог обучить каждый.
-
2023.07: RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
Энтони Броан и др., Google DeepMind. Визуально-языковая модель, предобученная на вебе и дообученная выдавать действия робота как текстовые токены. Знания из интернета переносятся на манипуляцию.
-
2023.09: GPT-4V System Card
OpenAI. Зрение добавлено к модели переднего края; документ о возможностях и рисках, а не об архитектуре. Мультимодальность становится продуктом.
-
2023.10: Open X-Embodiment: Robotic Learning Datasets and RT-X Models
21 организация во главе с Google DeepMind. Миллион траекторий от 22 типов роботов собран в один датасет; модели RT-X, обученные на нём, обобщаются между разными телами. У робототехники появляется общий корпус.
-
2024.03: Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context
Google DeepMind. Модель из смеси экспертов с контекстом в миллионы токенов: целые книги, часы видео, кодовые базы целиком в одном промпте. Длинный контекст становится практичным.
-
2024.05: Octo: An Open-Source Generalist Robot Policy
Octo Model Team, Калифорнийский университет в Беркли и другие. Открытая универсальная политика для роботов: трансформер на 93 млн параметров, обученный на 800 тыс. траекторий и дообучаемый под нового робота за часы. Идея фундаментальной модели доходит до роботов.
-
2024.06: OpenVLA: An Open-Source Vision-Language-Action Model
Му Джин Ким и др., Стэнфорд, Беркли, Google DeepMind, Toyota Research Institute. Открытая модель «зрение-язык-действие» на 7 млрд параметров, обученная на 970 тыс. эпизодов Open X-Embodiment и обошедшая RT-2-X при в 7 раз меньшем числе параметров. Открытые веса для управления роботом.
-
2024.08: GPT-4o System Card
OpenAI. Одна модель, обученная сквозь текст, звук и изображения, с речью в реальном времени. Родная мультимодальность вместо конвейера из отдельных моделей.
-
2025.01: DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
DeepSeek. Обучение с подкреплением на проверяемых наградах, правильный ответ или пройденные тесты, применённое прямо к языковой модели; длинные цепочки рассуждений возникают сами. Открытые веса на уровне OpenAI o1; RL возвращается в центр обучения LLM.