Как измерить каньон по FPV-видео
Сколько воды поместится в каньоне под Коджори, если его перегородить? Вопрос праздный, но это хороший повод пройти всю цепочку фотограмметрии от начала до конца: видео → позы камеры → плотная поверхность → метры → число. Подвигайте две плотины и уровень воды:
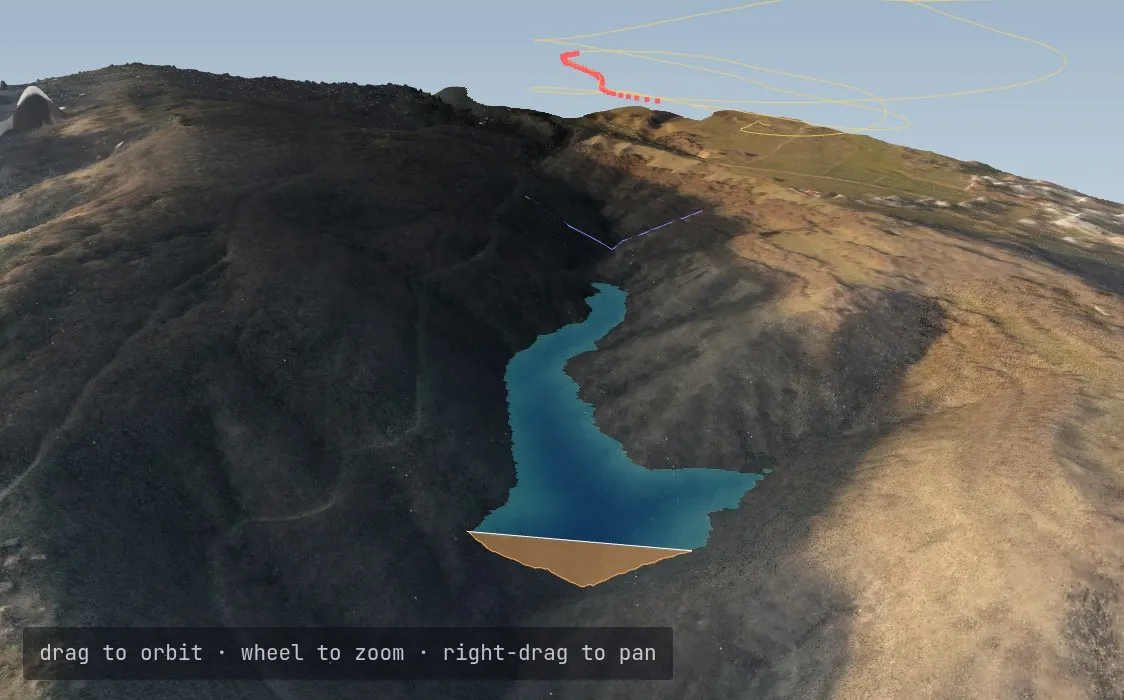
Рельеф здесь - сетка высот с шагом 2 м, объём считается заливкой по той же сетке, и всё это получено из 5,7 минуты обычного FPV-видео. Дальше о том, как. Код, заметки о съёмке и отдельная копия этого демо лежат в репозитории.
Полёт
- Самолёт: ZOHD Altus, двухмоторное крыло из пенопласта с V-образным хвостом, размах 980 мм.
- Автопилот: Matek H743 с ArduPlane 4.6. Автоматический взлёт, затем весь полёт в FBWA (ручное управление со стабилизацией). Два GPS-приёмника u-blox M10 на 5 Гц, барометр и EKF, который объединяет их на 25 Гц.
- Камера: DJI O4 Pro, 4K, стоит в носу на механизме наклона: в полёте её можно отклонять вниз. В этом полёте я пользовался наклоном редко, так что почти всё время она смотрит вперёд и немного вниз. Электронная стабилизация включена, rolling shutter, стабилизирующего подвеса нет. Это FPV-камера, а не камера для съёмки местности.
- Место: каньон к юго-востоку от Коджори, Грузия; старт на высоте 1123 м над уровнем моря.
- Цифры: 27,4 минуты с момента арминга, 31 км пути, до 663 м над точкой старта, медианная путевая скорость 19,6 м/с.
Полёт никак не планировался под картографию: ни маршрута параллельными галсами, ни камеры, которая смотрит отвесно вниз (так снимают для карт), ни опорных точек на земле с известными координатами.
Пять проходов, из которых собрана модель, без монтажа, кроме склеек:
Телеметрия
ArduPilot пишет на SD-карту двоичный лог DataFlash. pymavlink читает его сообщение за сообщением; полезны GPS и GPA (решение и точность), POS (положение по EKF), ATT (ориентация) и ARM.
Детали, которые важно отметить перед разбором:
- GPS. Два приёмника расходятся на 1,1 м (медиана). У второго было больше спутников (26–31), заявленная горизонтальная точность 0,14 м, и именно им пользовался автопилот.
- Часы. Часы полётного контроллера спешили на 0,104 %: 1,7 с за полёт. Прямая, подогнанная от времени лога к эпохам GPS-решений, убирает это с остатком 18 мс.
- Синхронизация с видео. Камера начинает запись по команде ARM, поэтому у времени видео и времени лога общий ноль, с точностью до задержки старта записи. Эту задержку я оставил неизвестной и нашёл позже.
От видео к позам камеры
Ключевые кадры. В видео слишком много почти одинаковых кадров. Я беру кадр, когда изображение сдвинулось на 2,5 % ширины относительно предыдущего взятого (сдвиг измеряется разреженным оптическим потоком). Получается примерно кадр в секунду: 241 кадр из пяти проходов над каньоном, уменьшенный до 1920 px.
Structure from motion (SfM, восстановление структуры по движению; программа COLMAP, инкрементальный режим):
- SIFT-признаки в каждом кадре, сопоставление между всеми парами кадров.
- Каждая пара проверяется геометрически: RANSAC подбирает существенную матрицу и отбрасывает совпадения, которые нарушают эпиполярное ограничение .
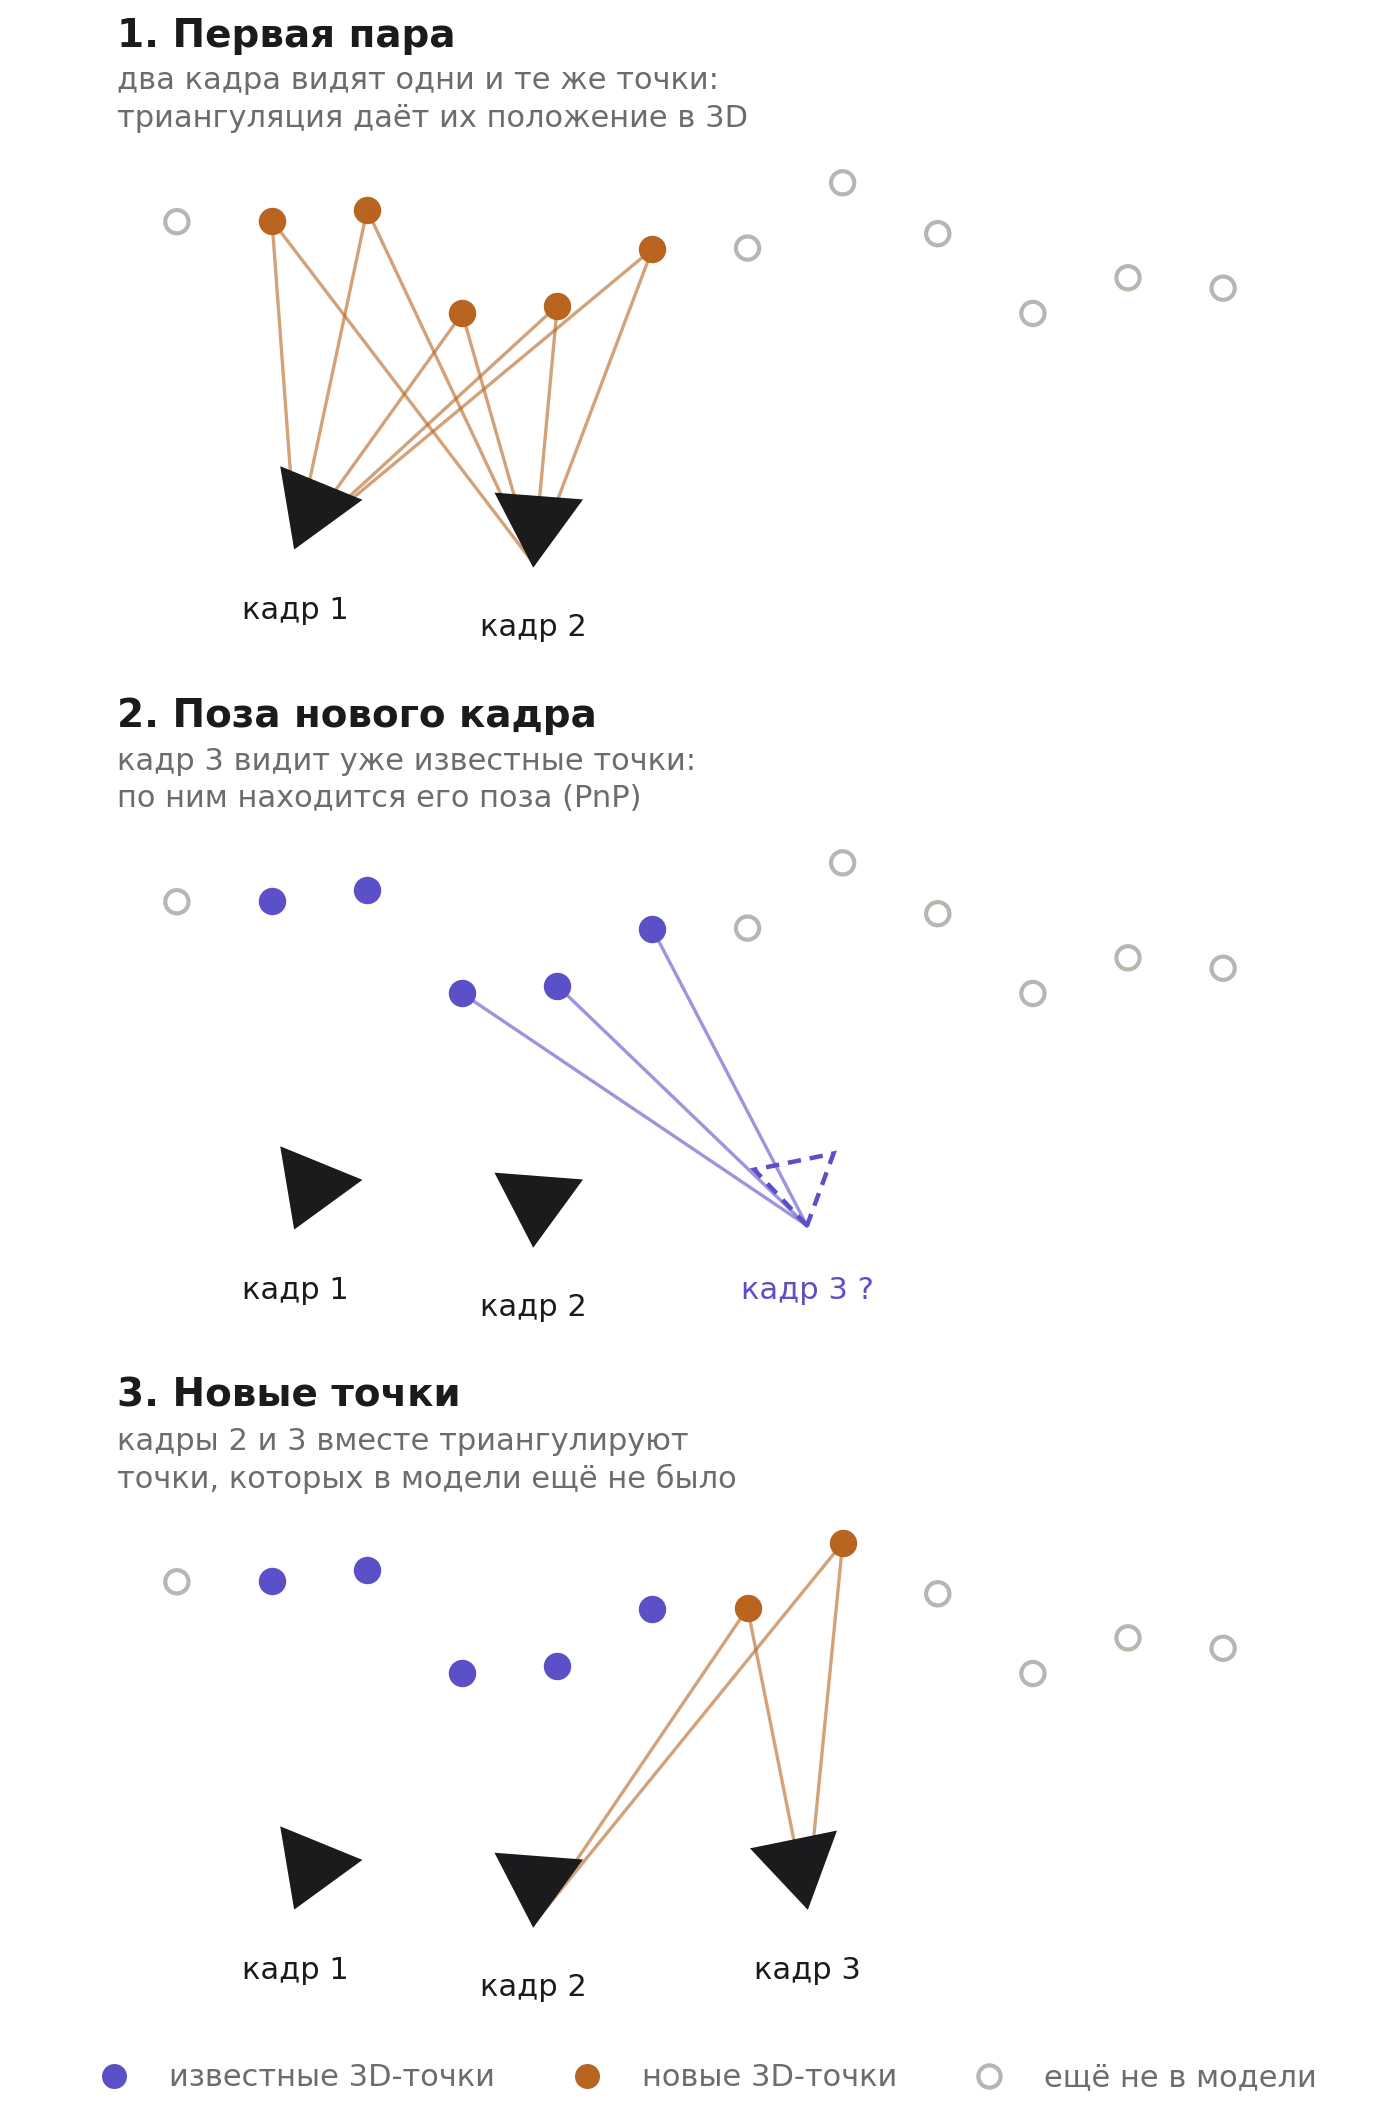
- Начинаем с одной хорошей пары, триангулируем её точки, затем добавляем кадры по одному. Поза нового кадра находится по 3D-точкам, которые он уже видит (PnP внутри RANSAC); новые точки триангулируются; и так далее.
- Каждые несколько кадров bundle adjustment (блочное уравнивание) уточняет всё сразу.
Как сопоставить одну и ту же точку на двух разных кадрах
Пункты 1 и 2 списка выше отвечают на один вопрос: какая точка кадра A и какая точка кадра B - это одно и то же место на земле. Одинаковые пиксели для этого не ищут: пиксель - это одно число яркости, и таких в кадре тысячи. Ищут несколько тысяч приметных точек и сравнивают небольшие окрестности вокруг них. Алгоритм называется SIFT (scale-invariant feature transform). В нём три шага, а после него идёт четвёртый, геометрический.
Все демо ниже работают на двух настоящих кадрах этого полёта. Их разделяют 5 минут и 134 метра: это разные проходы над одним хребтом, камера между ними повёрнута на 55°, до земли около 850 м. Для демо кадры уменьшены до 960 px, дисторсия объектива исправлена.
Шаг 1. Детектор: какие точки выбрать
Какую задачу он решает. Точку из кадра A потом придётся найти в кадре B, снятом с другого расстояния и под другим углом. Детектор смотрит на каждый кадр отдельно и про второй кадр ничего не знает. Значит, он должен выбирать такие места, которые он сам выберет снова на любом другом снимке той же местности. Отсюда три требования:
- положение точки определяется однозначно. Подходят пятна и углы (дом, куст, поворот тропы). Не подходят ровная поверхность (окрестность везде одинаковая) и прямой край: вдоль него окно можно сдвинуть, и картинка в нём не изменится;
- вместе с положением находится размер. Один и тот же дом с 300 и с 900 метров занимает разное число пикселей, а точка на обоих кадрах должна найтись одна и та же;
- шум матрицы и сжатия точек не создаёт.
Детектор отвечает только на вопрос «где и какого размера». Узнаваемой точку делает шаг 2.
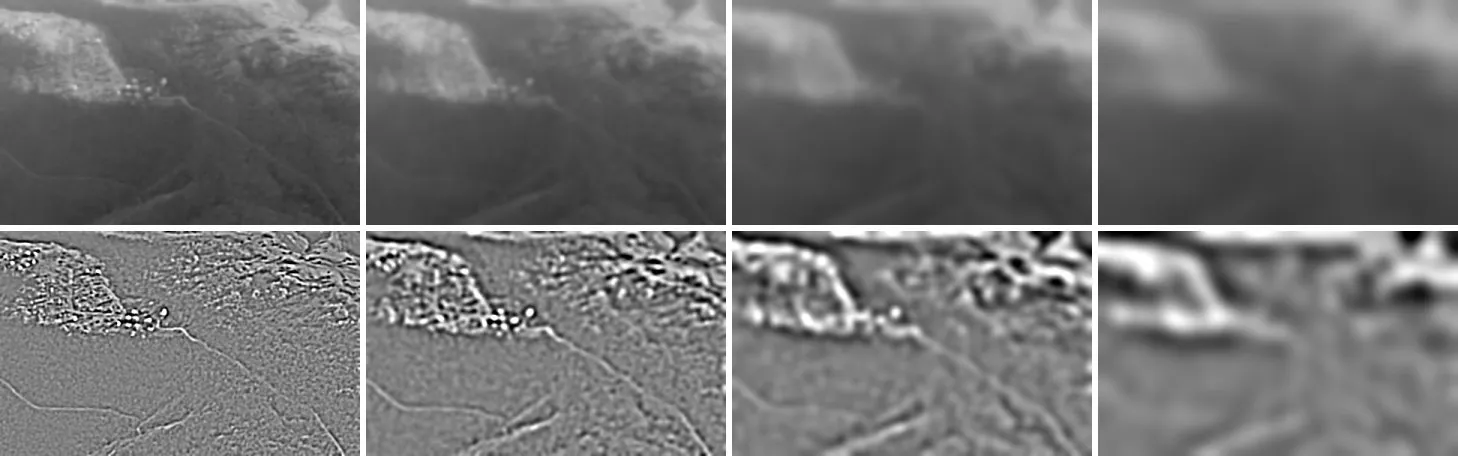
Стопка размытий. Берём кадр и размываем его гауссовым фильтром несколько раз, каждый раз сильнее. Сила размытия измеряется в пикселях: детали мельче исчезают, крупнее остаются. Каждый следующий уровень сильнее предыдущего в раза, то есть через три уровня удваивается. Получается стопка копий одного кадра: в нижней видны отдельные дома, в верхней только склоны.
Разность соседних уровней. Из каждого уровня попиксельно вычитаем следующий: (difference of Gaussians, DoG). Что остаётся после вычитания:
- детали мельче стёрты уже в обоих уровнях. Так уходит мелкий шум;
- плавные перепады яркости (тень облака, дымка) в обоих уровнях одинаковы и сокращаются;
- остаётся то, что первое размытие ещё сохранило, а второе уже стёрло: пятна размером около .
Светлое пятно на тёмном фоне даёт положительную разность, тёмное на светлом отрицательную, ровное место даёт ноль. Разностей на одну меньше, чем размытий, и они тоже лежат стопкой: каждый слой отвечает за свой размер пятен.
Что попробовать:
- пройдите ползунком всю стопку. В первых разностях видны отдельные дома и кроны, в последних только целые склоны;
- наведите на светлое пятно в разности: первое число больше второго. На ровном склоне оба числа почти равны, и разность близка к нулю;
- посмотрите на график строки. Тонкая линия исходной яркости дрожит от шума, размытые идут плавно, а разность заметно отходит от нуля только там, где есть пятно подходящего размера.
Один из 26. Теперь в стопке разностей ищем экстремумы. Каждый пиксель слоя сравнивается с 26 соседями: восемь вокруг него в своём слое, девять в слое ниже и девять в слое выше. Это кубик 3×3×3 без центра. Пиксель становится кандидатом, если его значение больше всех 26 или меньше всех 26.
Экстремум по и означает центр пятна. Экстремум по слою означает, что размер пятна лучше всего совпал с именно этого слоя: в соседних слоях отклик слабее. Так у точки появляются три числа: , и размер .
Два фильтра. Кандидатов получается больше, чем нужно, и часть из них вредна.
Первый фильтр - порог контраста. На ровном небе или однородном склоне экстремумы тоже есть, только создаёт их шум. В другом кадре шум другой, и такая точка там не появится. Поэтому кандидат отбрасывается, если модуль разности в нём меньше порога. В COLMAP порог равен 0,0067 при яркости от 0 до 1.
Второй фильтр - проверка на край. На кромке дороги или гребне крыши разность большая, и порог контраста такую точку пропустит. Но закреплена она только поперёк линии. Вдоль линии все места выглядят одинаково, и в другом кадре детектор поставит точку в другом месте той же линии: совпадение найдётся, а координата будет неверной. Чтобы отличить пятно от края, в точке измеряют кривизну разностного слоя в двух направлениях. У пятна она большая в обоих, это холм. У края она большая поперёк и почти нулевая вдоль, это гребень. Точка отбрасывается, если отношение кривизн больше 10. Сами кривизны для этого не вычисляют, хватает вторых разностей соседних пикселей , , . Точка остаётся, если
Первый фильтр убирает точки, которые не повторятся в другом кадре. Второй убирает точки, которые повторятся не в том месте.
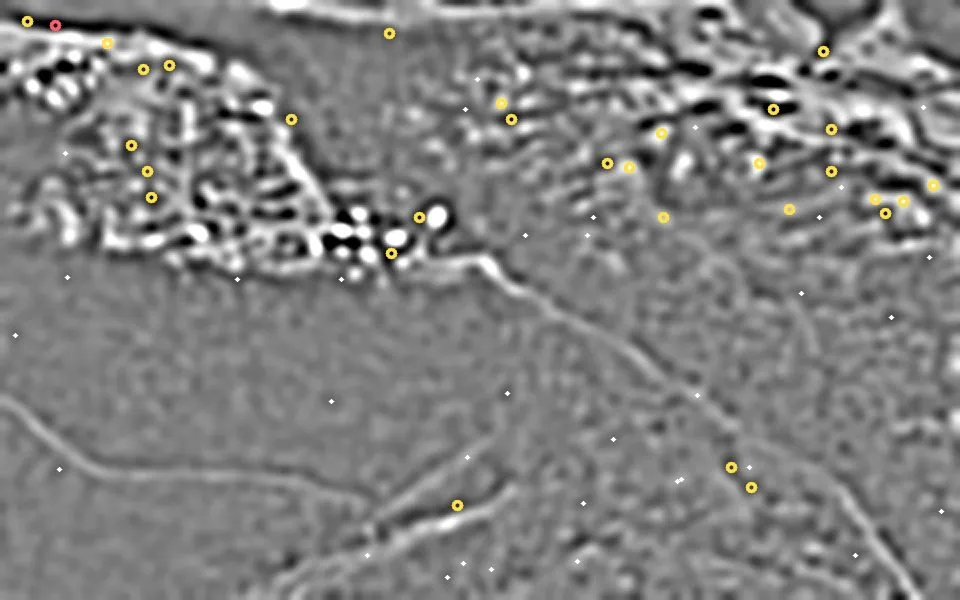
Что попробовать:
- нажмите «ключевая». В трёх сетках 27 чисел, центральное обведено жёлтым и больше (или меньше) всех остальных. Красных рамок нет;
- нажмите «не экстремум». Это пиксель рядом с ключевой точкой: значение у него почти такое же, но у соседа оно дальше от нуля, и сосед обведён красным;
- нажмите «слабая». Экстремум есть, но его значение по модулю ниже порога. Такие точки лежат на ровных местах;
- нажмите «на крае». Под лупой видна полоса, а не пятно. В слоях, где таких точек нет, кнопка неактивна.
Что получается. Демо ниже собирает всё вместе: стопка, разность, экстремумы и оба фильтра на одном фрагменте кадра.
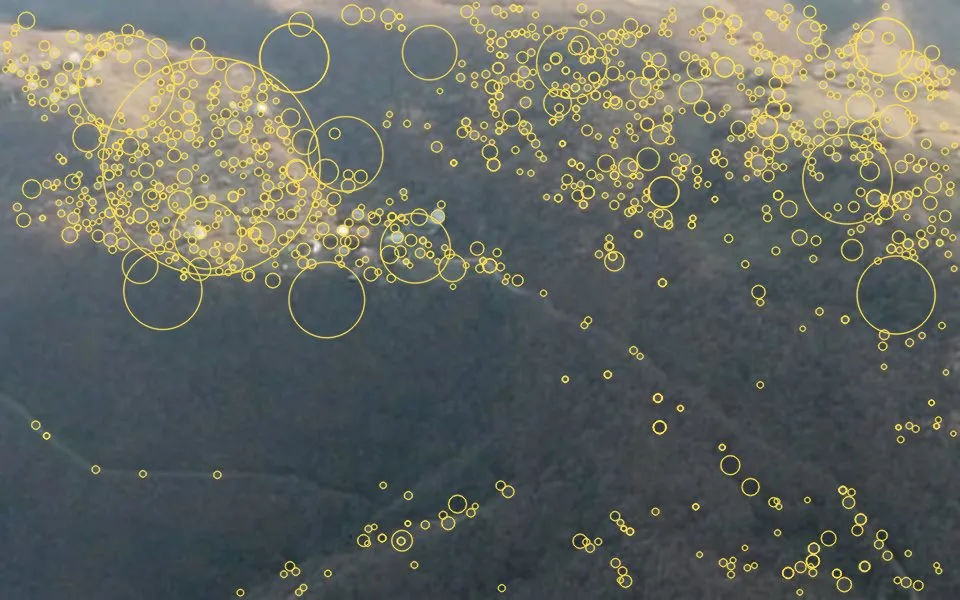
Что попробовать:
- подвигайте : при слабом размытии точек сотни, это отдельные дома и деревья. При сильном остаются единицы, это пятна в десятки пикселей: группа домов, поляна;
- включите «показать отброшенные на краях»: красным отмечены экстремумы, которые лежат на прямом крае. На природном рельефе таких немного, здесь около 5 %;
- поднимите порог контраста: останутся только самые заметные пятна.
Детектор во всех трёх демо упрощён: кадр не уменьшается, и положение точки не уточняется до долей пикселя. Настоящий SIFT после каждого удвоения уменьшает кадр вдвое (это называется октавой), чтобы не размывать большое изображение широким фильтром.
Шаг 2. Дескриптор: как записать окрестность точки числами
Вокруг точки берётся квадратное окно. Его сторона пропорциональна найденному размеру (), и оно повёрнуто по преобладающему направлению градиента яркости рядом с точкой. Окно делится на 4×4 клетки, и в каждой считается гистограмма направлений градиента из 8 корзин. Получается 4·4·8 = 128 чисел. Вектор нормируется.
Каждое решение даёт устойчивость к чему-то одному:
- размер окна от - к расстоянию до объекта;
- поворот окна - к крену камеры;
- градиенты вместо яркости - к освещению;
- нормировка - к контрасту;
- гистограммы по клеткам - к небольшому сдвигу и перспективному искажению.
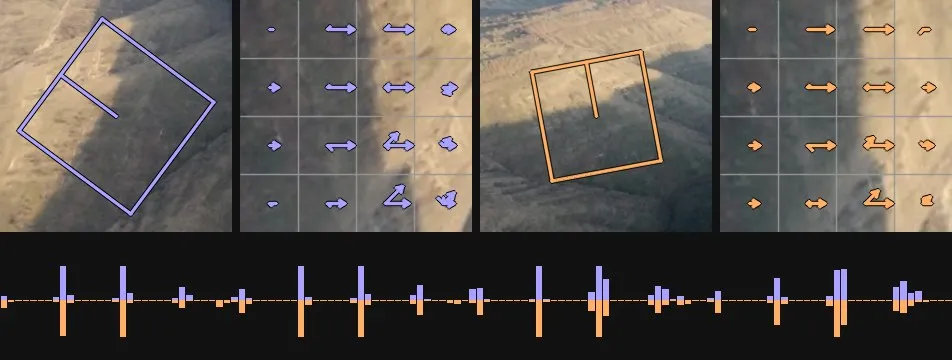
В кадрах A и B окно стоит под разным углом и имеет разный размер. После поворота оба окна показывают почти одно и то же, а лучи в клетках (гистограммы) и столбики внизу почти совпадают.
Шаг 3. Сопоставление
Для каждого дескриптора из кадра A ищется ближайший в кадре B. Мера близости - обычное евклидово расстояние между векторами из 128 чисел. Затем два фильтра:
- Ratio test (тест Лоу). Расстояние до лучшего кандидата должно быть заметно меньше, чем до второго: . Если два кандидата почти одинаковы, это повторяющаяся текстура, и выбрать между ними нельзя.
- Взаимная проверка. Точка из B тоже должна выбрать ту же точку из A.
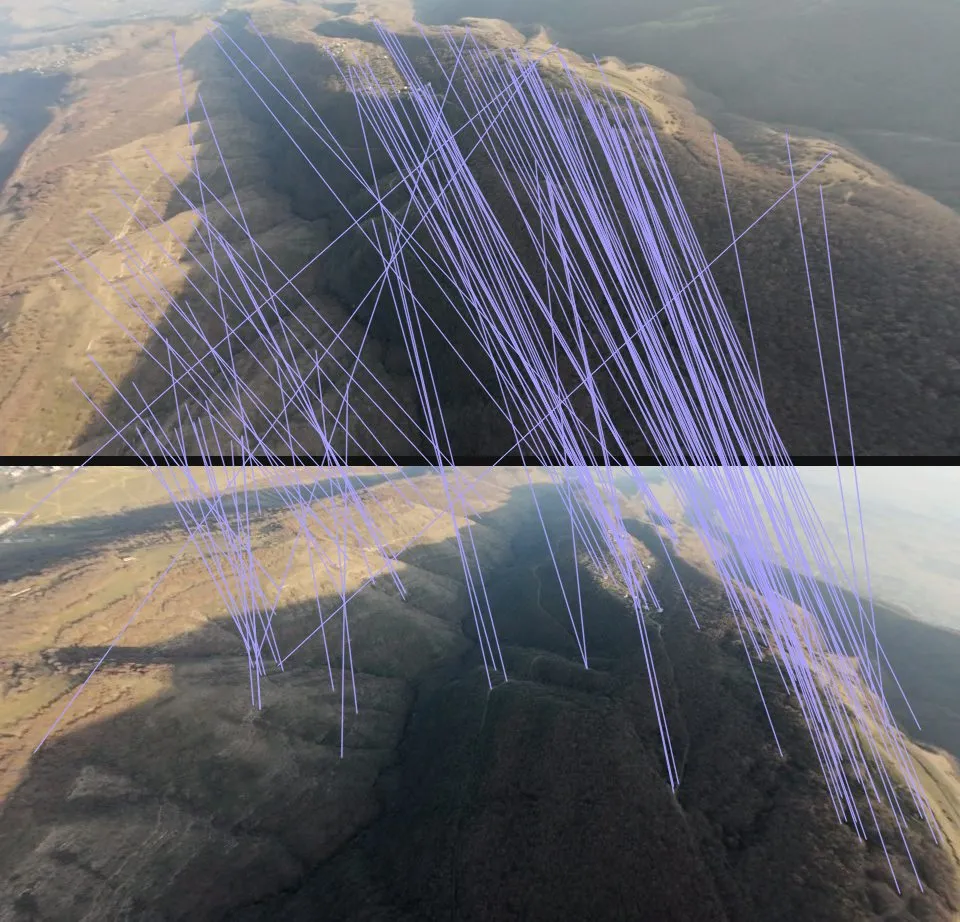
Сдвиньте порог к 1,0: линий становится в несколько раз больше, и новые идут вразнобой. При 0,6 пар мало, но почти все лежат в общем потоке.
Шаг 4. Геометрическая проверка
Дескриптор ничего не знает о положении точки в кадре, поэтому после шага 3 часть пар всё ещё ложная. Расположение точек на двух кадрах не одинаковое: ближние смещаются сильнее дальних (параллакс), и сам кадр может быть повёрнут. Одинаково другое: все верные пары объясняются одним движением камеры. Это эпиполярное ограничение : для точки первого кадра матрица задаёт во втором кадре прямую, и пара этой точки обязана лежать на ней.
Матрицу находит RANSAC:
- Взять случайный набор пар минимального размера и вычислить по нему матрицу.
- Посчитать, сколько остальных пар с ней согласны, то есть лежат к своей прямой ближе допуска.
- Повторить много раз и оставить матрицу с наибольшим числом согласных пар. Несогласные пары выбросить.
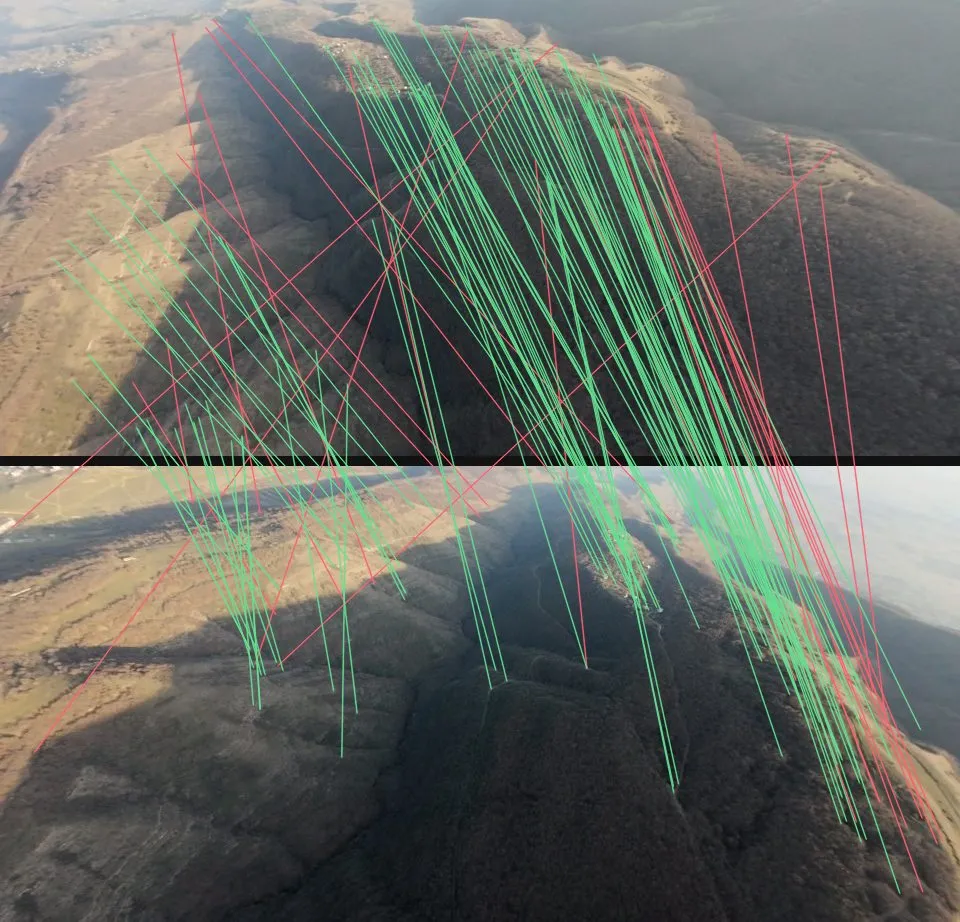
Сколько нужно попыток? Пусть доля верных пар равна , а в наборе пар. Набор целиком верный с вероятностью . Чтобы с вероятностью хотя бы один набор оказался таким, нужно
попыток. При , и это 32 попытки, а при уже 1177. Отсюда два вывода: ratio test стоит перед RANSAC, потому что он поднимает , а набор должен быть как можно меньше.
В демо - фундаментальная матрица, и набор состоит из 8 пар. Она работает прямо в пикселях, калибровка камеры ей не нужна. Существенная матрица из списка выше - то же ограничение для камеры с известной калибровкой : . Ей хватает 5 пар (при это 146 попыток вместо 1177), и из неё получаются поворот камеры и направление её сдвига. COLMAP оценивает для каждой пары кадров три модели: , и гомографию (для плоской сцены или чистого поворота) - и берёт ту, которая лучше объясняет совпадения.
В цифрах этого полёта
Из базы данных COLMAP:
- 241 кадр, медиана 8246 ключевых точек на кадр, всего 1,8 млн;
- каждый кадр сравнивается с каждым: 28 920 пар кадров. Так находятся связи между разными проходами над одним местом;
- совпадения по дескрипторам нашлись в 21 623 парах кадров, геометрическую проверку прошли 15 880 (55 %), медиана 248 совпадений на пару;
- извлечение признаков заняло 8 секунд, сопоставление всех пар - меньше двух минут на RTX 4090;
- у пары кадров из демо в настоящем прогоне 1919 подтверждённых совпадений. В демо их около ста: кадры вдвое меньше, и точек 1500 на кадр вместо десяти тысяч.
Что взято из библиотек, а что написано руками
В конвейере шаги 1–4 - это две команды COLMAP:
colmap feature_extractor --database_path database.db --image_path images \
  --ImageReader.camera_model OPENCV --ImageReader.single_camera_per_folder 1 \
  --ImageReader.camera_params "$FOCAL,$FOCAL,960,540,0,0,0,0" \
  --SiftExtraction.use_gpu 1 --SiftExtraction.max_num_features 8192

colmap exhaustive_matcher --database_path database.db \
  --SiftMatching.use_gpu 1 --SiftMatching.guided_matching 1
Что происходит внутри:
- Детектор и дескриптор - SiftGPU, на видеокарте. Дескрипторы хранятся в варианте RootSIFT: вектор нормируется по сумме, и из каждого числа берётся корень. Совпадения от этого надёжнее.
- Сопоставление - перебор всех пар дескрипторов на видеокарте. Порог ratio test 0,8, взаимная проверка включена.
- Геометрическая проверка - LO-RANSAC, допуск 4 px, минимум 15 согласных пар.
guided_matching- когда геометрия пары кадров найдена, поиск совпадений повторяется, но уже только вдоль эпиполярных прямых. Так возвращаются пары, которые не прошли ratio test. Поэтому подтверждённых совпадений в сумме больше (9,0 млн), чем найденных по дескрипторам (6,6 млн).
Те же четыре шага на OpenCV занимают полтора десятка строк. Так посчитаны точки и дескрипторы для демо:
import cv2, numpy as np

sift = cv2.SIFT_create(nfeatures=1500, contrastThreshold=0.02)
kp_a, des_a = sift.detectAndCompute(gray_a, None)        # шаги 1 и 2
kp_b, des_b = sift.detectAndCompute(gray_b, None)

bf = cv2.BFMatcher(cv2.NORM_L2)                          # шаг 3
two_best = bf.knnMatch(des_a, des_b, k=2)
back = bf.knnMatch(des_b, des_a, k=1)
good = [m for m, n in two_best
        if m.distance < 0.8 * n.distance                 # ratio test
        and back[m.trainIdx][0].trainIdx == m.queryIdx]  # взаимная проверка

pa = np.float32([kp_a[m.queryIdx].pt for m in good])
pb = np.float32([kp_b[m.trainIdx].pt for m in good])
F, inliers = cv2.findFundamentalMat(pa, pb, cv2.FM_RANSAC, 1.5, 0.999)  # шаг 4
Руками написано то, что вокруг:
- отбор ключевых кадров по оптическому потоку:
select_keyframes.py, из OpenCV взятыgoodFeaturesToTrackиcalcOpticalFlowPyrLK; localize_pnp.py: шаги 3 и 4 для нового кадра против готовой модели. Поиск соседей, ratio test, затем PnP внутри RANSAC;- проверки и всё после SfM: тест на зеркальный проход, привязка к GPS, сетка высот, объём;
- демо на этой странице: детектор, поиск соседей, 8-точечный алгоритм и RANSAC на TypeScript без библиотек.
Где SIFT ломается
- наклон поверхности к камере меняется больше чем на 30–40°: окно искажается, и гистограммы перестают совпадать. Поворот кадра вокруг оси объектива не мешает, окно поворачивается вместе с ним;
- повторяющаяся текстура (окна, грядки): такие точки отбрасывает ratio test;
- поверхность без текстуры (вода, снег, небо) и блики: детектору не за что зацепиться;
- смаз от движения.
В этом полёте слабые места - кроны деревьев и глубокая тень. Современная замена - обученные детекторы и сопоставители: SuperPoint с LightGlue, LoFTR. Геометрическая проверка после них та же.
Bundle adjustment - ядро метода. Он двигает все позы камер , общие внутренние параметры с дисторсией и все 3D-точки так, чтобы ошибка репроекции была минимальной:
Здесь - место, где точка наблюдалась в кадре , проецирует через модель объектива, а - робастная функция потерь (soft L1 в локальных уточнениях COLMAP), чтобы ошибочное совпадение тянуло с ограниченной силой, а не с квадратичной. Решатель - Левенберг–Марквардт в Ceres. Быстрым его делает только структура задачи: каждая невязка касается одной камеры и одной точки, поэтому точки можно исключить первыми (дополнение Шура) и остаётся гораздо меньшая система только по камерам.
Результат: все 241 кадр в одной модели, 137 000 точек, медианная ошибка репроекции 0,75 px. Камера не калибровалась по шахматной доске: фокусное расстояние (800,6 px) и радиальная дисторсия () получены из bundle adjustment и совпадают с тем, что дал более ранний полёт с той же камерой.
От поз к поверхности
Multi-view stereo. Для каждого кадра PatchMatch из COLMAP оценивает глубину и нормаль поверхности в каждом пикселе, сравнивая небольшой фрагмент с десятью соседними кадрами (нормированная кросс-корреляция). Удачные гипотезы распространяются на соседние пиксели и случайно возмущаются, и это намного дешевле, чем перебирать все глубины. Второй проход оставляет только те глубины, с которыми согласны соседние кадры.
Слияние объединяет 241 карту глубины в одно облако и оставляет точку, только если её подтверждают несколько видов: 8,0 млн точек. Это заняло 89 минут на RTX 4090, большую часть времени всего конвейера.
Метры: привязка модели к GPS
У реконструкции по одной камере нет масштаба, севера и верха: она верна с точностью до преобразования подобия, это семь неизвестных. GPS их убирает. У каждого ключевого кадра есть время, значит, есть и положение по GPS; SfM даёт той же камере положение в единицах модели. Решение Умеямы в замкнутой форме находит масштаб , поворот и сдвиг , которые лучше всего переводят один набор точек в другой:
где - центры камер из SfM, - положения по GPS, а - задержка между видео и логом. Я перебираю и беру лучшую подгонку:
- задержка 1,15 с (камере нужно около секунды, чтобы начать запись после арминга);
- масштаб 162,5 м на единицу модели;
- невязка 3,0 м (СКО) по 223 камерам. Если подгонять каждый проход отдельно, он сходится до 0,7–1,5 м, и все четыре дают один и тот же масштаб с точностью 0,1 %.
Разница между 1 м и 3 м - это дрейф между проходами внутри модели SfM. Правильно было бы не выравнивать после, а добавить положения по GPS в bundle adjustment как дополнительные невязки.
Самолёт летит со скоростью 20 м/с, поэтому ошибка времени в 0,1 с - это 2 м ошибки положения. Вот почему стоило исправлять часы и искать задержку.
Проход, который собрался зеркально
Подгонка к GPS показала ошибку, которую ошибка репроекции показать не могла. Один высокий проход (18 кадров) после выравнивания оказался на километр выше настоящего трека. При этом ошибка репроекции у него была обычной: 1,3 px.
У далёкой, почти плоской сцены есть два допустимых решения для движения камеры, зеркальных друг другу. Если у прохода мало общих точек с остальной моделью, реконструкция может выбрать неверное, а его точки, которые видит только этот проход, репроецируются идеально. Находит это простой тест: у камеры, наклонённой вниз, низ кадра должен быть ближе верха. В том проходе порядок был перевёрнут в 18 кадрах из 18. Я его выбросил.
Низкая ошибка репроекции говорит, что модель согласована сама с собой. Она не говорит, что модель верна. Это говорят независимые данные: здесь GPS и грубая проверка по высотам SRTM вдоль трека (модель в медиане на 9 м выше, это в пределах собственной ошибки SRTM на таком рельефе).
От облака точек к объёму
- Сетка высот. Облако поворачивается и масштабируется в метры (восток, север, верх), затем в каждой ячейке 2 м берётся медиана высот точек. Измерения есть на 78 % площади модели; пропуски (глубокая тень, склоны без текстуры) интерполированы и помечены.
- Ось. Линия дна каньона - это самый дешёвый путь по сетке, если ценой считать высоту над локальным дном. После сглаживания она задаёт каждой плотине положение и направление: всегда поперёк каньона.
- Объём. Вода - это все ячейки ниже уровня, связанные с дном между двумя плотинами. Это заливка, поэтому боковая долина за хребтом остаётся сухой. Тогда .
Если вода доходит до края модели, лаборатория сообщает об этом и не показывает число.
Насколько можно верить числу
- Масштаб верен примерно до 0,2 %, то есть около 0,6 % по объёму.
- Форма даёт ошибку больше: 3 м дрейфа между проходами и сетка 2 м по видео, где на землю приходится примерно 0,5 м на пиксель.
- Деревья. Это модель поверхности. Там, где дно заросло лесом, «землёй» считаются кроны, и настоящий объём немного больше.
- Дыры. Лаборатория показывает, какая доля воды лежит над интерполированным рельефом. Держите её маленькой.
Для настоящей съёмки нужно летать по сетке с камерой вниз, добавить опорные точки на земле или RTK и включить GPS в bundle adjustment. Для пенопластового самолёта в выходной водохранилище в 1,5 млн м³, измеренное с точностью до нескольких процентов, - неплохой результат.
Где ещё это применяется
Водохранилище в каньоне - игрушечный вопрос, но та же цепочка (позы, плотная поверхность, метры, разность поверхностей) - это повседневная работа в съёмке местности:
- Склады сыпучих материалов. Сколько песка, гравия или грунта лежит в куче, с измерением каждую неделю.
- Карьеры и шахты. Сколько породы вынули за месяц: две съёмки, одно вычитание.
- Стройка. Фактическая поверхность против проектной модели показывает, где срезать и где подсыпать.
- Оползни и наводнения. Модели до и после дают объём завалов, который нужно убрать.
- Лес. Поверхность минус голая земля - это модель высоты крон: высота деревьев и запас древесины.
- Берега морей и рек. Сколько грунта потеряно между двумя датами.
- Места, куда дрон не долетит. Та же геометрия по спутниковым снимкам покрывает большие площади, закрытые зоны и районы бедствий.
- Обход объекта. Снимки 360°-камеры, встроенные в модель с дрона.
Во всех этих задачах 3D-реконструкция - только полдела. Вторая половина - погрешности: найти их источники и показать, сколько каждый вносит в итоговое число. Это отдельная и непростая задача.