Шпаргалка по NumPy
Все примеры из шпаргалки DataCamp по NumPy, запущенные в NumPy 2.4. У каждого есть код и картинка. Картинки рисуются запуском того же кода, поэтому показывают то, что NumPy действительно возвращает.
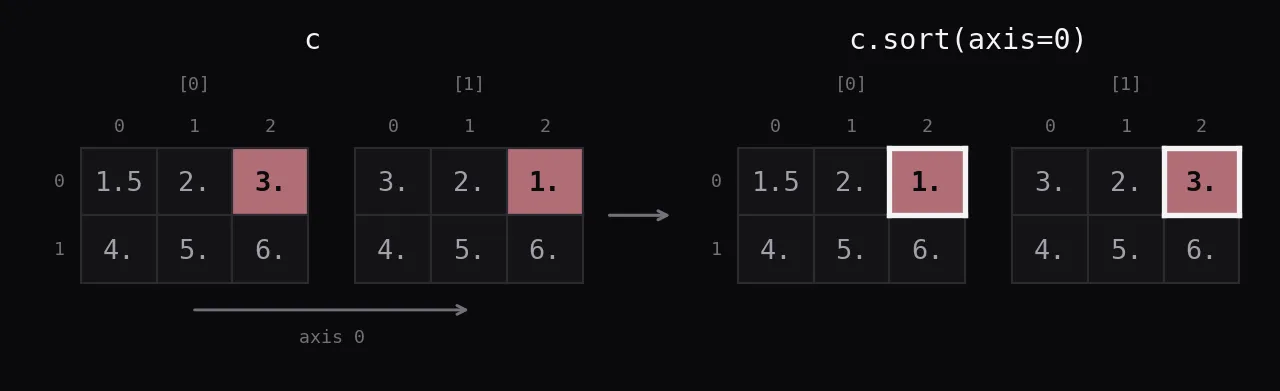
Как читать картинки: закрашенная ячейка - та, которую операция выбирает, читает или выдаёт. Толстая рамка отмечает ячейки, которые шаг только что записал. Пунктирные бледные ячейки - значения, которые NumPy повторяет при broadcasting. Маленькие числа в углу ячейки показывают порядок элементов. Серые числа по краям - индексы, от нуля.
Где исходная шпаргалка в NumPy 2 падает или ошибается, пример исправлен, а в тексте сказано, что изменилось. Примеры используют эти массивы:
import numpy as np

a = np.array([1, 2, 3])
b = np.array([(1.5, 2, 3), (4, 5, 6)], dtype=float)
c = np.array([[(1.5, 2, 3), (4, 5, 6)], [(3, 2, 1), (4, 5, 6)]], dtype=float)
d = np.arange(10, 25, 5)
e = np.full((2, 2), 7)
f = np.eye(2)
g = a - b
Создание массивов
1D, 2D, 3D
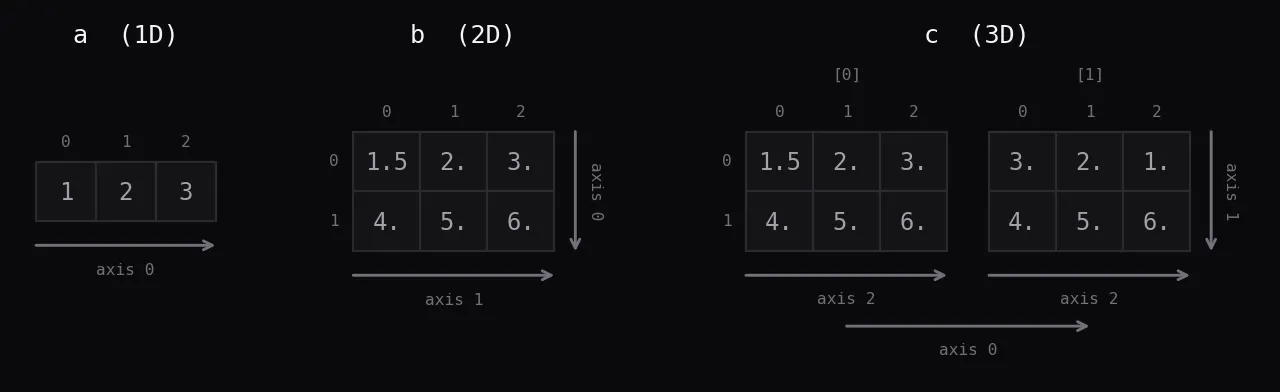
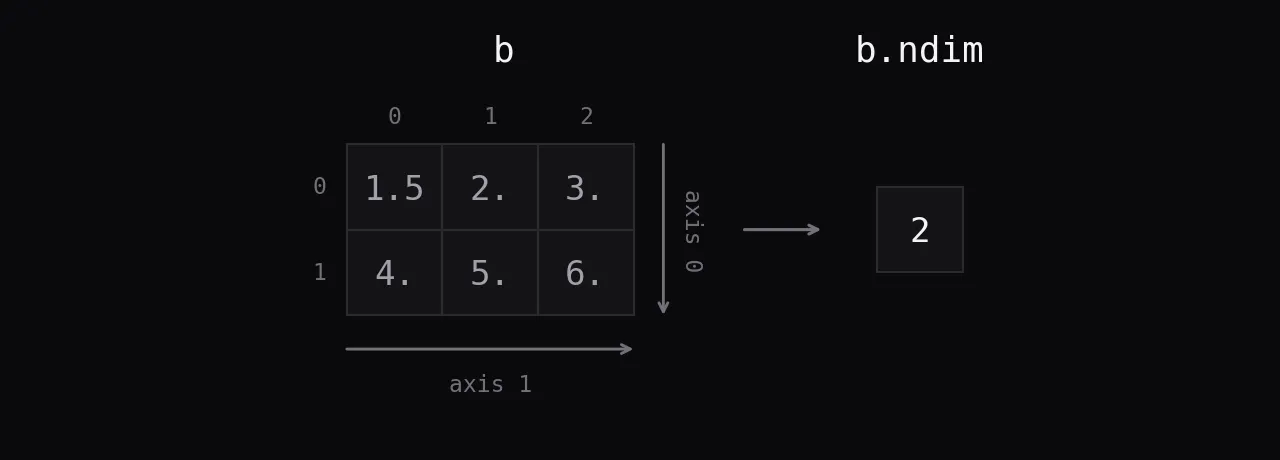
Оси нумеруются снаружи внутрь, ось 0 - это первый индекс. В 2D-массиве ось 0 идёт по строкам, в 3D-массиве - по блокам.
a = np.array([1, 2, 3])
b = np.array([(1.5, 2, 3), (4, 5, 6)], dtype=float)
c = np.array([[(1.5, 2, 3), (4, 5, 6)], [(3, 2, 1), (4, 5, 6)]], dtype=float)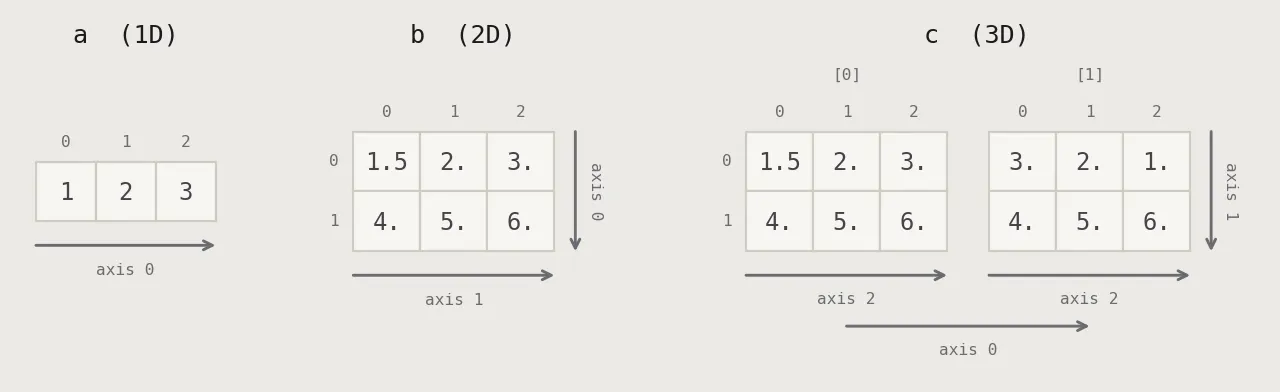
Заготовки
np.zeros
Новый массив заданной формы, заполненный нулями. Тип по умолчанию float64, поэтому 0..
np.zeros((3, 4))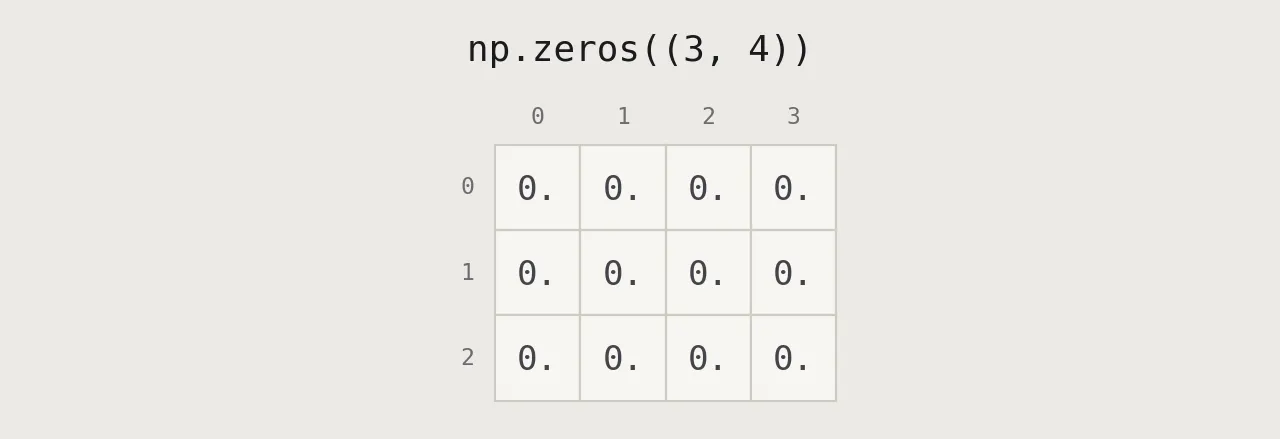
np.ones
Единицы, здесь 16-битные целые. Форма (2, 3, 4) - это 2 блока по 3 строки и 4 столбца.
np.ones((2, 3, 4), dtype=np.int16)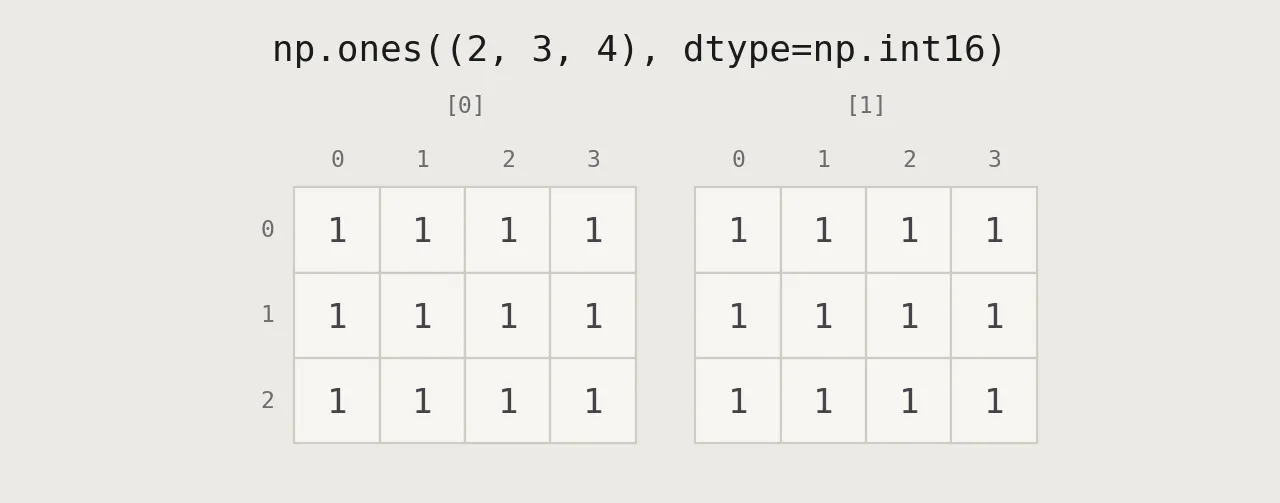
np.arange
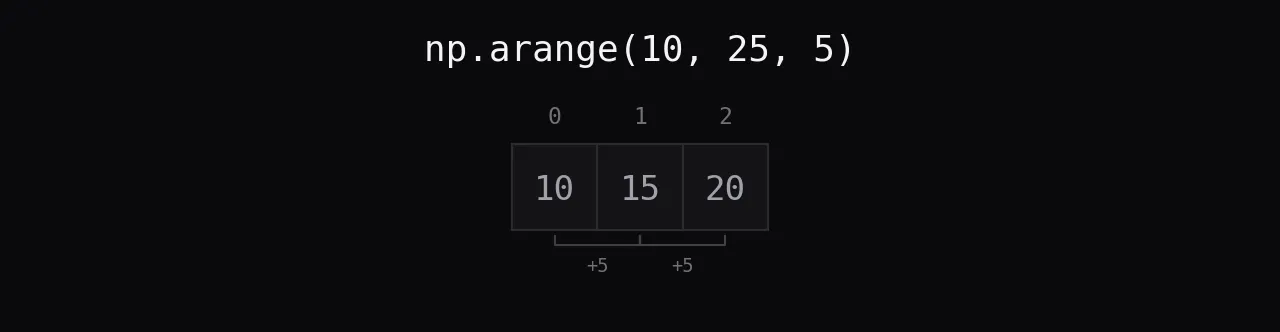
Значения от start до stop с фиксированным шагом. Сам stop не входит, поэтому 25 в результате нет.
d = np.arange(10, 25, 5)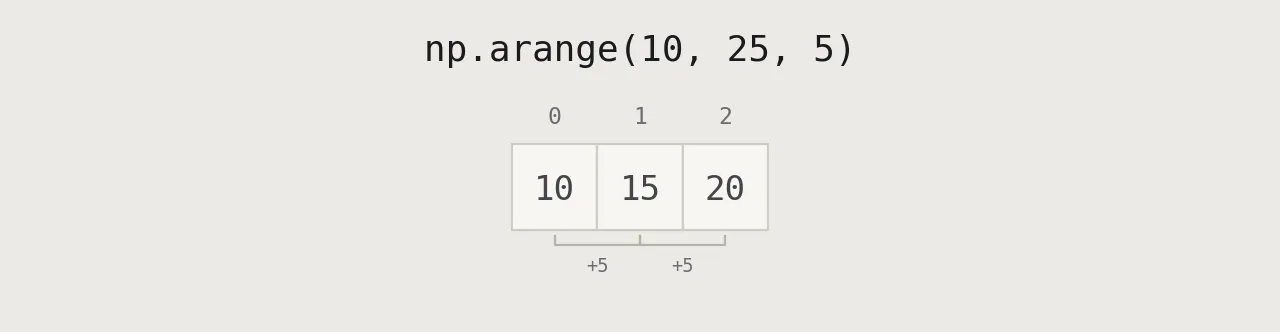
np.linspace
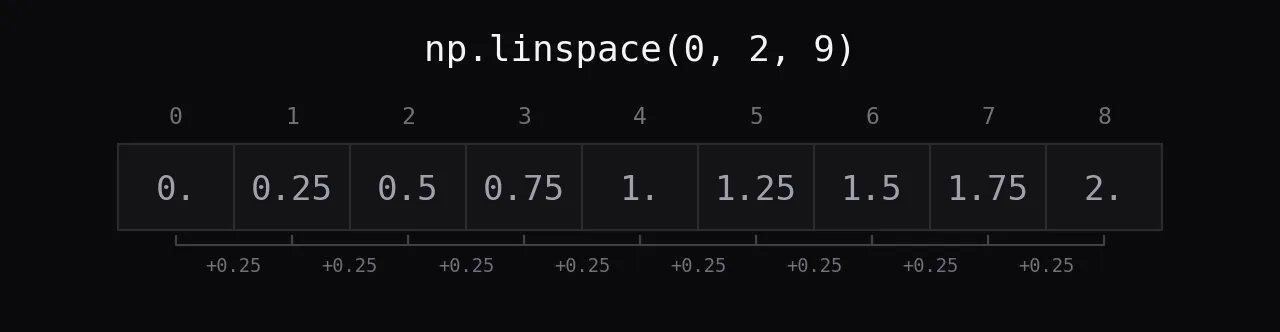
Заданное число равномерно расставленных значений, оба конца включены. 9 точек от 0 до 2 дают шаг 0.25.
np.linspace(0, 2, 9)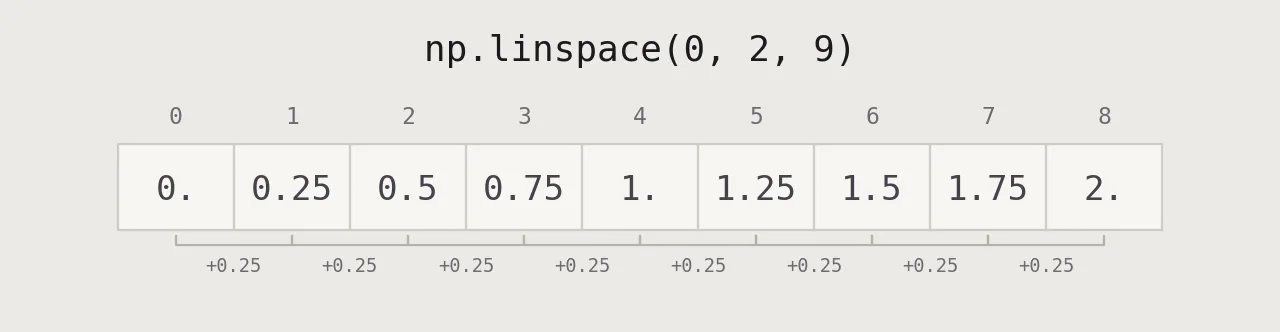
np.full
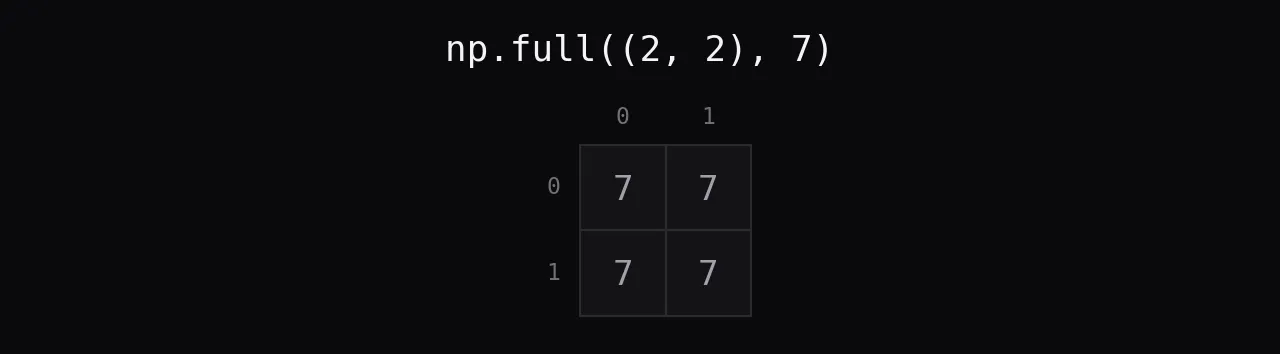
Любая форма, заполненная одной константой.
e = np.full((2, 2), 7)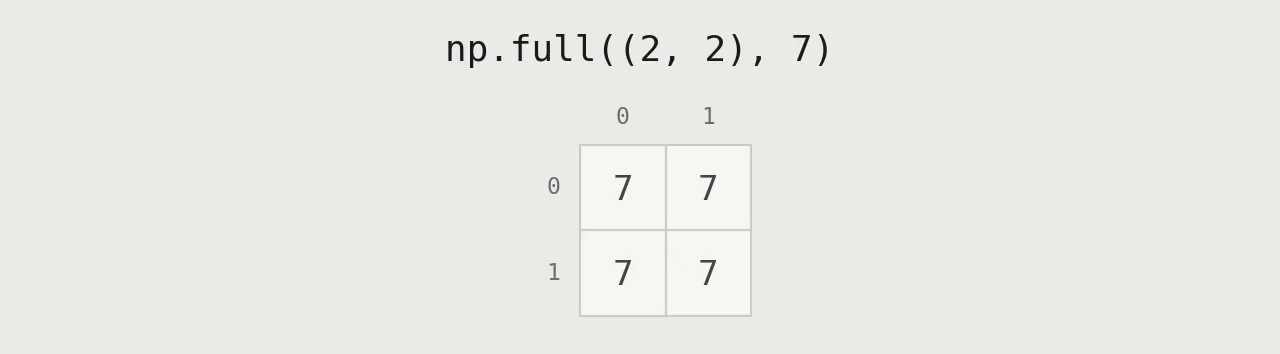
np.eye
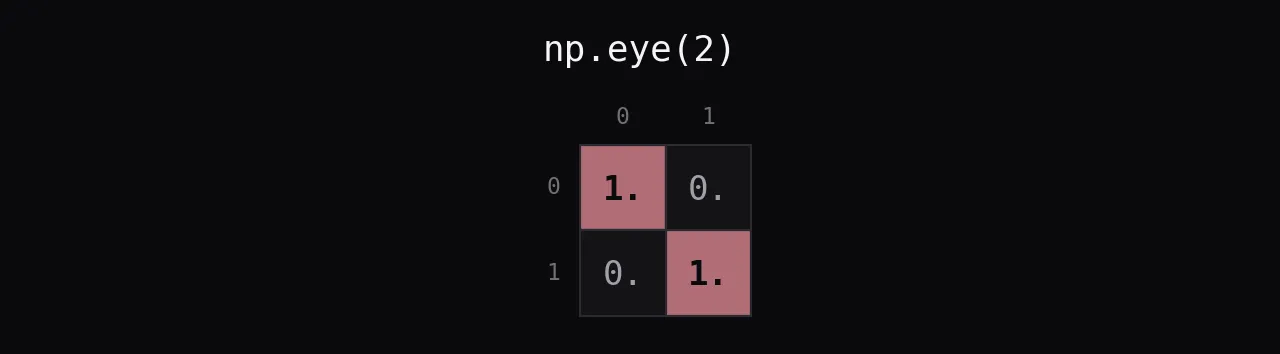
Единичная матрица: единицы на диагонали, нули в остальных местах.
f = np.eye(2)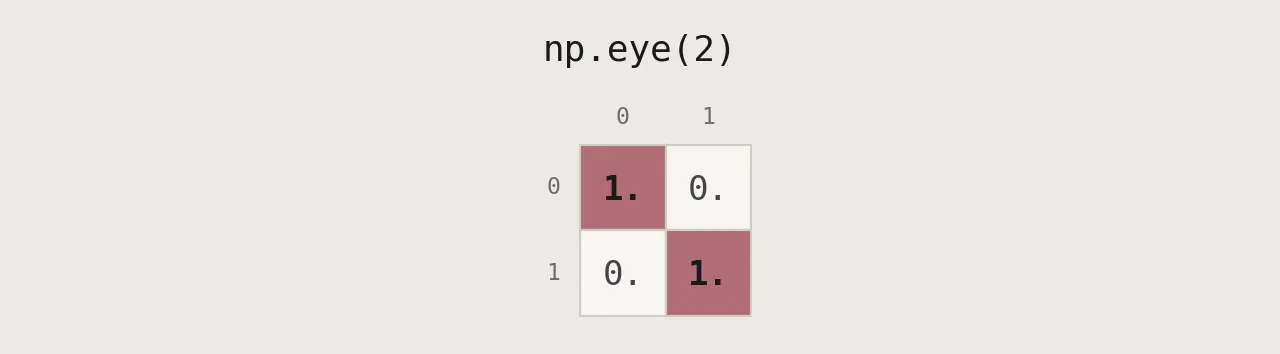
np.random.random
Равномерно распределённые случайные числа от 0 (включительно) до 1 (не включая). В новом коде обычно пишут np.random.default_rng().random((2, 2)).
np.random.random((2, 2))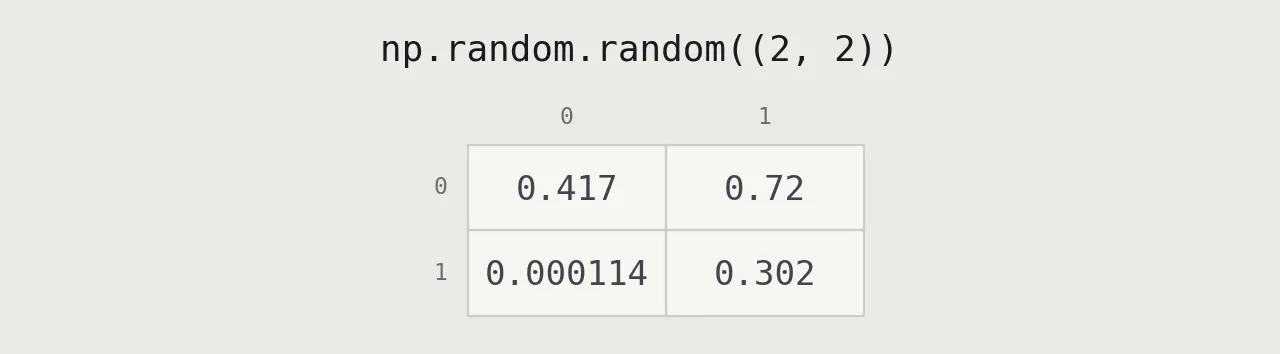
np.empty
Выделяет память, но не инициализирует её. В ячейках лежит то, что было в памяти раньше, поэтому массив нужно заполнить до чтения.
np.empty((3, 2))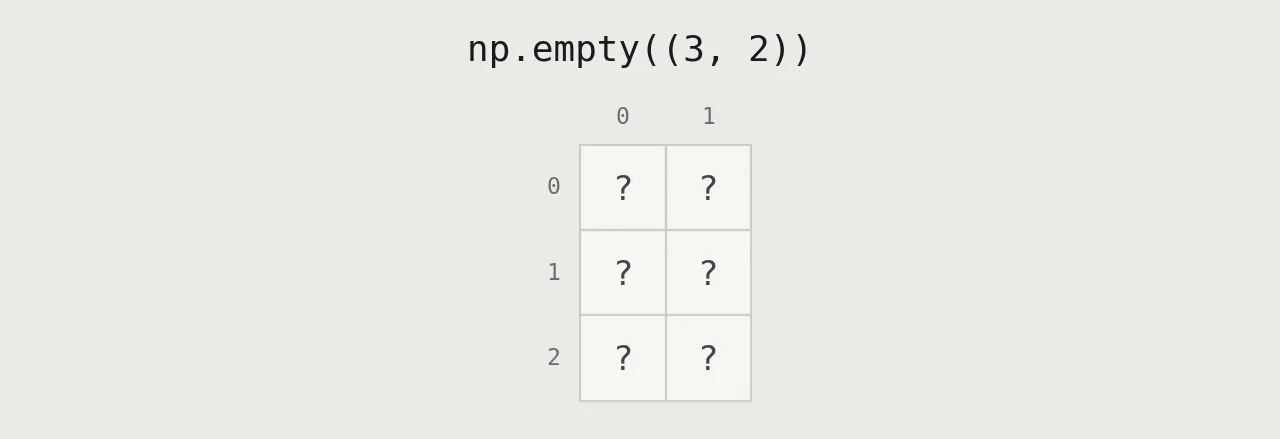
Ввод-вывод
np.save, np.load
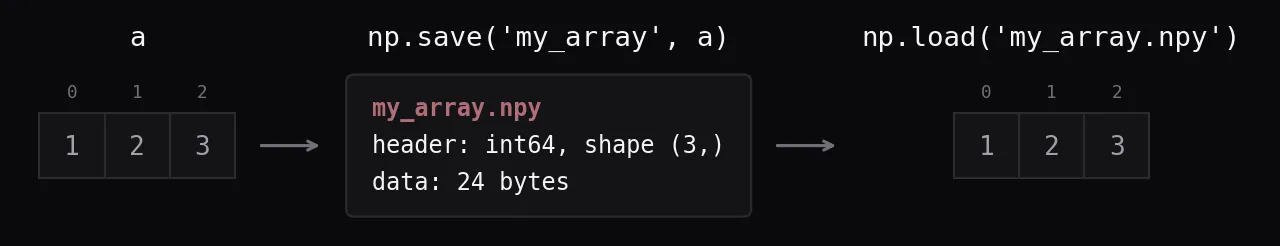
np.save записывает один массив в бинарном формате NumPy .npy и сам добавляет расширение. В файле небольшой заголовок с типом и формой, затем сырые байты: 3 значения int64 занимают 24 байта.
np.save('my_array', a)
np.load('my_array.npy')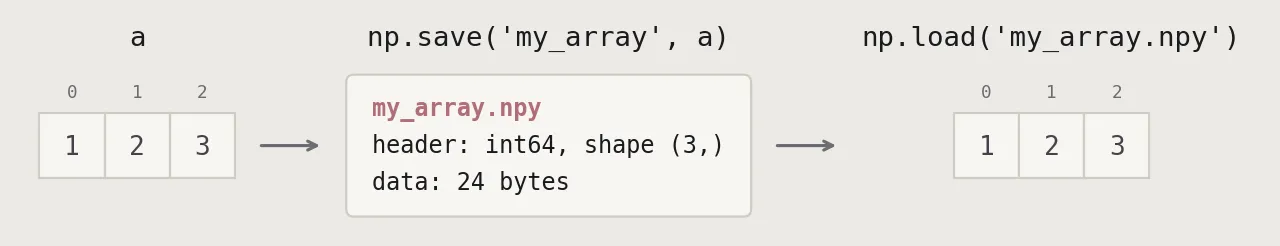
np.savez
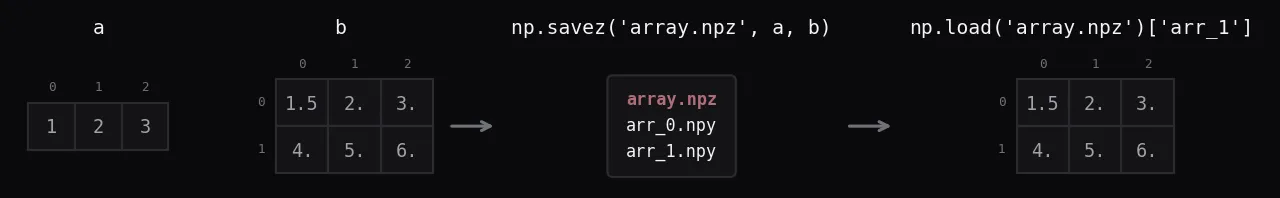
Несколько массивов в одном несжатом архиве .npz. Массивы, переданные по позиции, получают имена arr_0, arr_1 и так далее; чтобы задать имена, передайте их ключами: np.savez('array.npz', a=a, b=b). Сжатый архив делает np.savez_compressed.
np.savez('array.npz', a, b)
np.load('array.npz')['arr_1']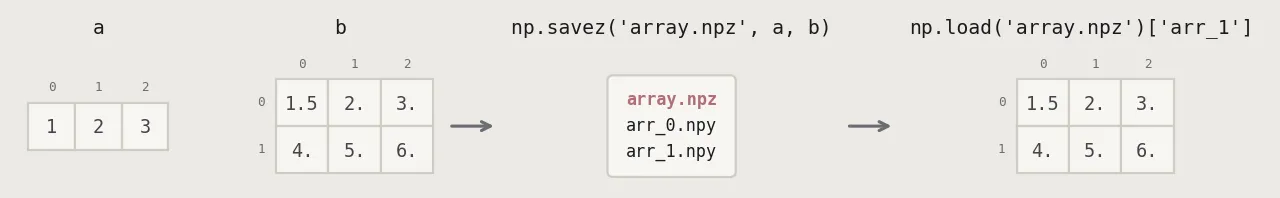
np.savetxt, np.loadtxt
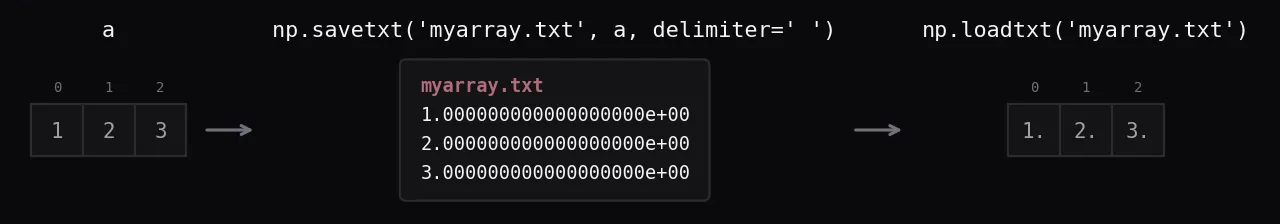
Обычный текст, одна строка массива на строку файла. Формат по умолчанию %.18e, поэтому каждое число пишется как float, и loadtxt читает обратно float. Для целых передайте fmt='%d'.
np.savetxt('myarray.txt', a, delimiter=' ')
np.loadtxt('myarray.txt')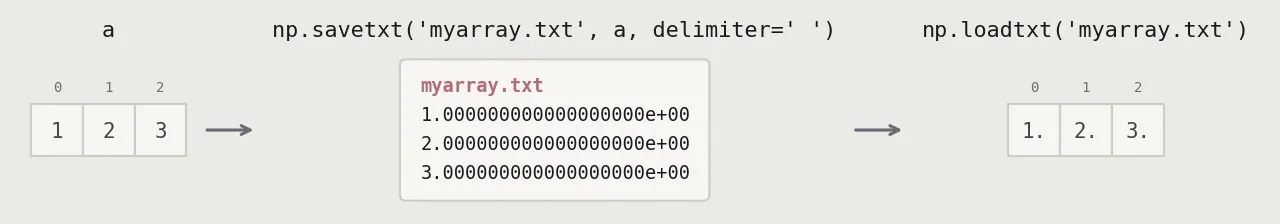
np.genfromtxt
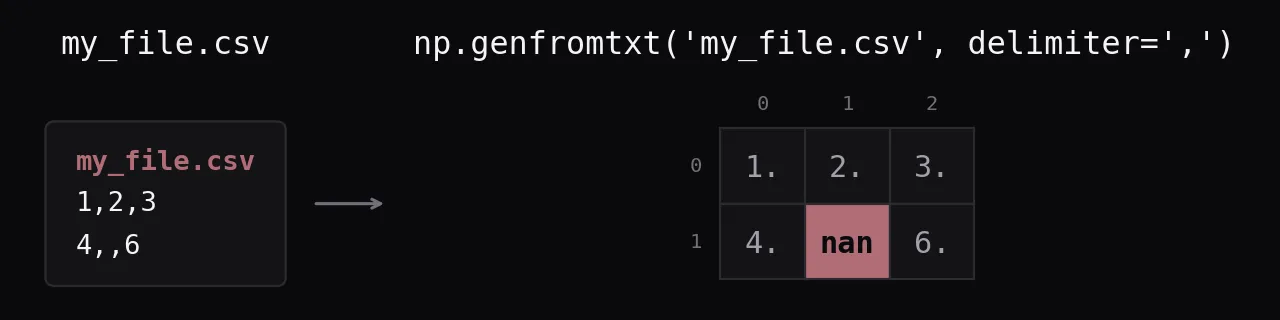
Как loadtxt, но справляется с пропусками: пустое поле становится nan.
np.genfromtxt('my_file.csv', delimiter=',')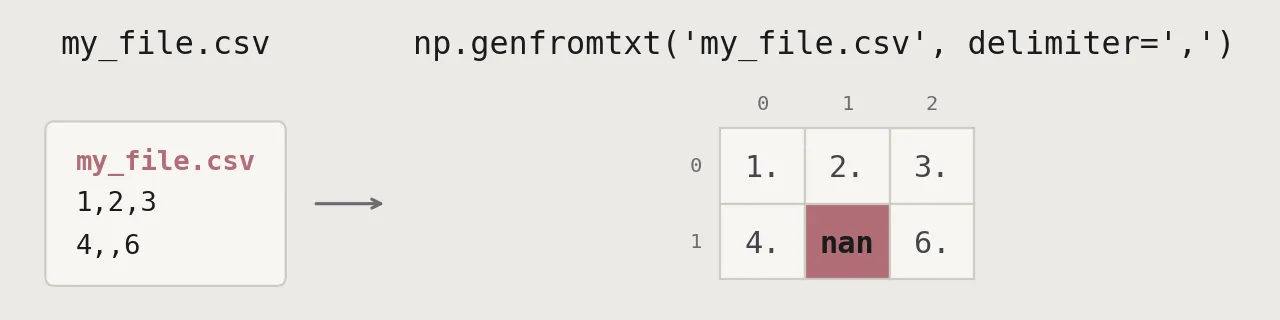
Типы данных
dtypes
Тип задаёт, сколько байт занимает один элемент. Несколько имён из исходной шпаргалки в NumPy 2 удалены. np.complex, np.object, np.string_ и np.unicode_ теперь называются np.complex128, np.object_, np.bytes_ и np.str_. Ещё шпаргалка называет float32 двойной точностью, но это одинарная точность; двойная - float64. Массив object хранит 8-байтовые указатели, а unicode-строка занимает 4 байта на символ.
np.int64       # signed 64-bit integer
np.float32     # single-precision float
np.complex128  # complex number, two float64
np.bool        # True / False
np.object_     # any Python object
np.bytes_      # fixed-length byte string, e.g. 'S5'
np.str_        # fixed-length unicode string, e.g. 'U5'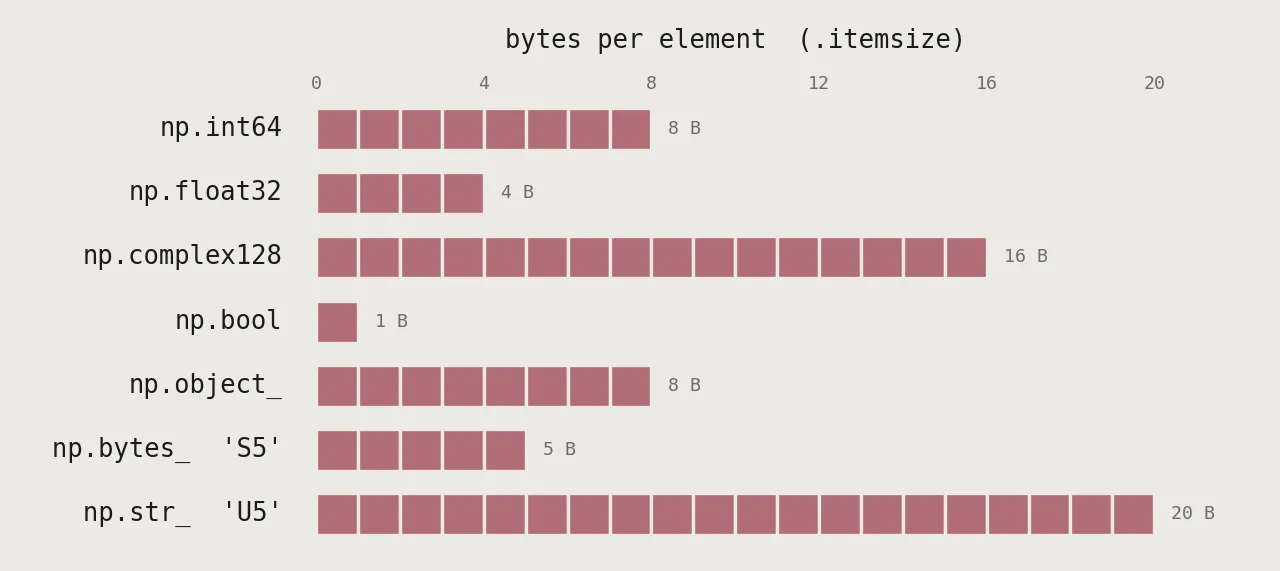
Свойства массива
a.shape
Размер по каждой оси в виде кортежа. У 1D-массива это кортеж из одного элемента.
a.shape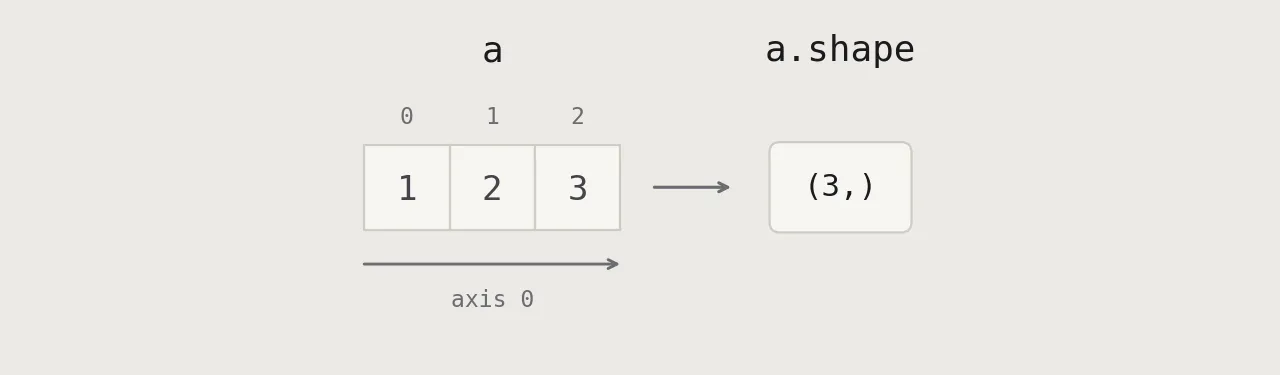
len
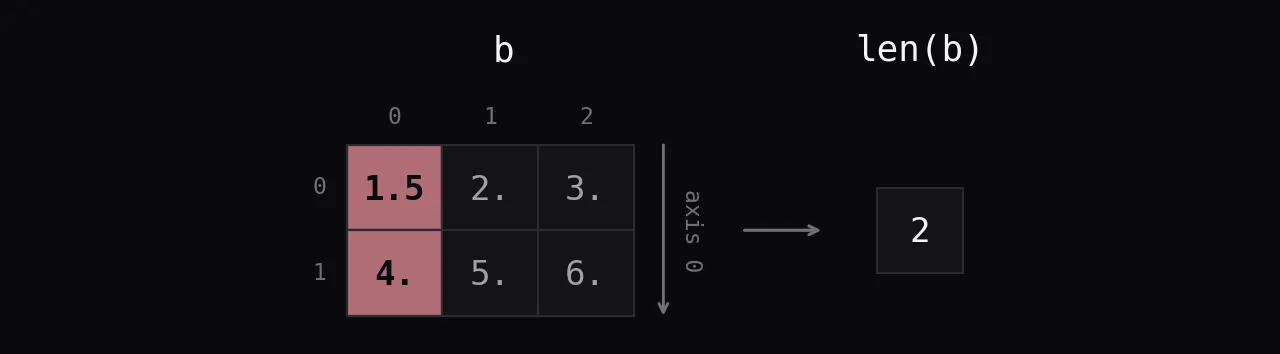
len считает только первую ось, поэтому у 2D-массива это число строк, а не число элементов.
len(b) # len(a) is 3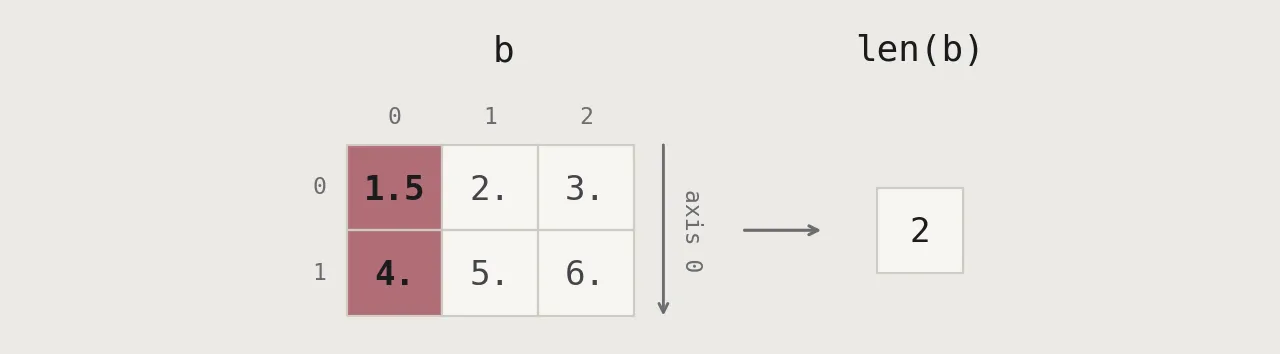
b.ndim
Число осей.
b.ndim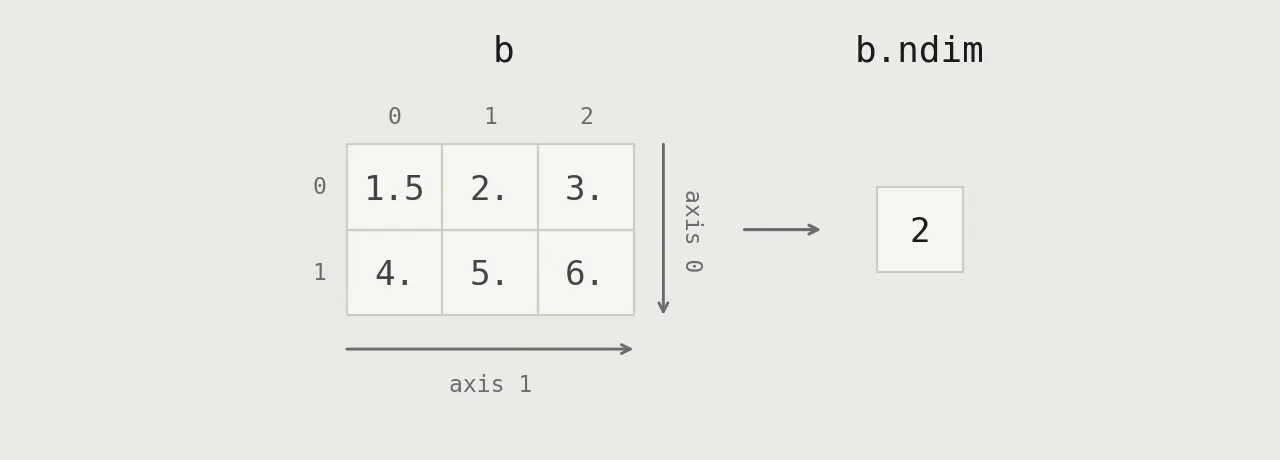
e.size
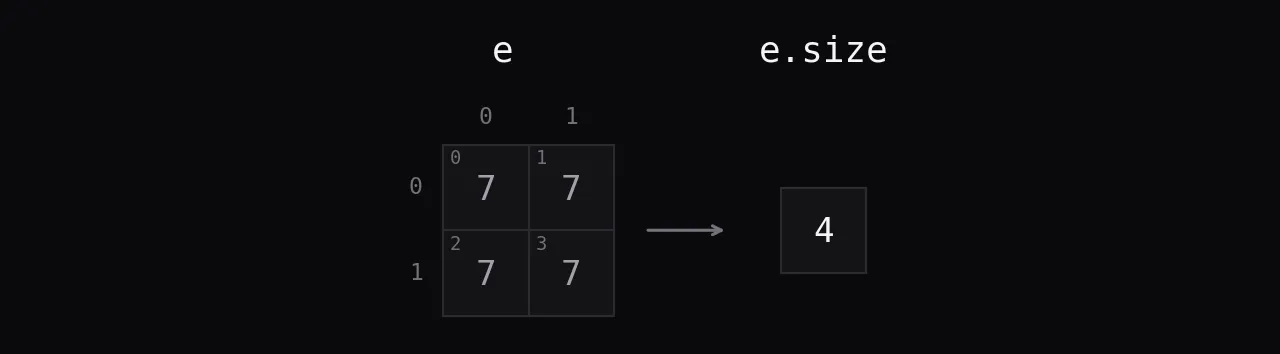
Общее число элементов, произведение размеров формы.
e.size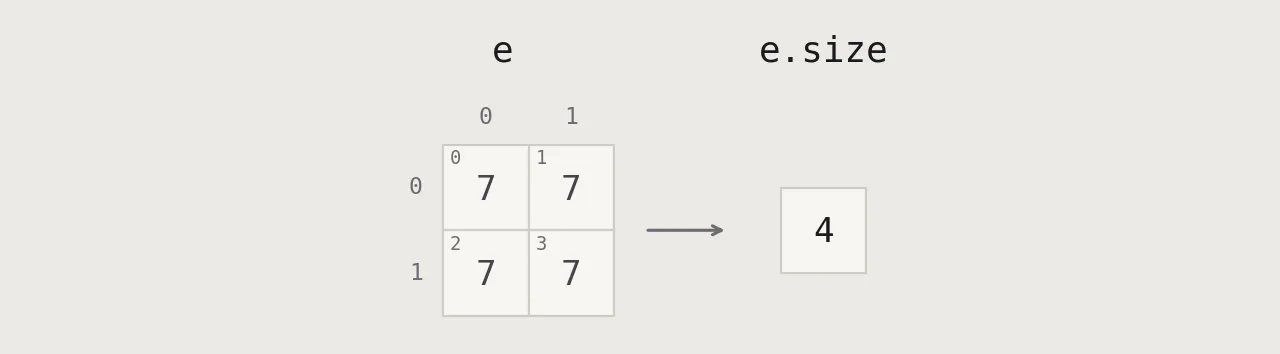
b.dtype
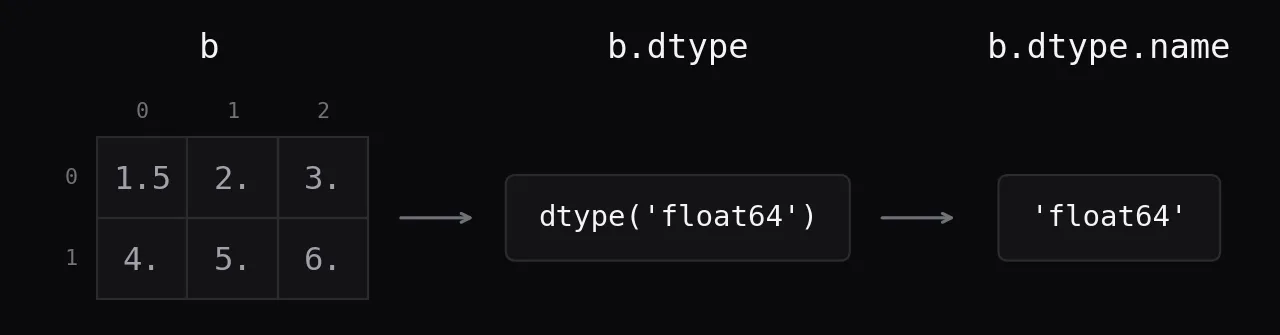
Тип элементов: как объект dtype и как его имя.
b.dtype
b.dtype.name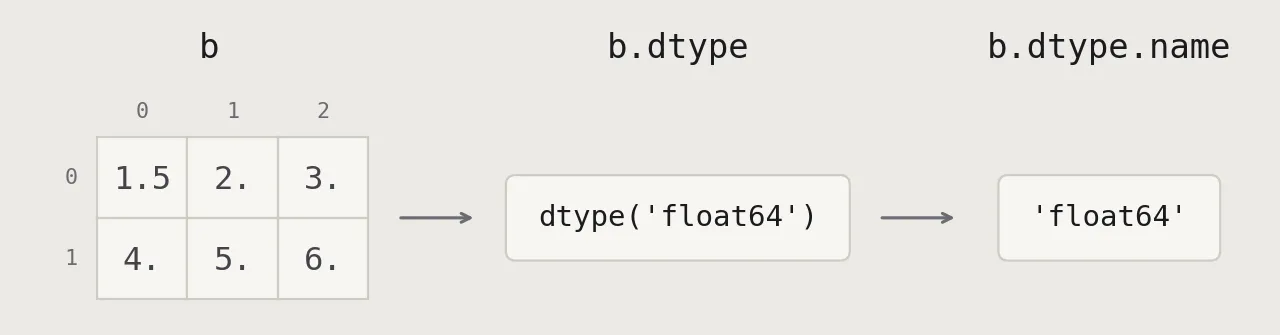
b.astype
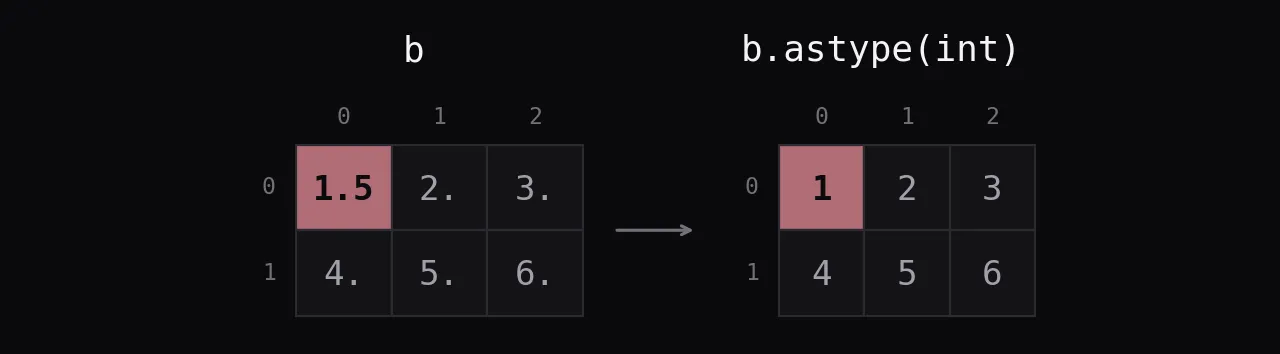
Приводит к другому типу и возвращает копию. Из float в int дробная часть отбрасывается, поэтому 1.5 становится 1.
b.astype(int)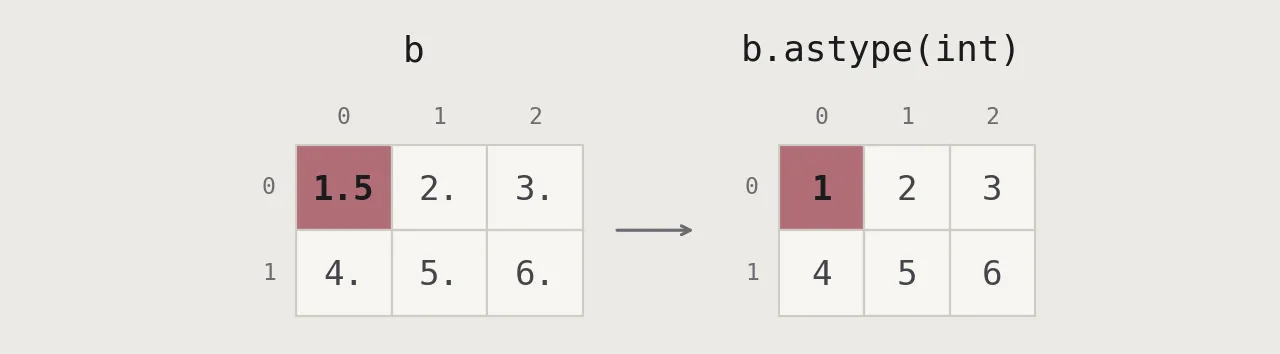
Справка
np.info
Печатает документацию любого объекта NumPy. help() тоже работает.
np.info(np.ndarray.dtype)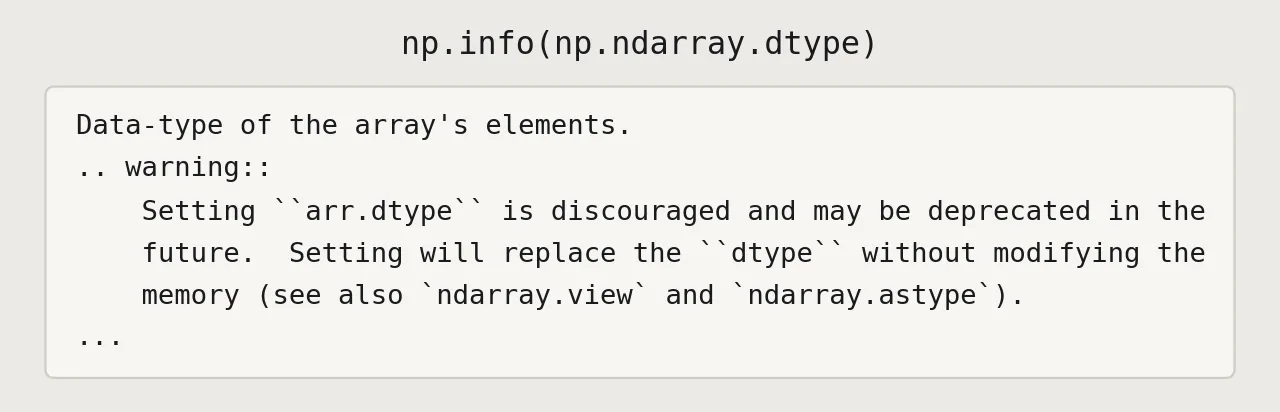
Арифметика
a - b
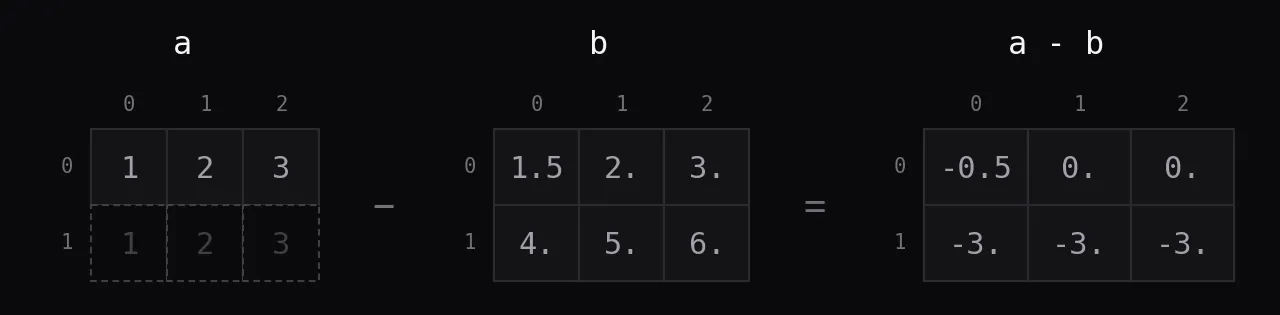
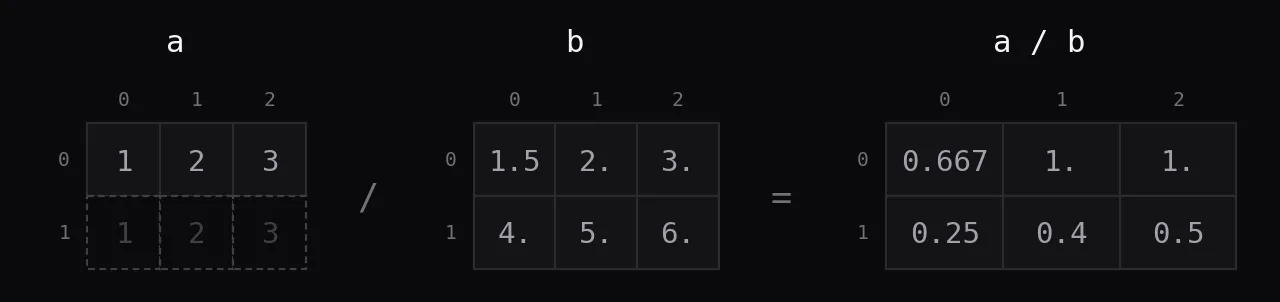
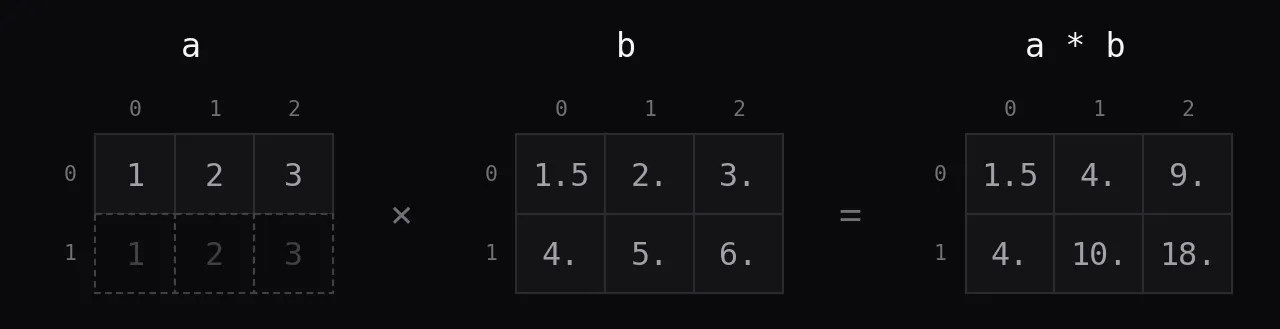
Поэлементно. У a форма (3,), у b - (2, 3), поэтому NumPy растягивает a на каждую строку b (пунктирная строка). Функция делает то же самое.
g = a - b
np.subtract(a, b)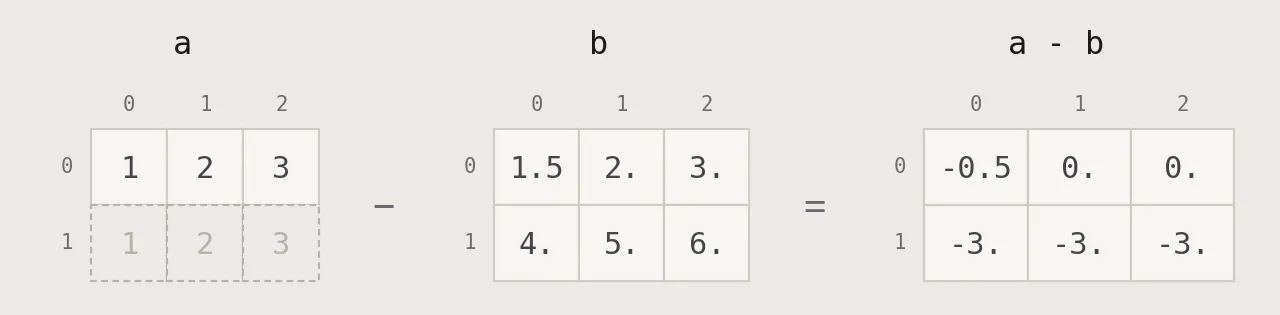
b + a
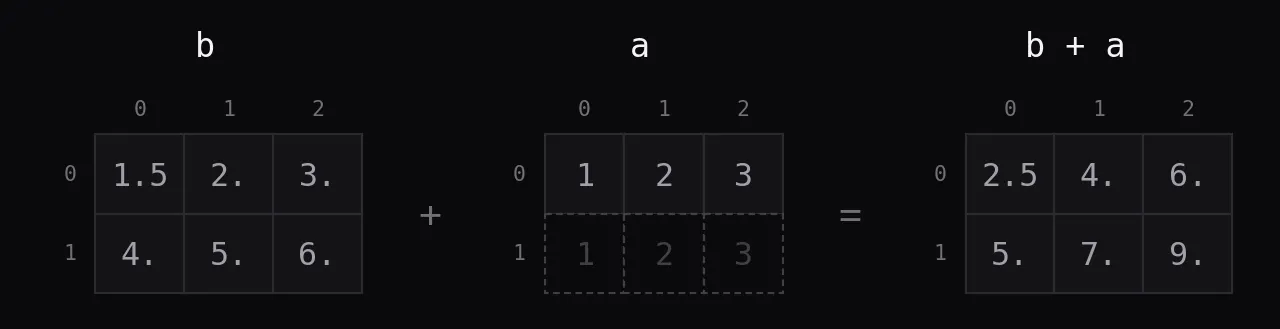
Сложение, broadcasting тот же. Для broadcasting порядок операндов не важен.
b + a
np.add(b, a)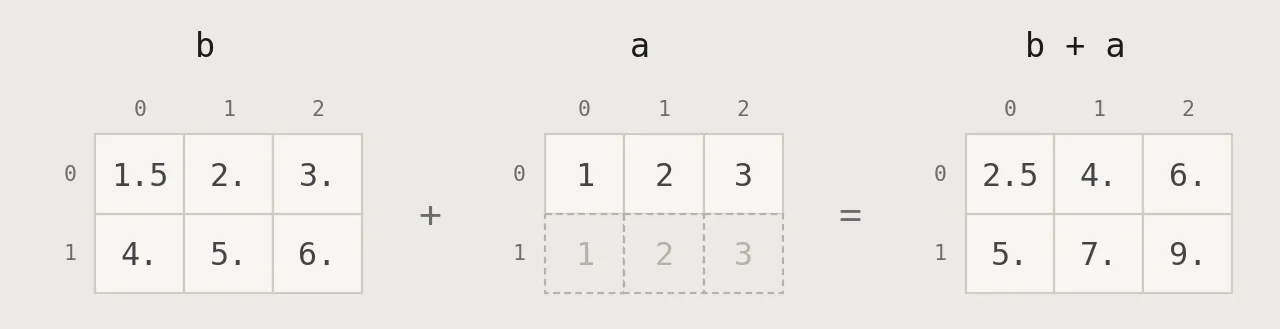
a / b
/ всегда возвращает float, даже для двух целочисленных массивов. Целочисленное деление - //.
a / b
np.divide(a, b)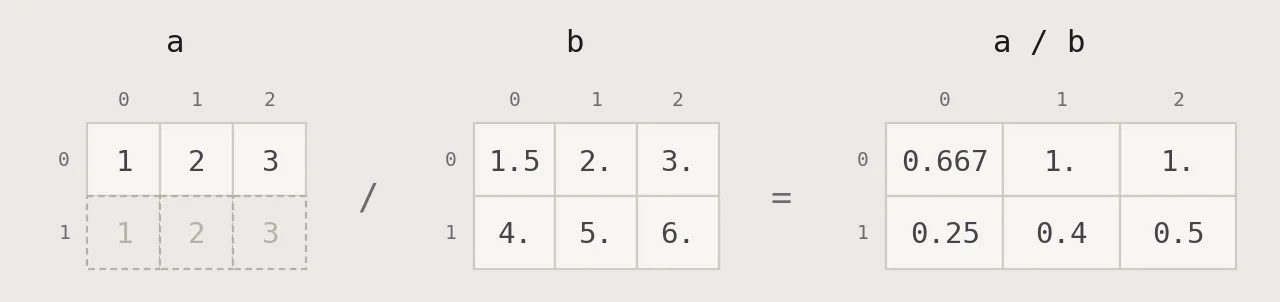
a * b
* умножает поэлементно. Это не матричное произведение, оно делается через dot или @, ниже.
a * b
np.multiply(a, b)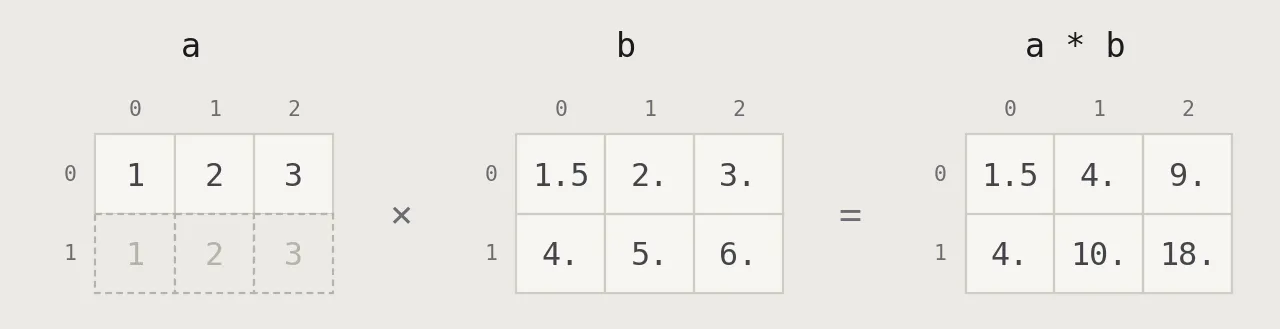
np.exp
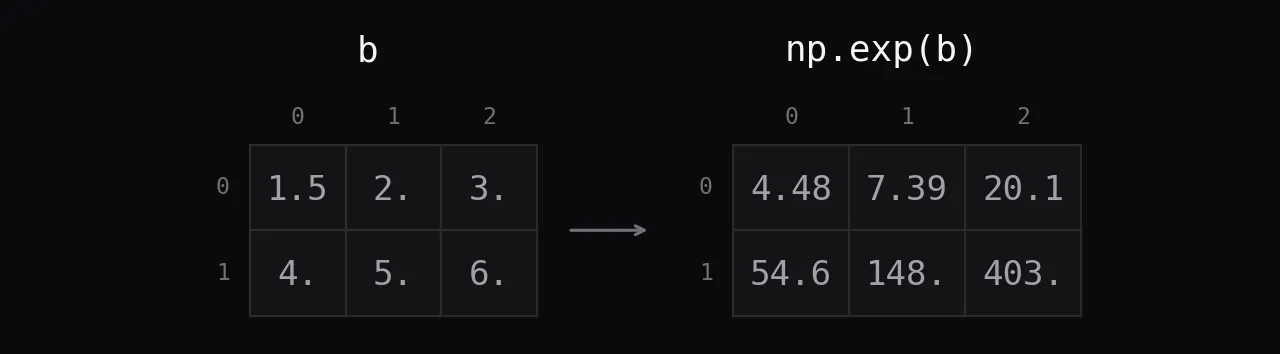
Поэлементные математические функции сохраняют форму. Здесь e в степени каждого элемента.
np.exp(b)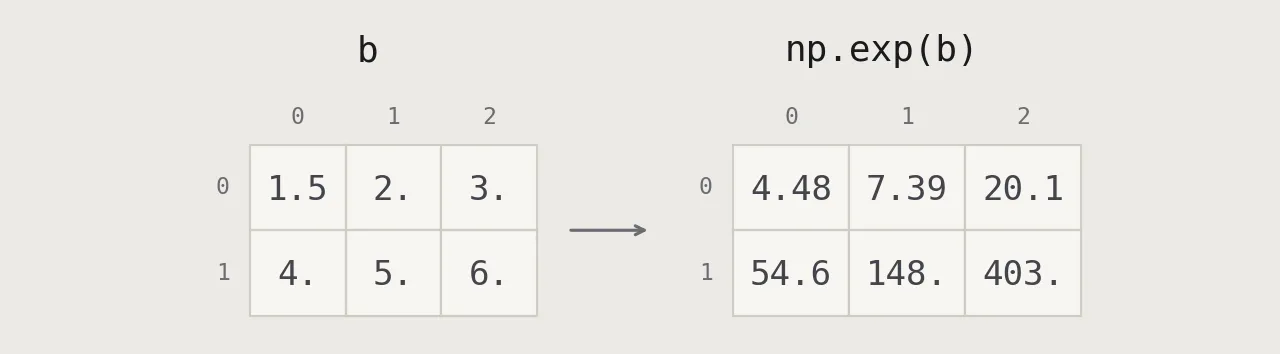
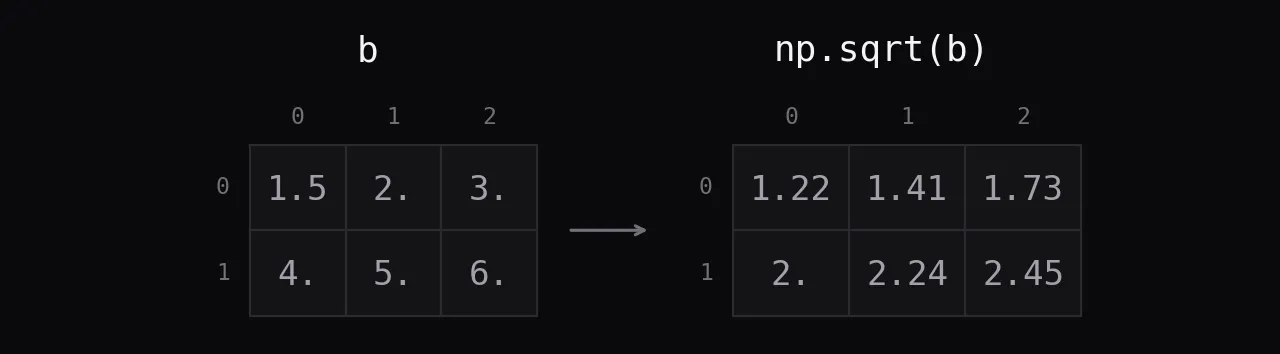
np.sqrt
Квадратный корень каждого элемента.
np.sqrt(b)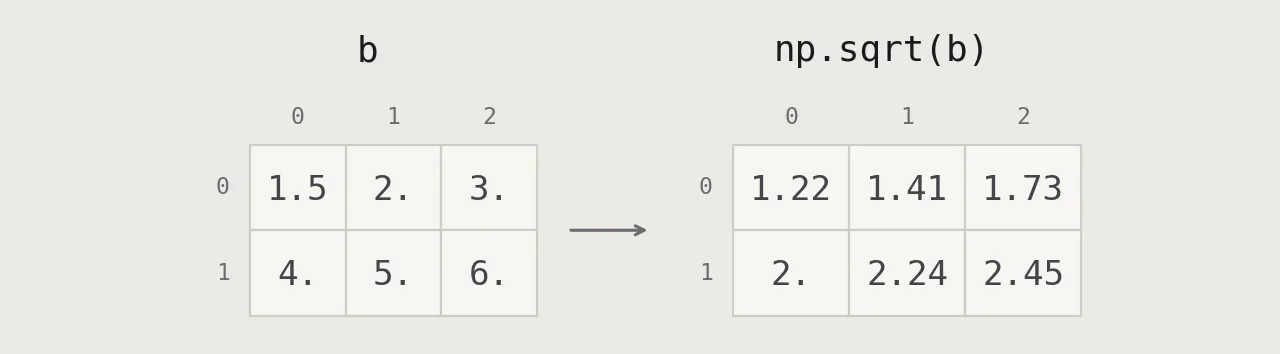
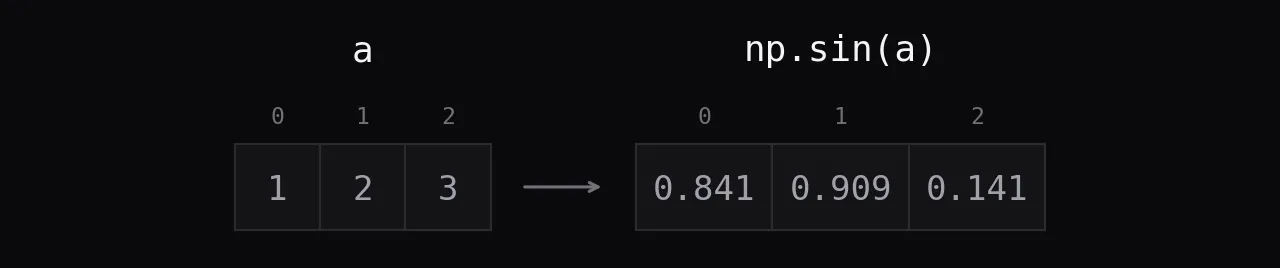
np.sin
Синус каждого элемента, в радианах.
np.sin(a)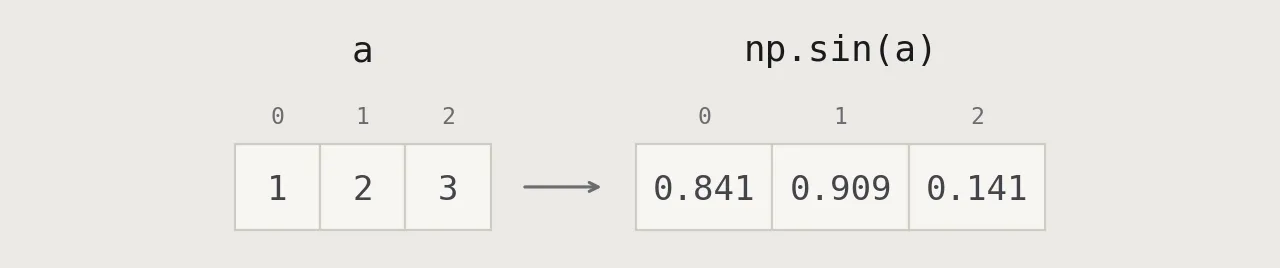
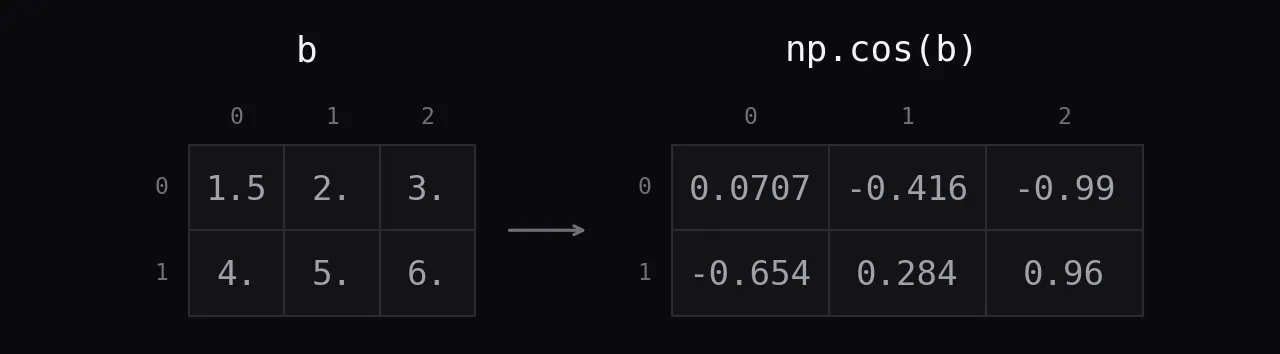
np.cos
Косинус каждого элемента, в радианах.
np.cos(b)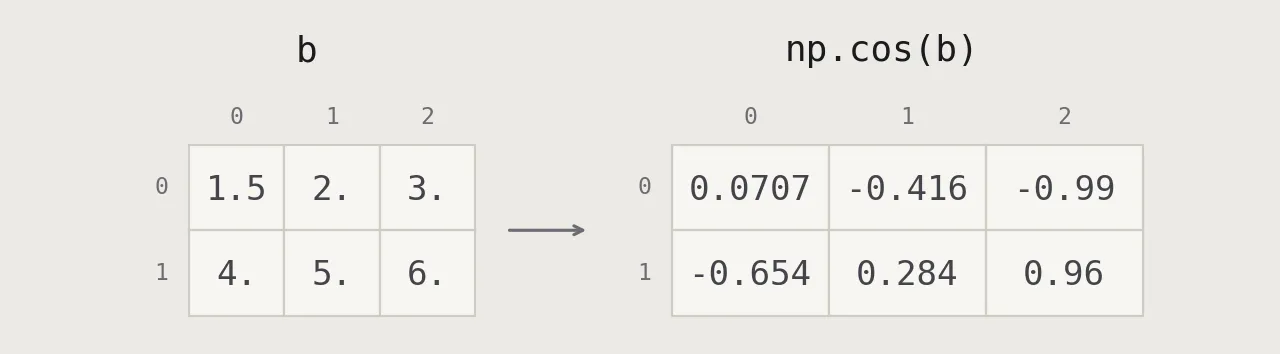
np.log
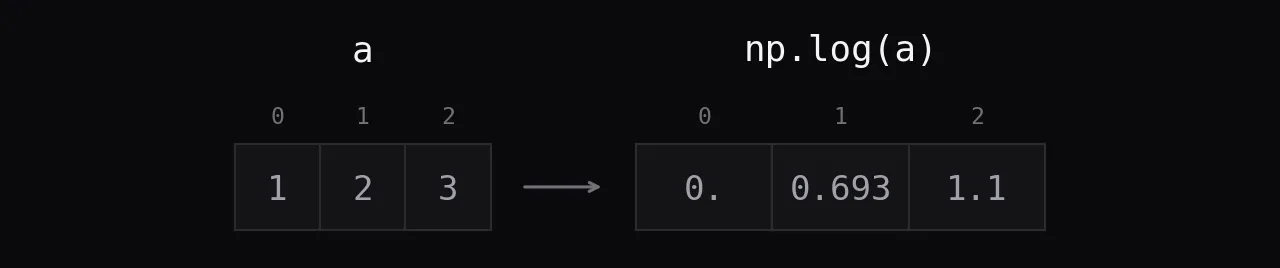
Натуральный логарифм каждого элемента: log(1) равен 0. Другие основания - np.log10 и np.log2.
np.log(a)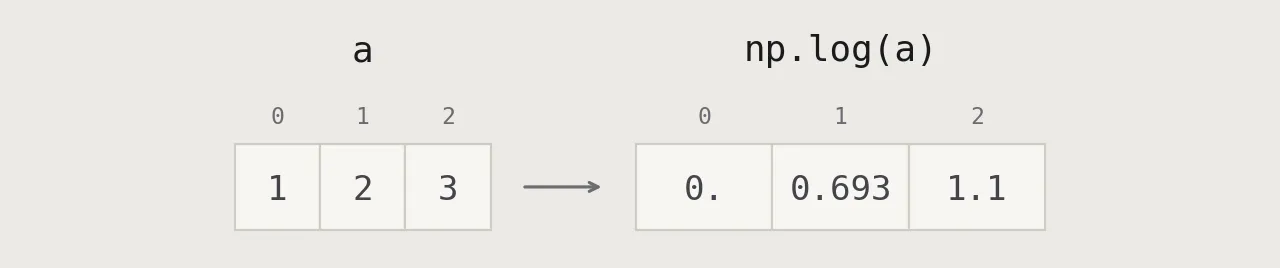
e.dot(f)
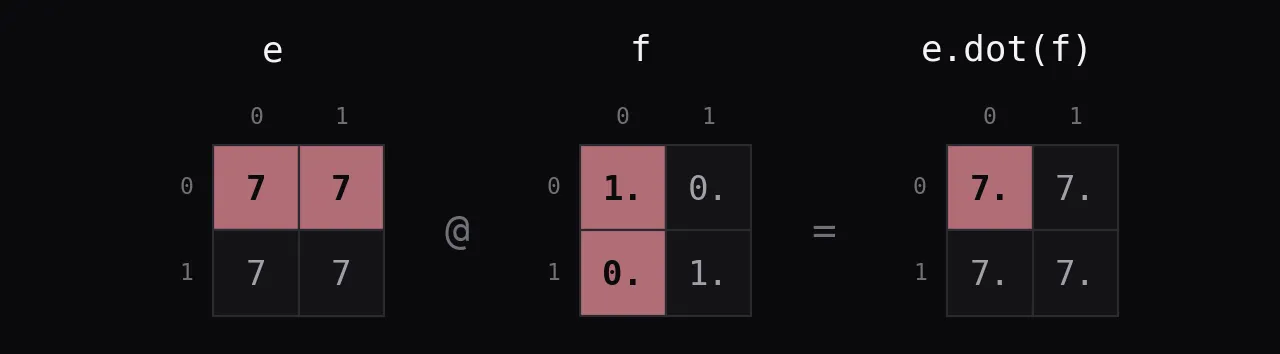
Матричное произведение: каждая ячейка результата - строка e, умноженная на столбец f и просуммированная. f - единичная матрица, поэтому результат равен e.
e.dot(f)
e @ f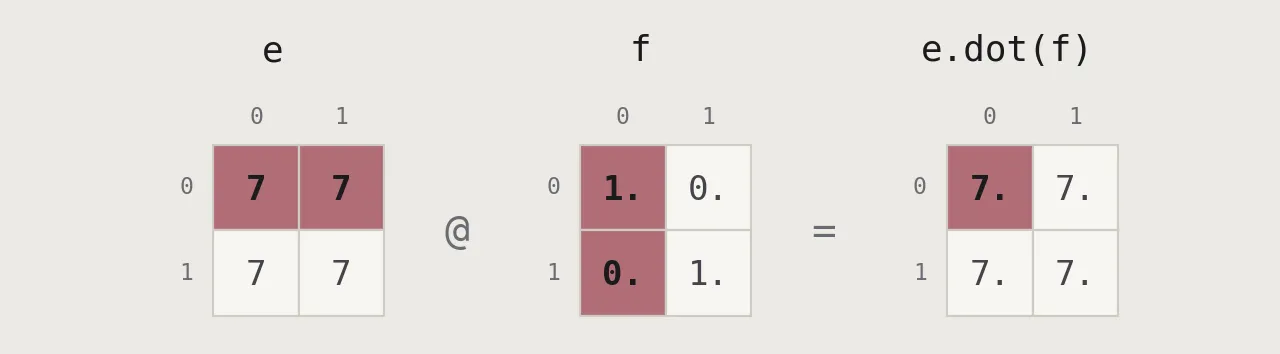
Сравнение
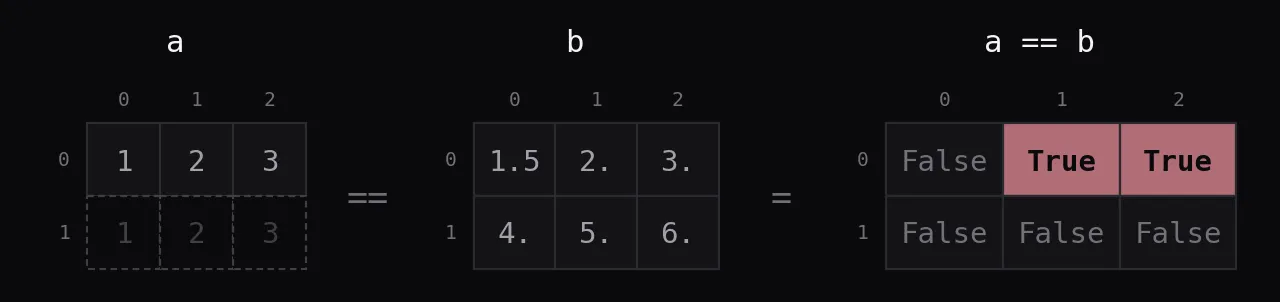
a == b
Поэлементное сравнение даёт массив bool и растягивается так же, как арифметика.
a == b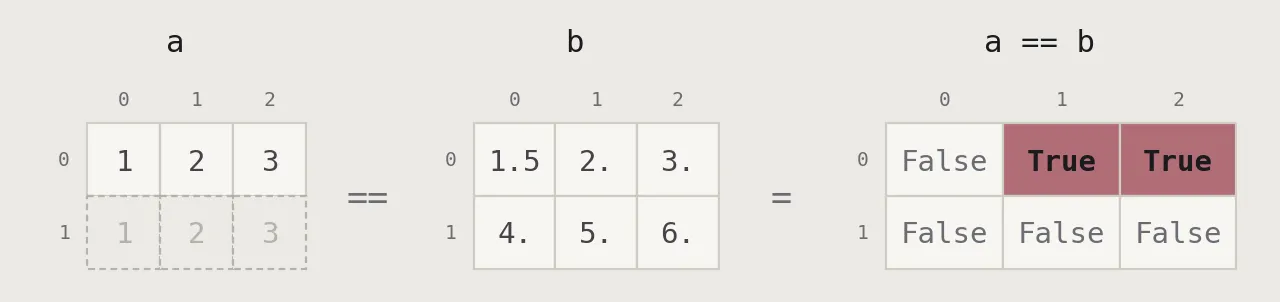
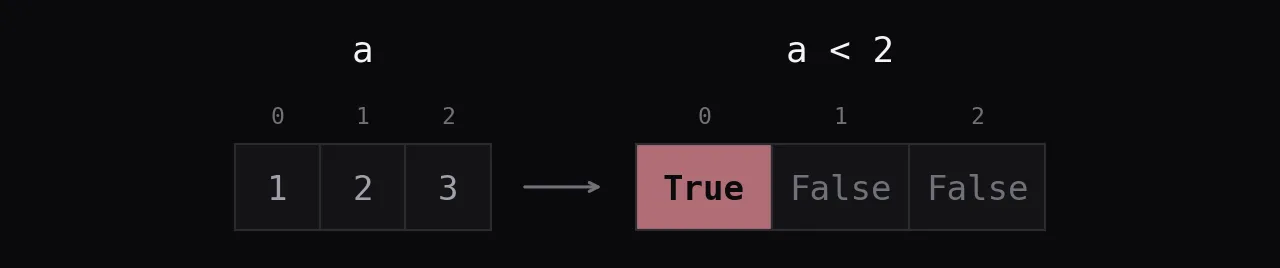
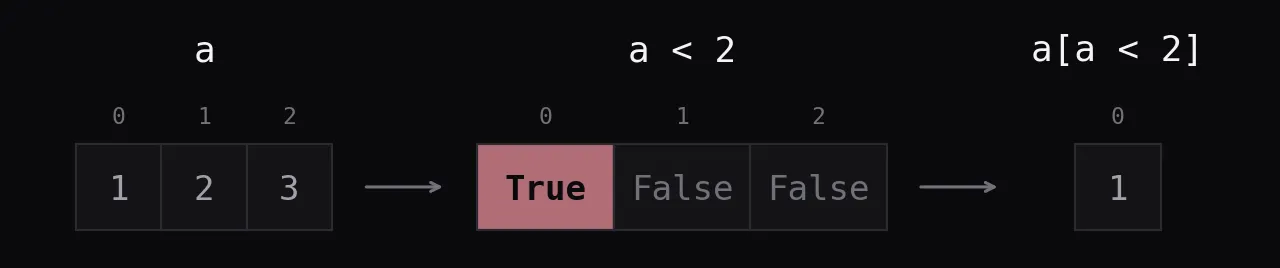
a < 2
Сравнение с числом сравнивает с ним каждый элемент.
a < 2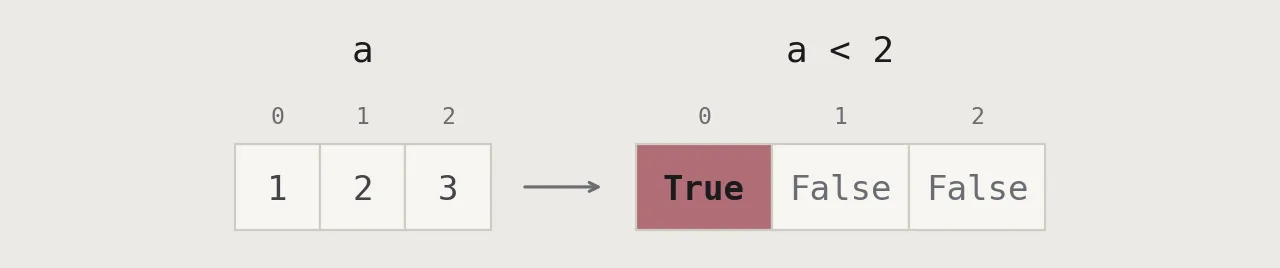
np.array_equal
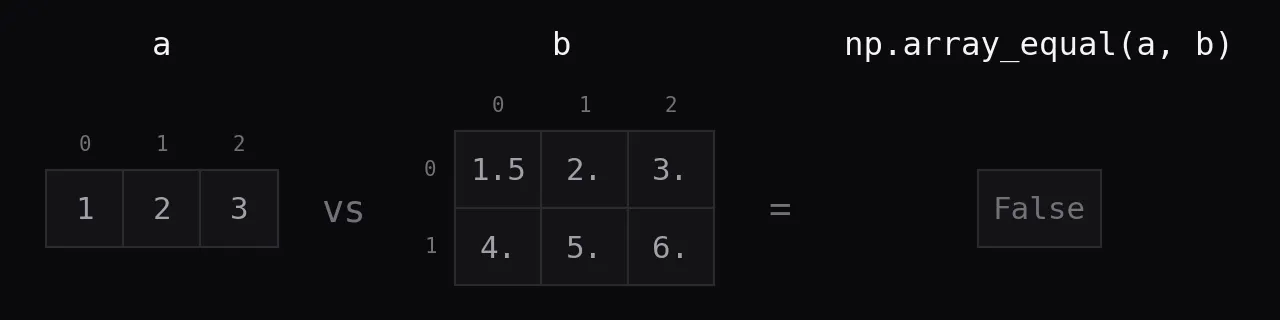
Один bool на весь массив: True, только если совпадают и форма, и все значения. Здесь формы разные.
np.array_equal(a, b)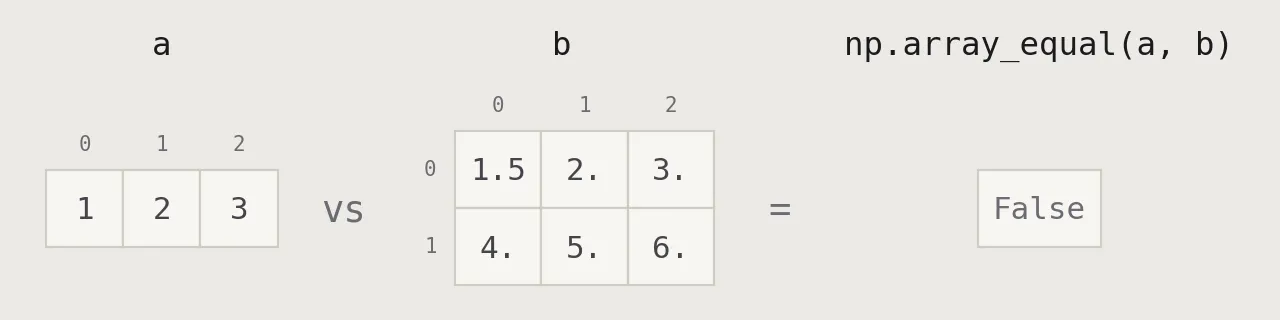
Агрегатные функции
a.sum
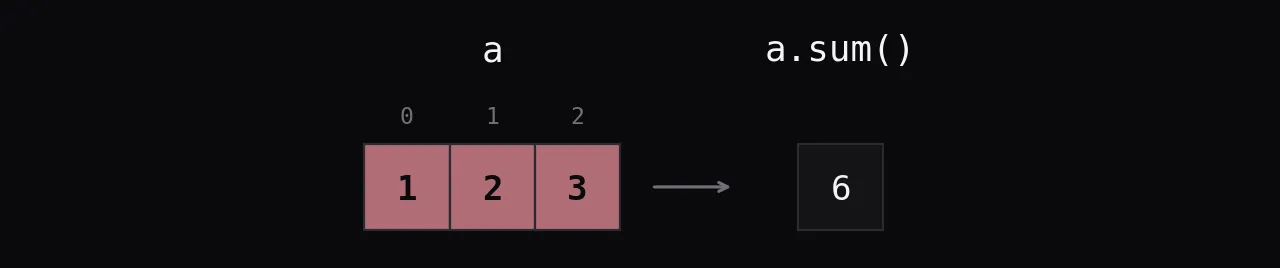
Сумма всех элементов.
a.sum()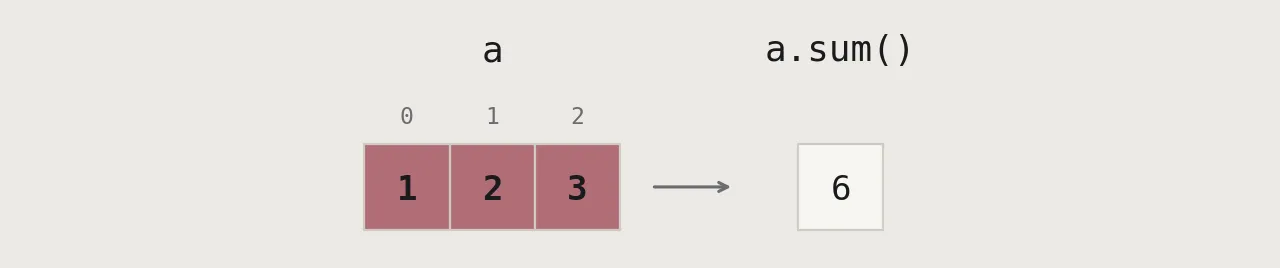
a.min
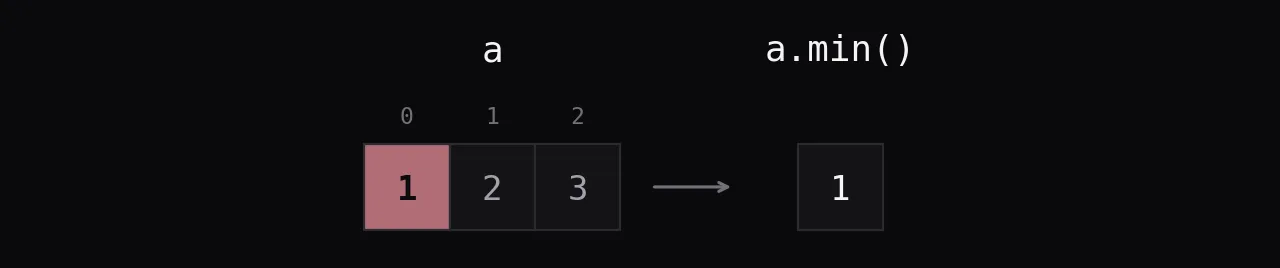
Наименьший элемент. Его индекс даёт a.argmin().
a.min()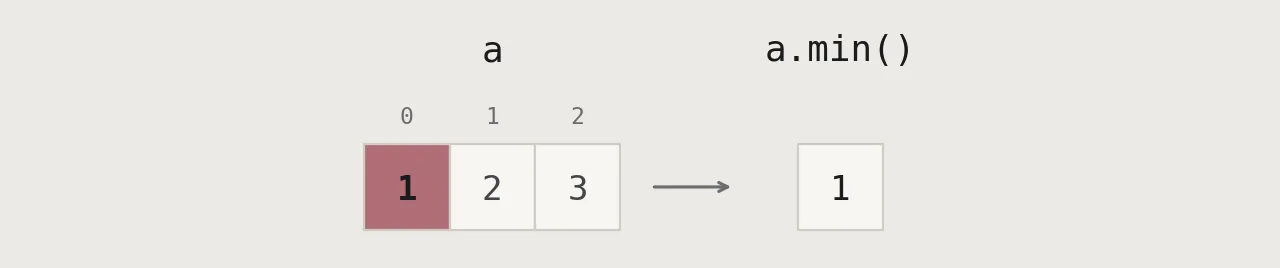
b.max(axis=0)
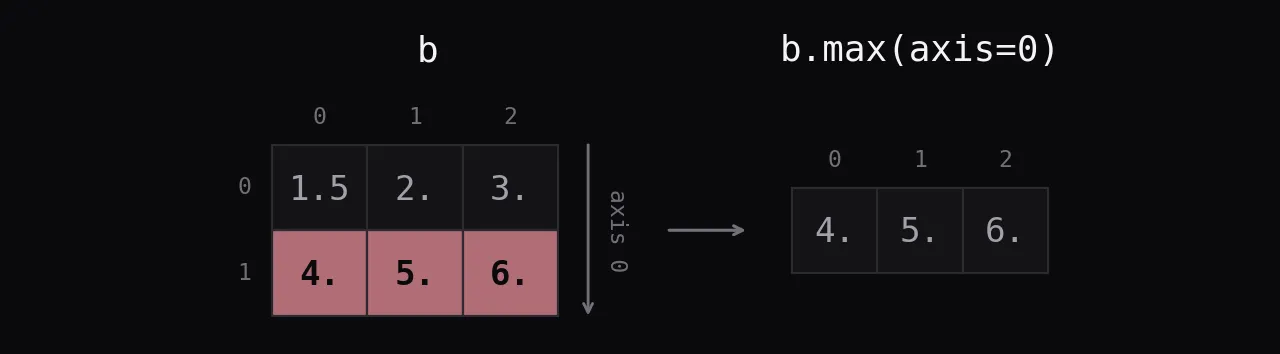
С axis=0 свёртка идёт вдоль оси 0, вниз по строкам, поэтому каждый столбец даёт одно значение. В шпаргалке написано «максимум строки», но при axis=0 это максимум каждого столбца.
b.max(axis=0)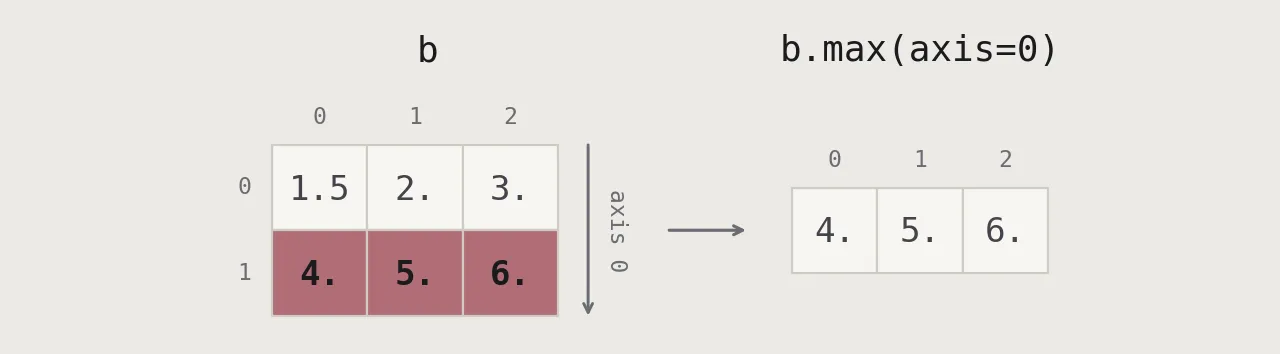
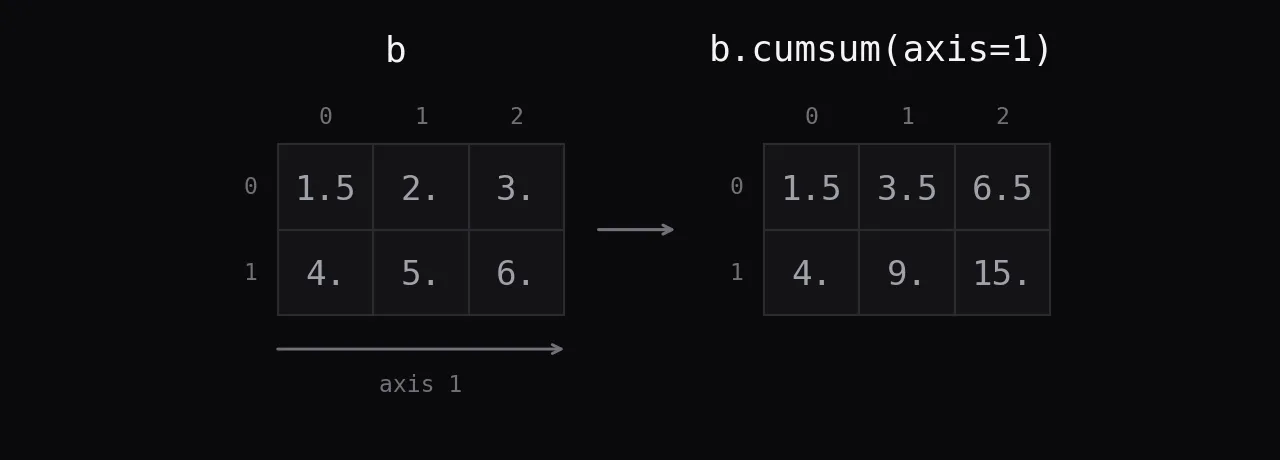
b.cumsum(axis=1)
Накопленная сумма вдоль каждой строки. Форма не меняется.
b.cumsum(axis=1)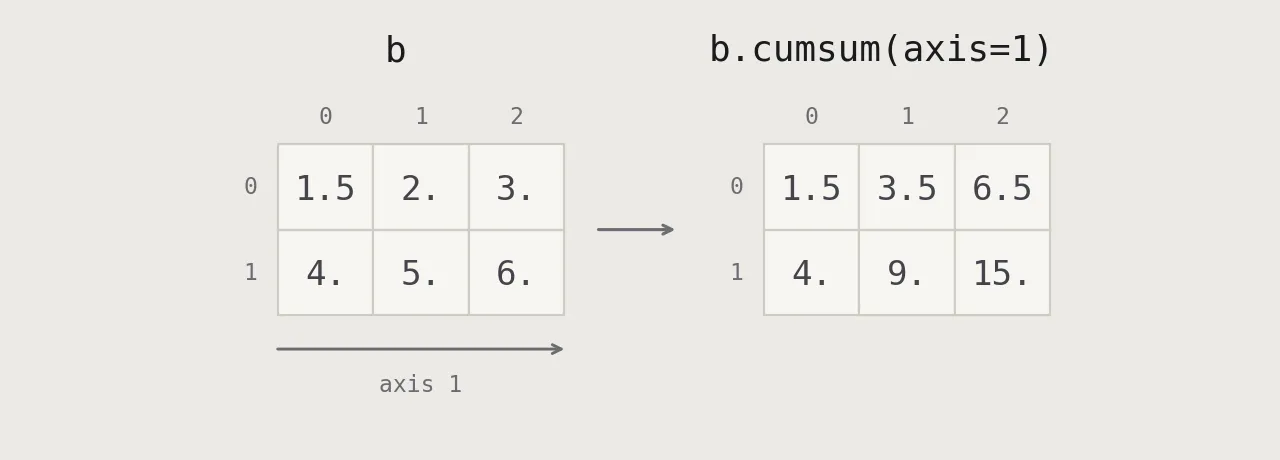
a.mean
Среднее арифметическое всех элементов.
a.mean()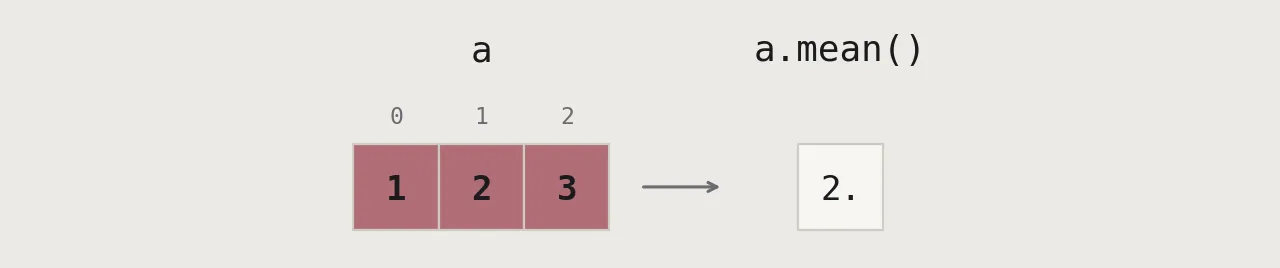
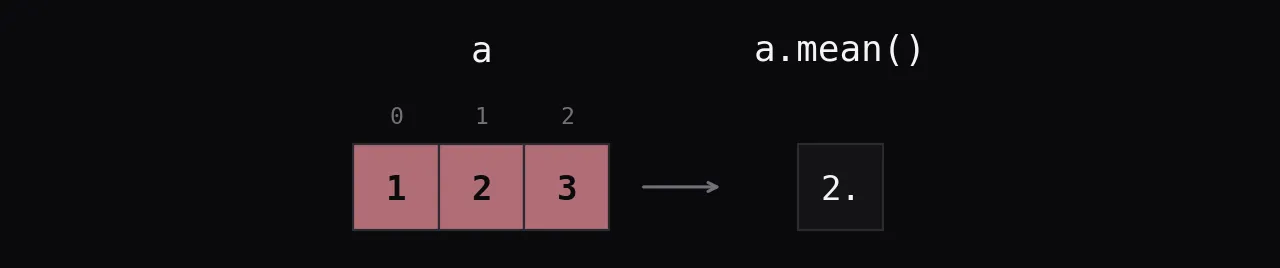
np.median
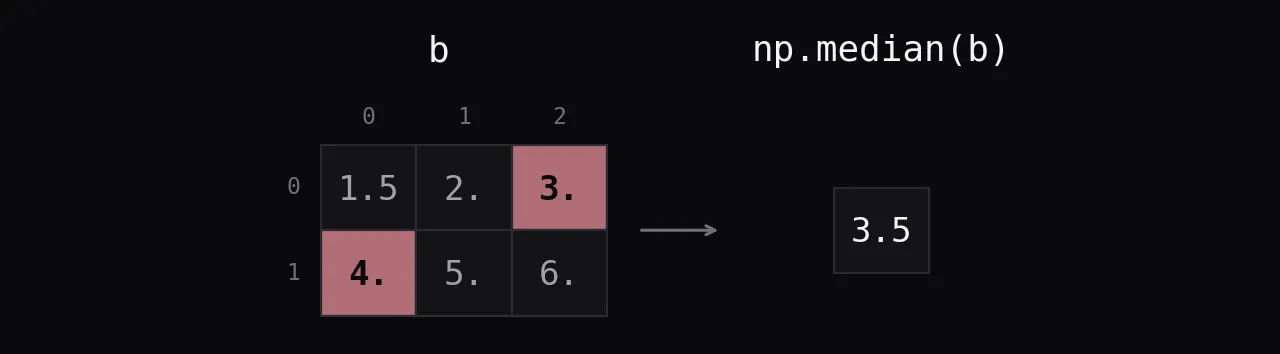
Метода b.median() нет, строка из шпаргалки падает с AttributeError. Нужен np.median. Значений шесть, поэтому медиана - среднее двух средних, 3 и 4.
np.median(b)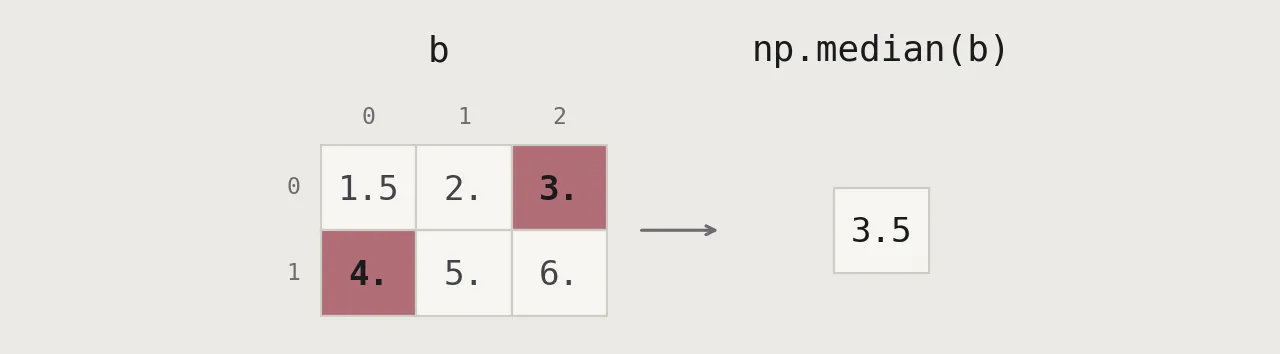
np.corrcoef
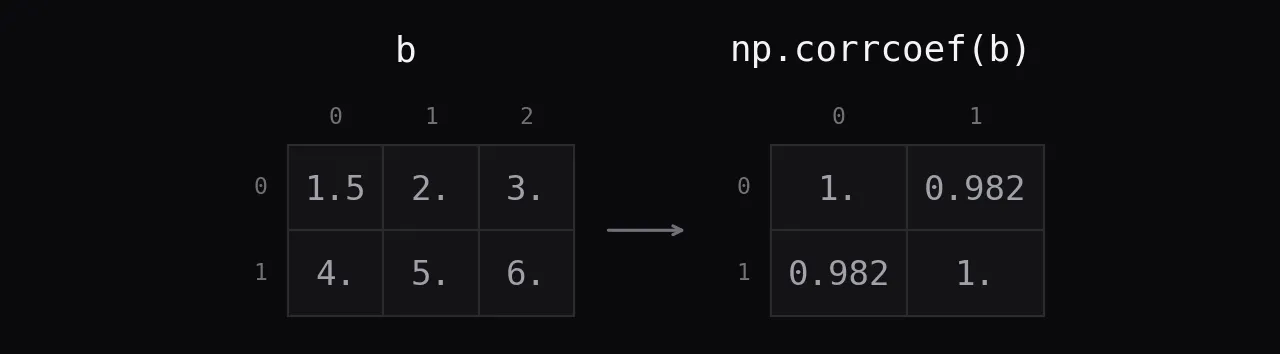
Метода a.corrcoef() тоже нет. np.corrcoef считает каждую строку переменной и возвращает матрицу их корреляций. Две строки b коррелируют почти идеально.
np.corrcoef(b)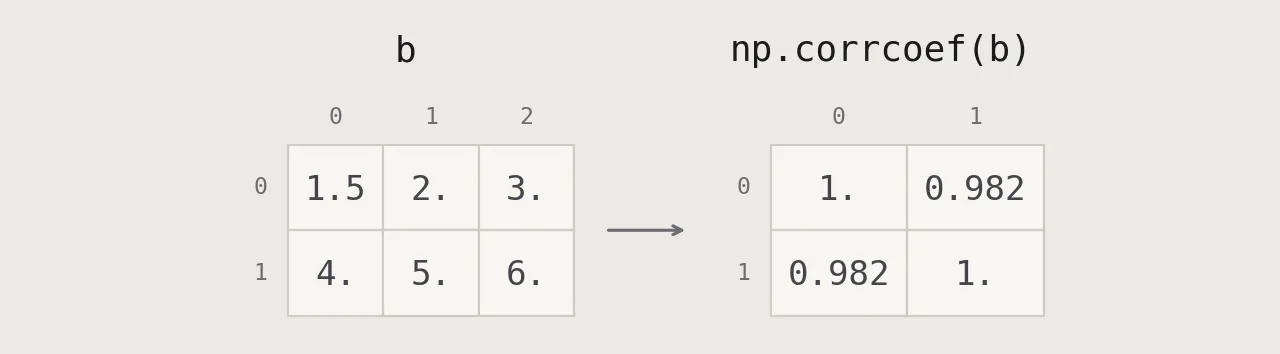
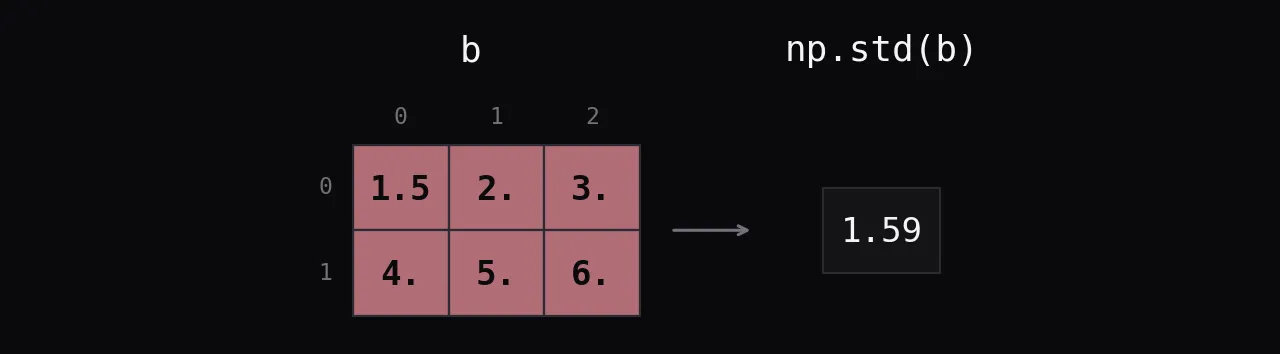
np.std
Стандартное отклонение по всем элементам. По умолчанию для генеральной совокупности (ddof=0); для выборочного передайте ddof=1.
np.std(b)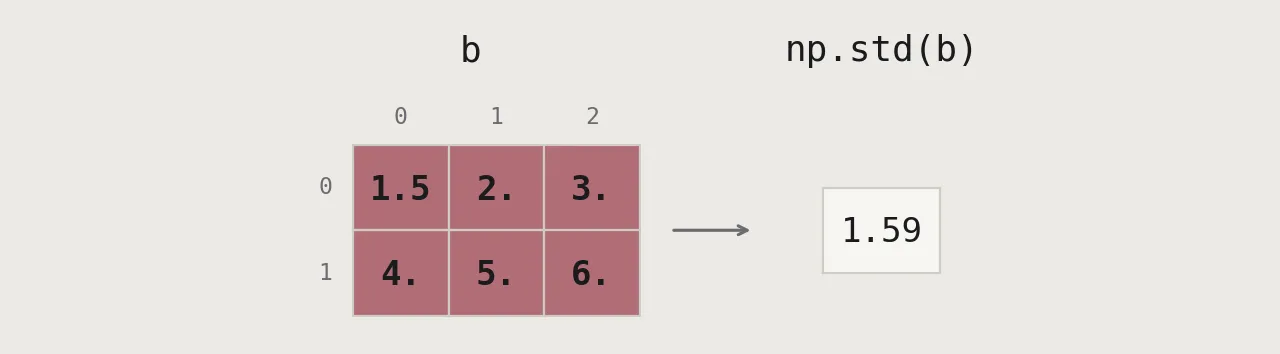
Копирование
a.view
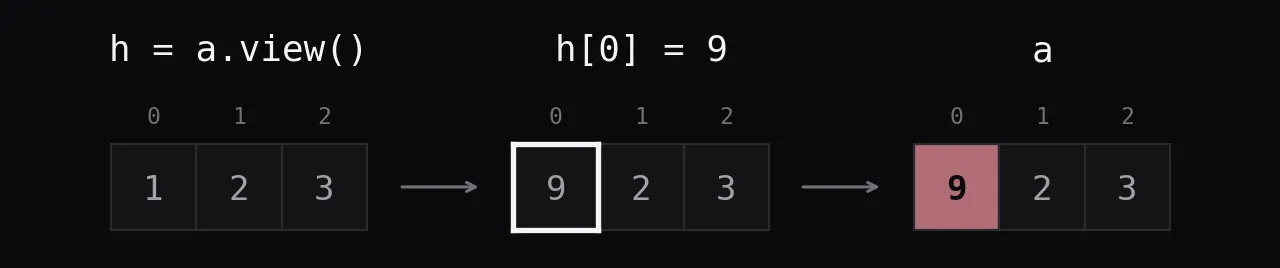
Представление (view) делит память с оригиналом, поэтому запись через h меняет и a.
h = a.view()
h[0] = 9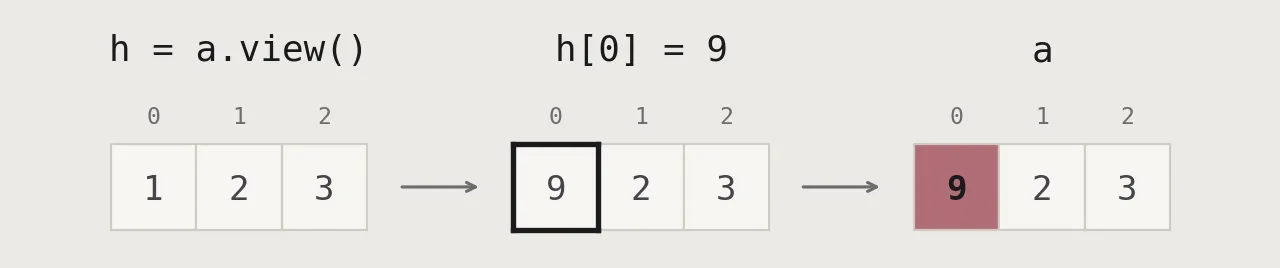
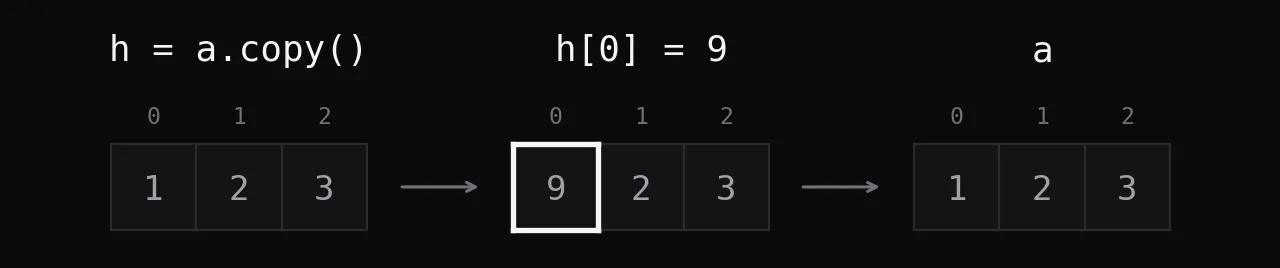
a.copy
a.copy() и np.copy(a) делают независимую копию, поэтому a не меняется.
h = a.copy()    # or np.copy(a)
h[0] = 9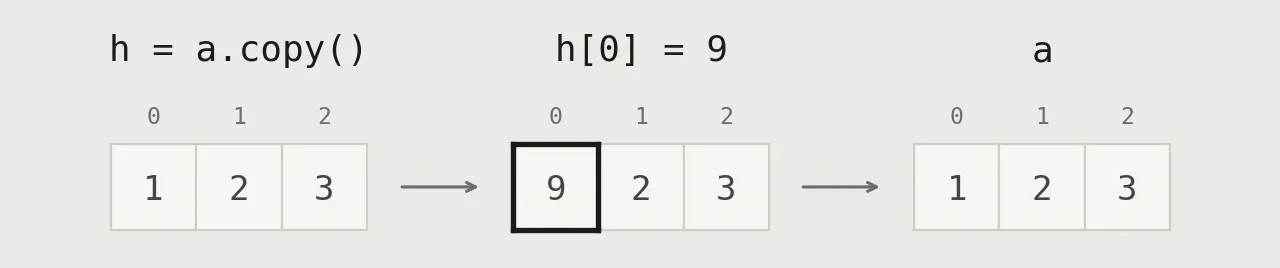
Сортировка
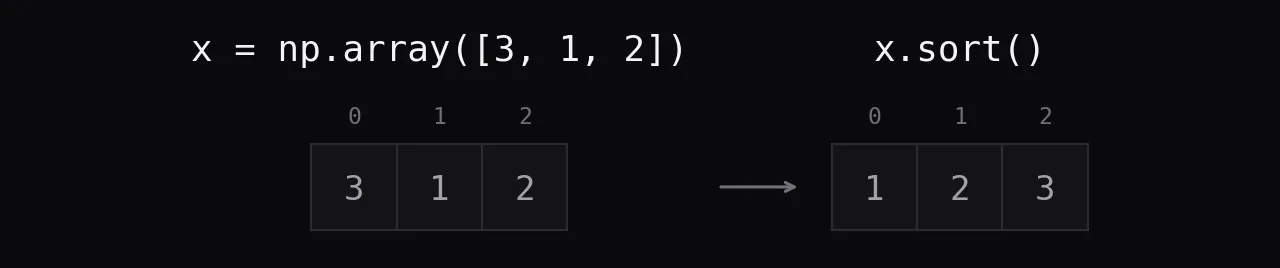
x.sort
Сортирует на месте и возвращает None; np.sort(x) вместо этого возвращает отсортированную копию. a из шпаргалки уже отсортирован, поэтому здесь x.
x = np.array([3, 1, 2])
x.sort()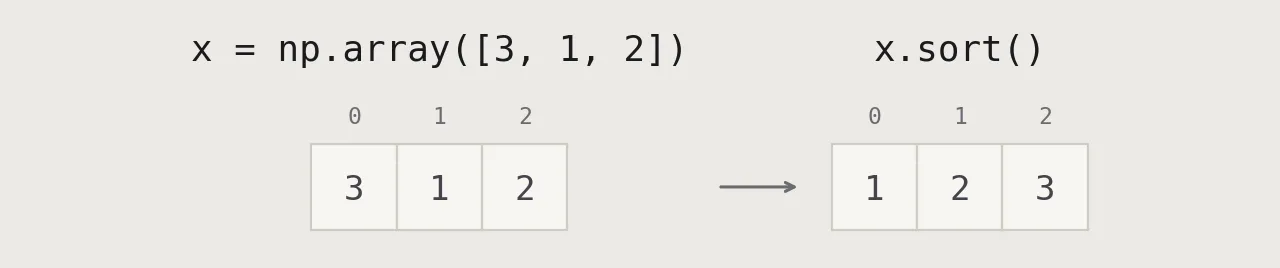
c.sort(axis=0)
Сортирует вдоль оси 0: каждая позиция сортируется между двумя блоками. Не на месте только 3 и 1 в углу, поэтому меняются только они.
c.sort(axis=0)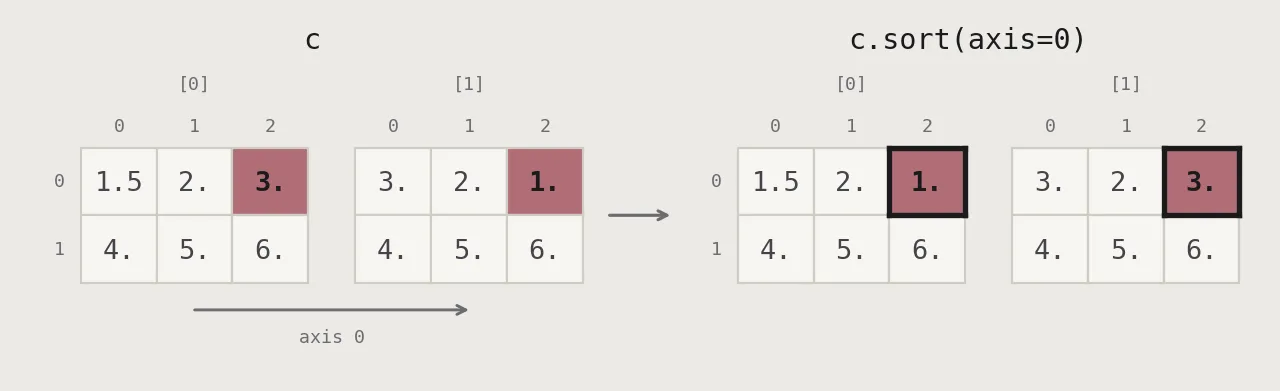
Выборка, срезы, индексация
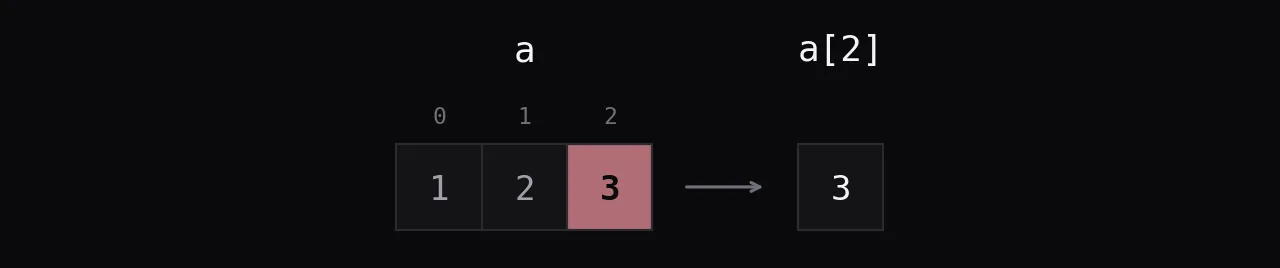
a[2]
Элемент с индексом 2.
a[2]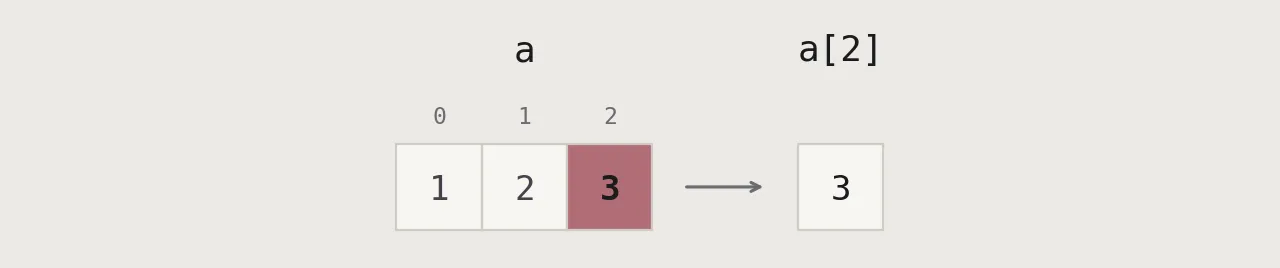
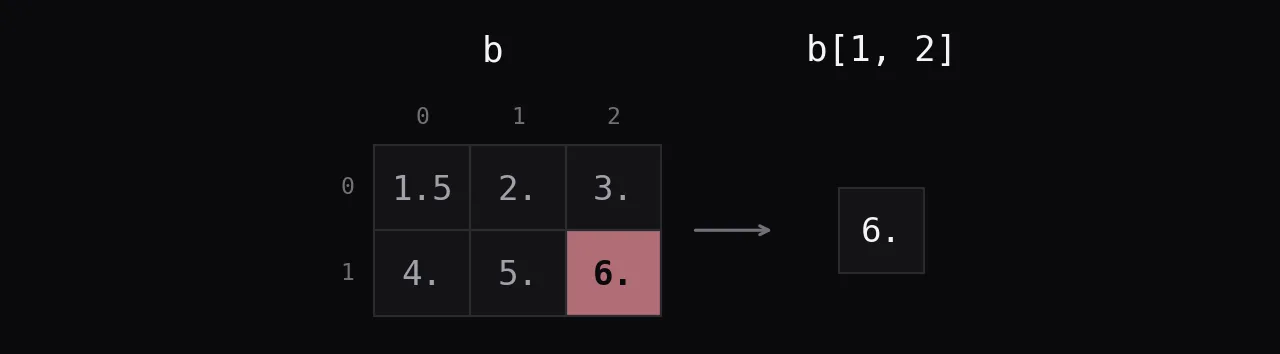
b[1, 2]
Строка 1, столбец 2. То же, что b[1][2], но за одну операцию индексации вместо двух.
b[1, 2]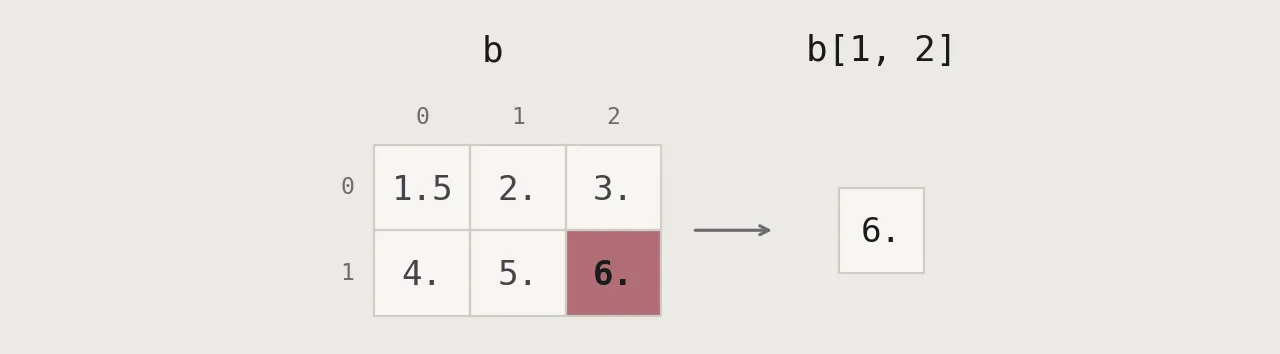
a[0:2]
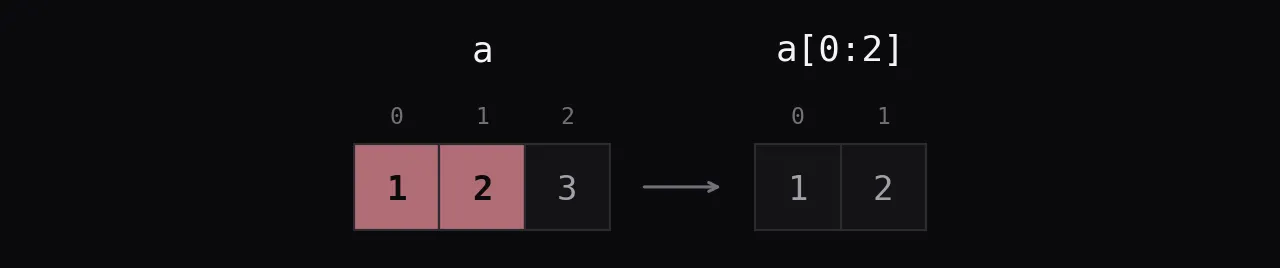
Start включается, stop - нет: индексы 0 и 1.
a[0:2]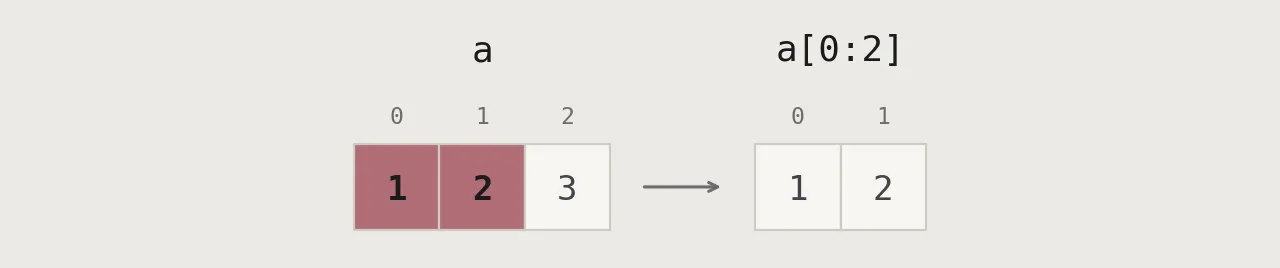
b[0:2, 1]
Строки 0 и 1 столбца 1. Одиночный индекс убирает свою ось, поэтому результат одномерный.
b[0:2, 1]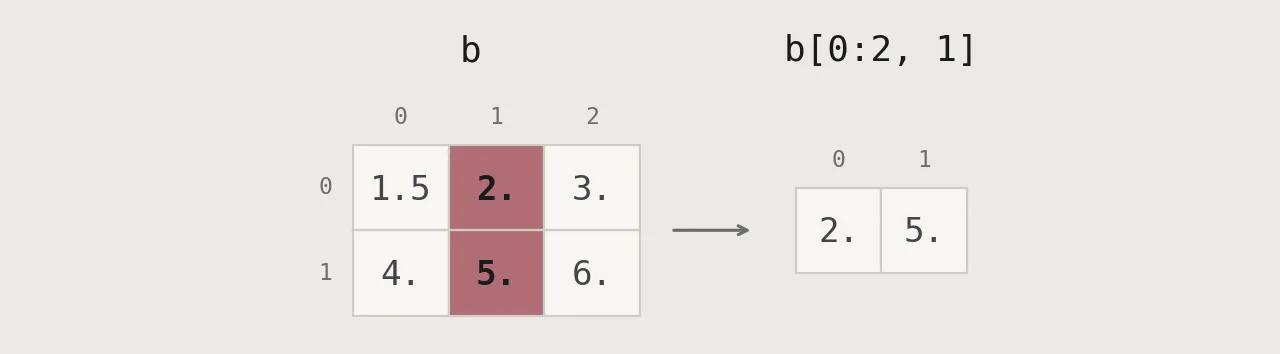
b[:1]
Срез сохраняет ось: b[:1] - двумерный массив из одной строки, а b[0] был бы одномерным. То же, что b[0:1, :].
b[:1]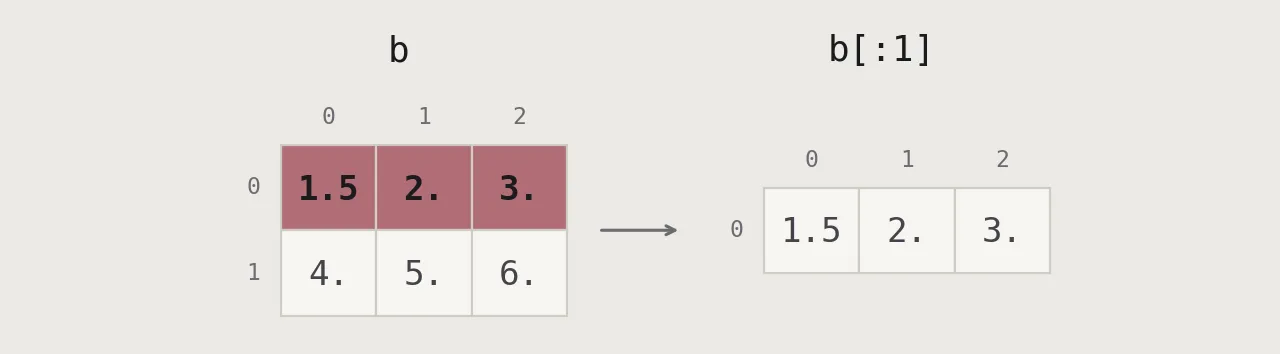
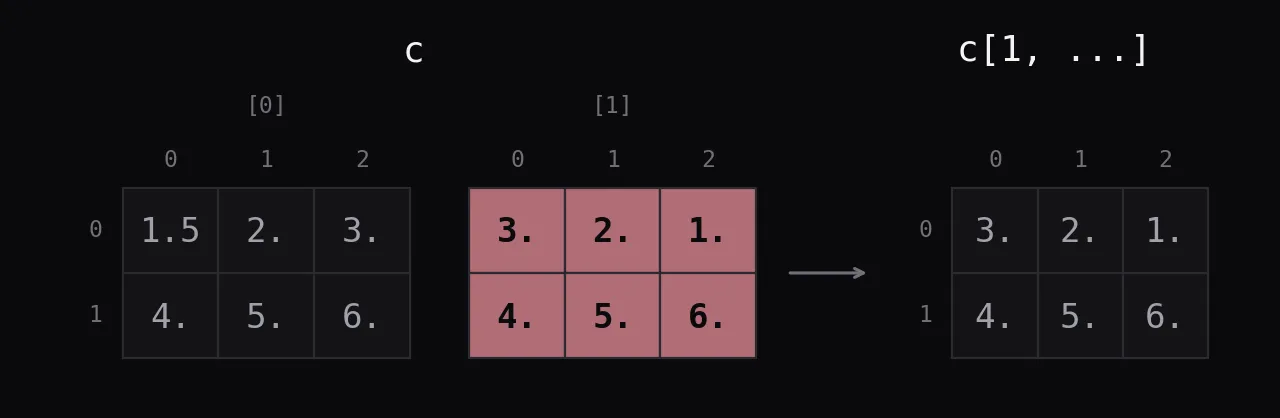
c[1, …]
... заменяет столько :, сколько нужно, поэтому c[1, ...] - это c[1, :, :], второй блок. В шпаргалке вывод напечатан с лишней скобкой; результат двумерный.
c[1, ...]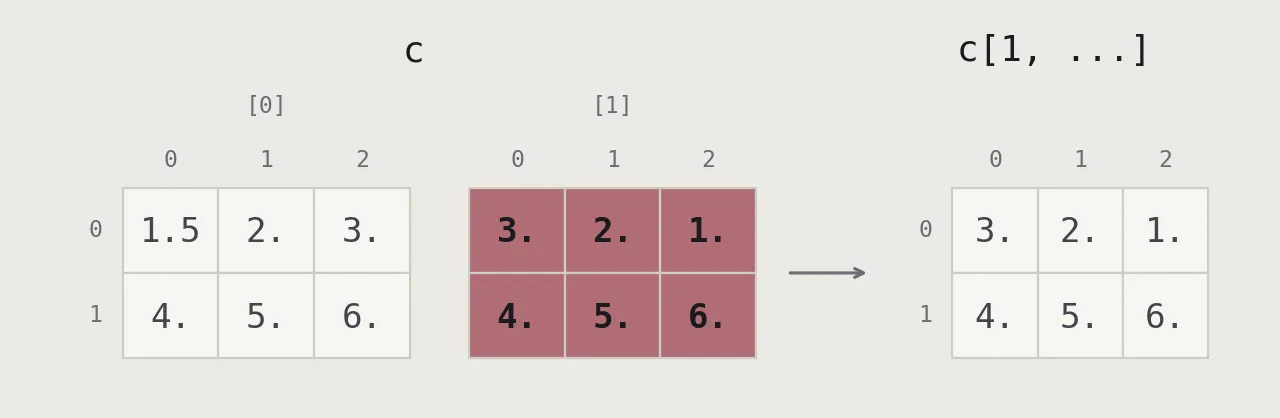
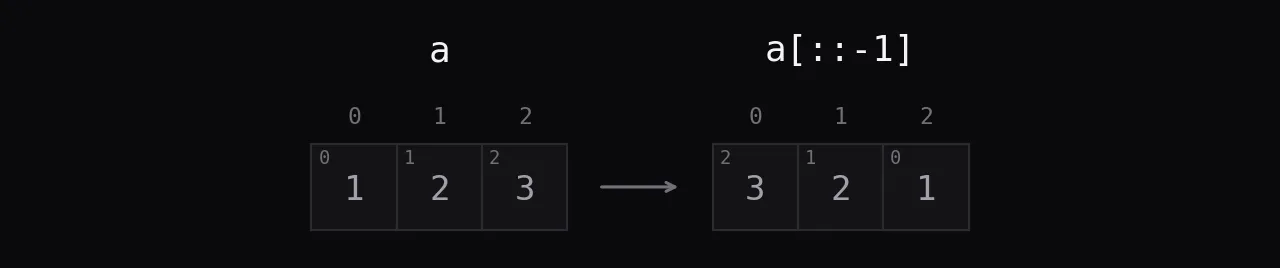
a[::-1]
Отрицательный шаг идёт назад. Маленькие числа показывают, откуда пришёл каждый элемент. Результат - view, а не копия.
a[::-1]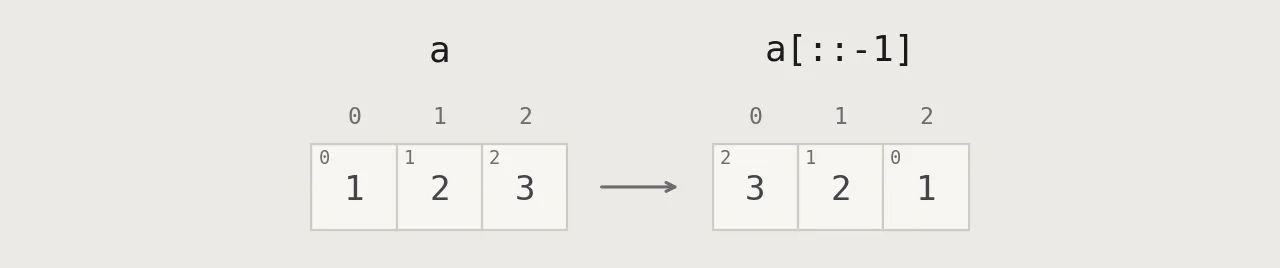
a[a < 2]
Массив bool в роли индекса оставляет элементы, где стоит True. Результат всегда одномерный и всегда копия.
a[a < 2]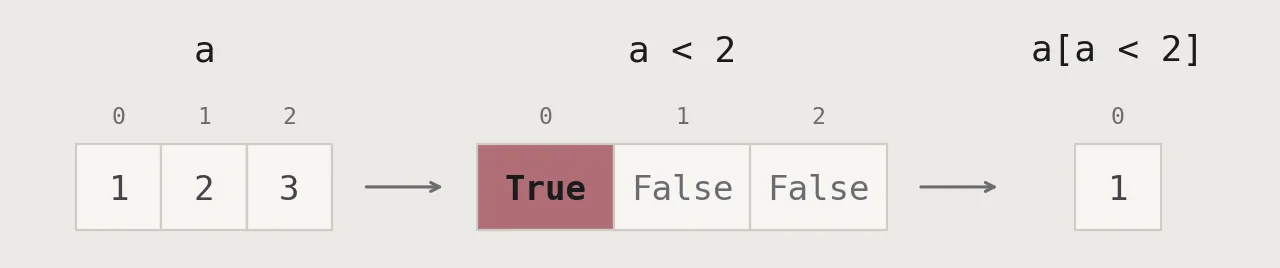
b[[1, 0, 1, 0], [0, 1, 2, 0]]
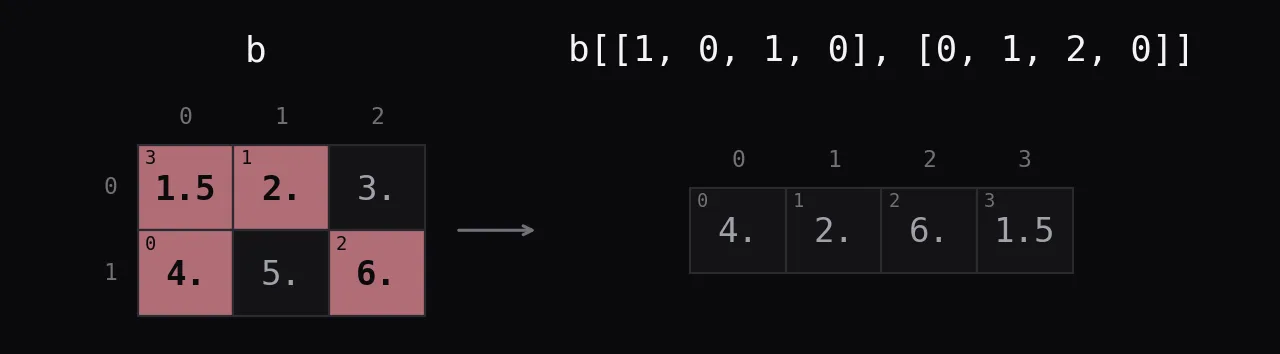
Два списка индексов складываются в пары (1, 0), (0, 1), (1, 2) и (0, 0). Маленькие числа показывают порядок. Fancy indexing возвращает копию.
b[[1, 0, 1, 0], [0, 1, 2, 0]]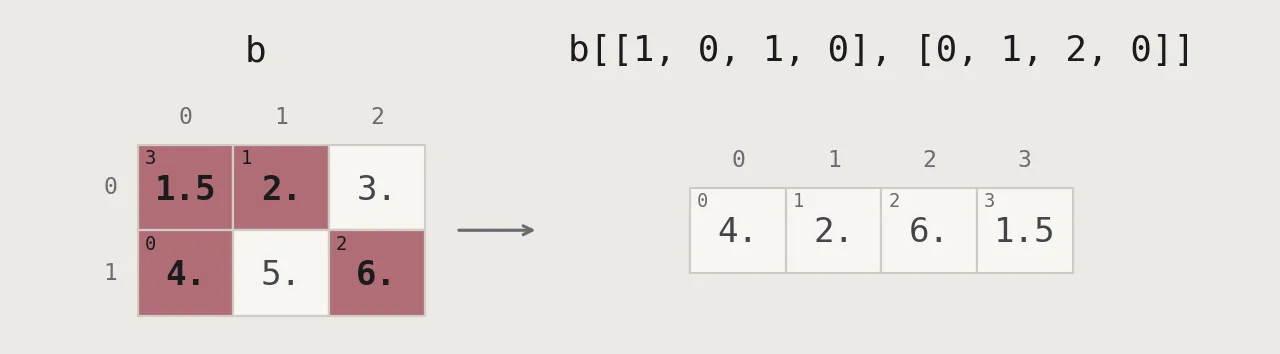
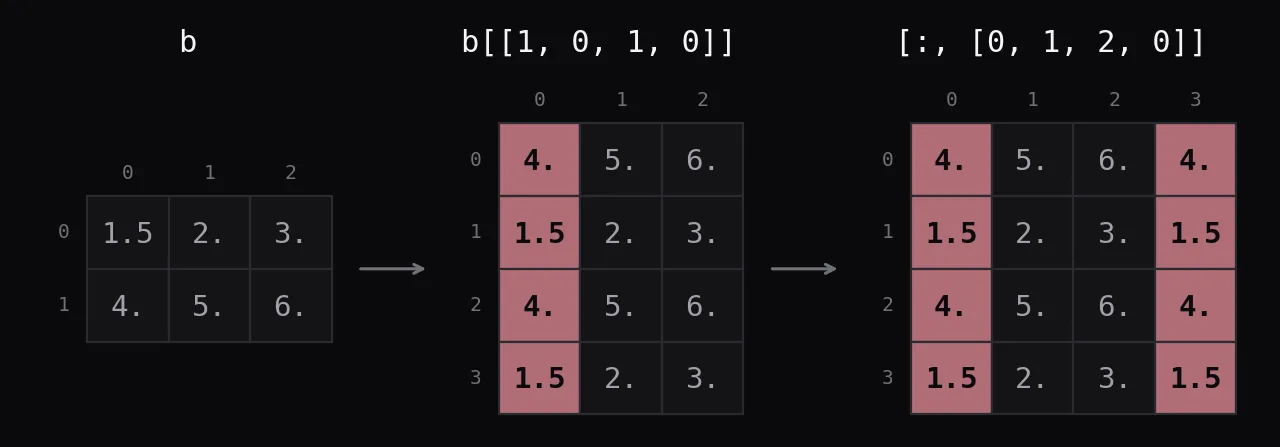
b[[1, 0, 1, 0]][:, [0, 1, 2, 0]]
Сначала строки 1, 0, 1, 0, затем столбцы 0, 1, 2, 0 этого результата: сетка 4x4 с повторёнными строками и столбцами. За один шаг то же делает b[np.ix_([1, 0, 1, 0], [0, 1, 2, 0])].
b[[1, 0, 1, 0]][:, [0, 1, 2, 0]]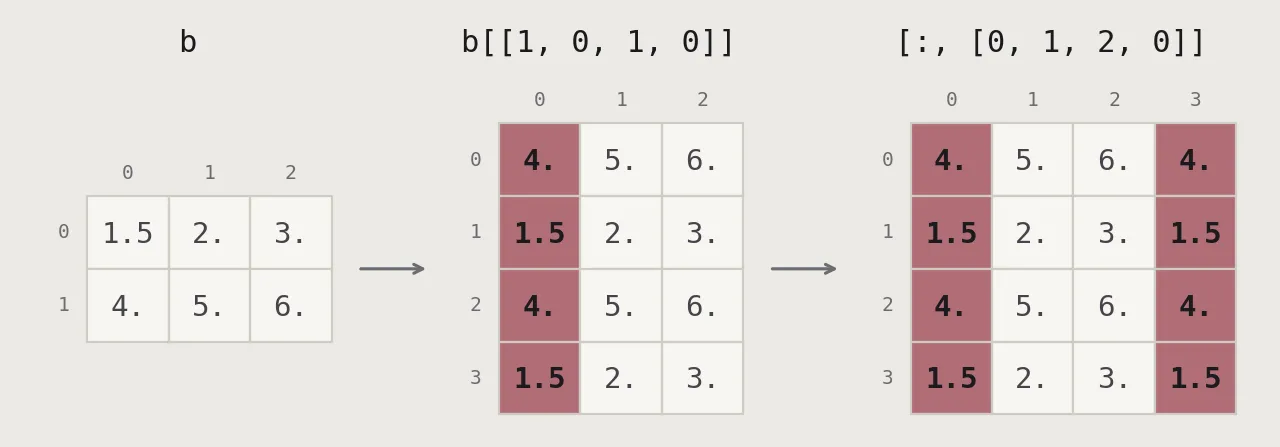
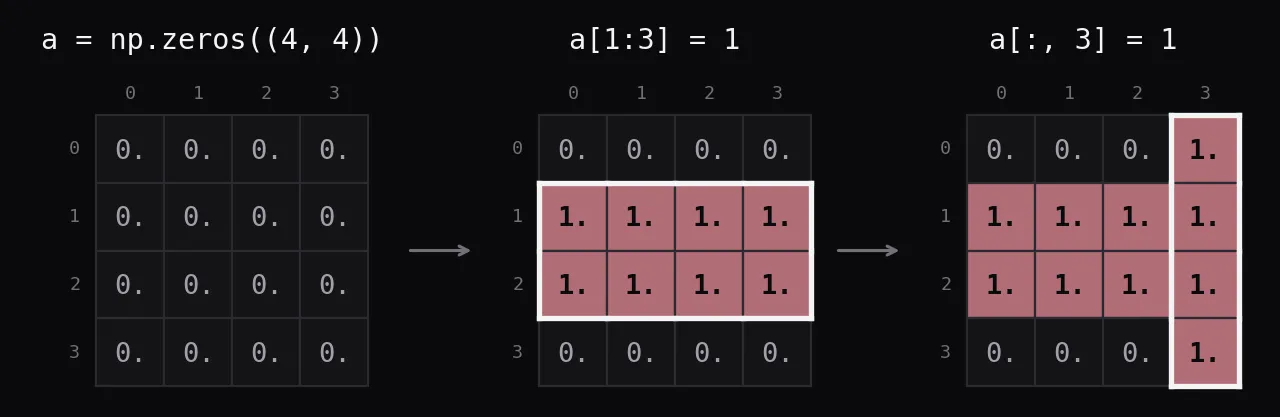
a[1:3] = 1
Этого нет в шпаргалке: присваивание через срезы. a[1:3] - сокращение для a[1:3, :], а одно число справа растягивается на все выбранные ячейки. Для строк не подряд берётся список: a[[0, 3]] = 1.
a = np.zeros((4, 4))
a[1:3] = 1     # rows 1 and 2
a[:, 3] = 1    # column 3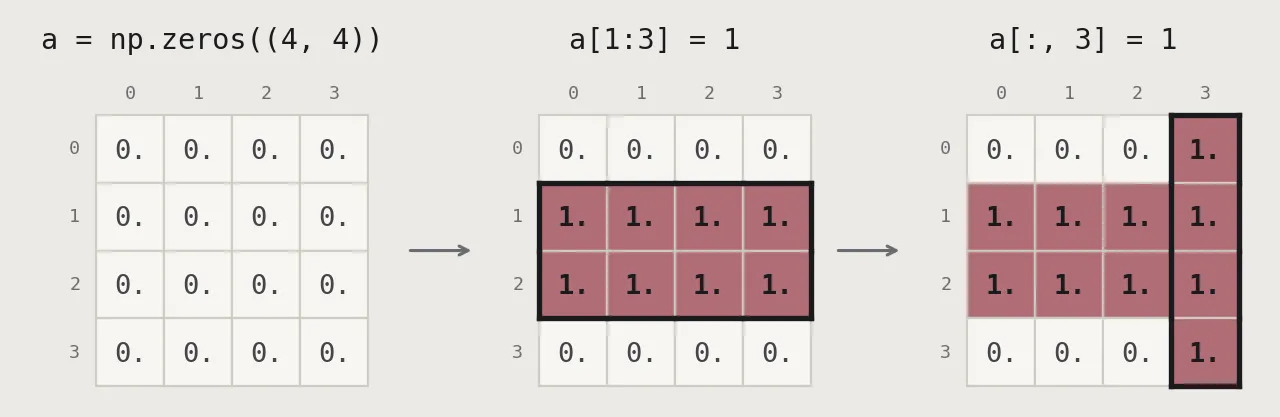
Изменение формы
np.transpose
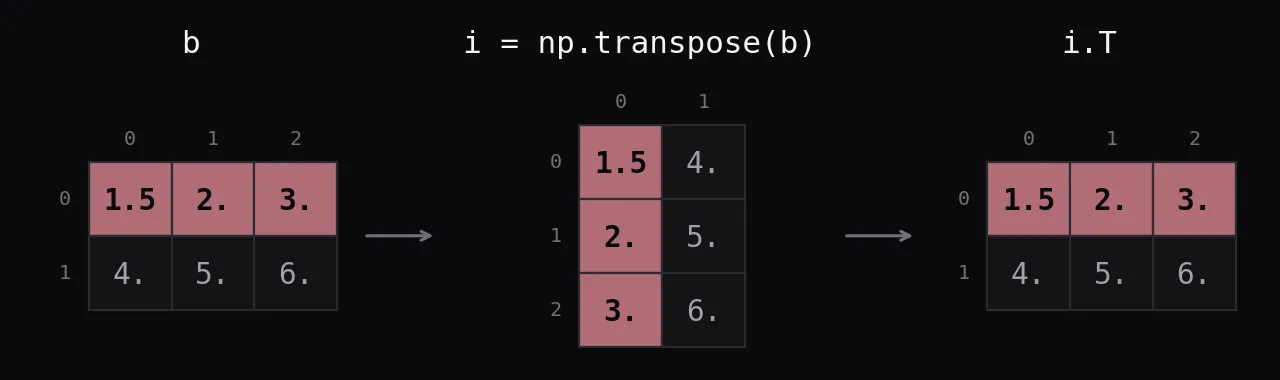
Меняет оси местами: строка 0 становится столбцом 0. .T - короткая запись, а двойное транспонирование возвращает b.
i = np.transpose(b)
i.T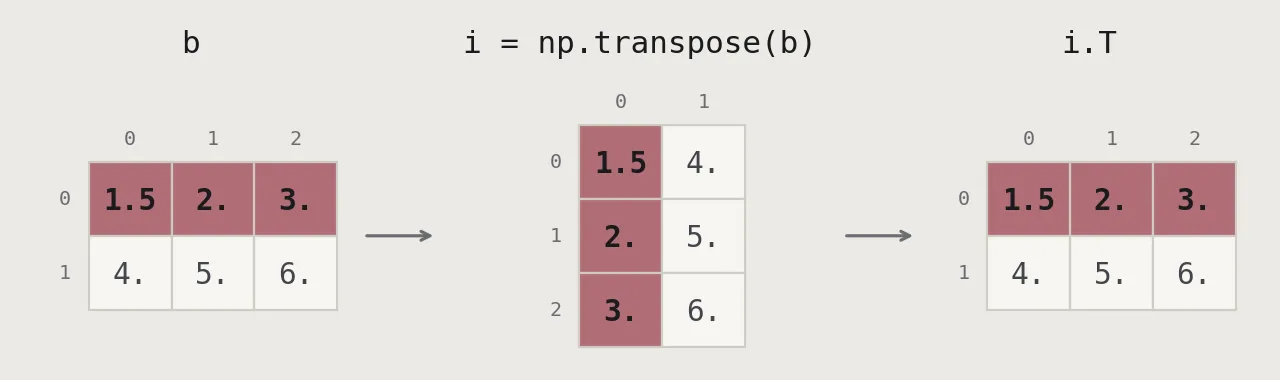
b.ravel
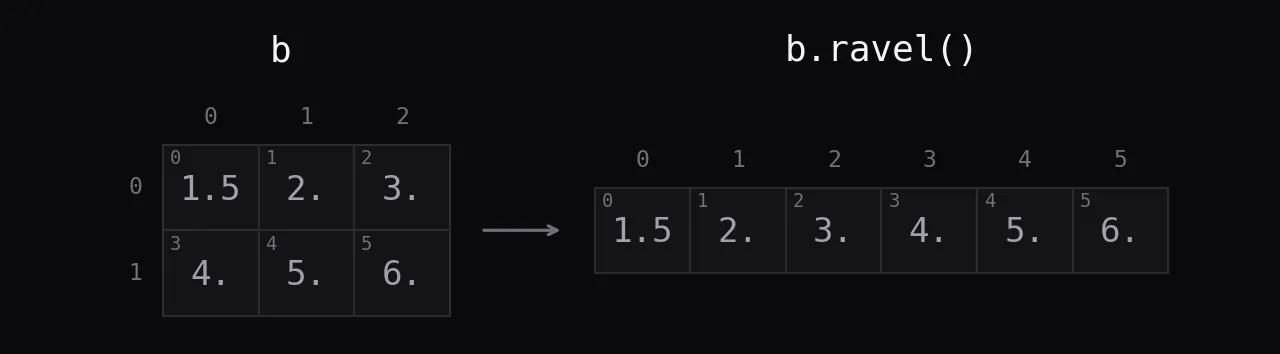
Вытягивает в одномерный массив построчно.
b.ravel()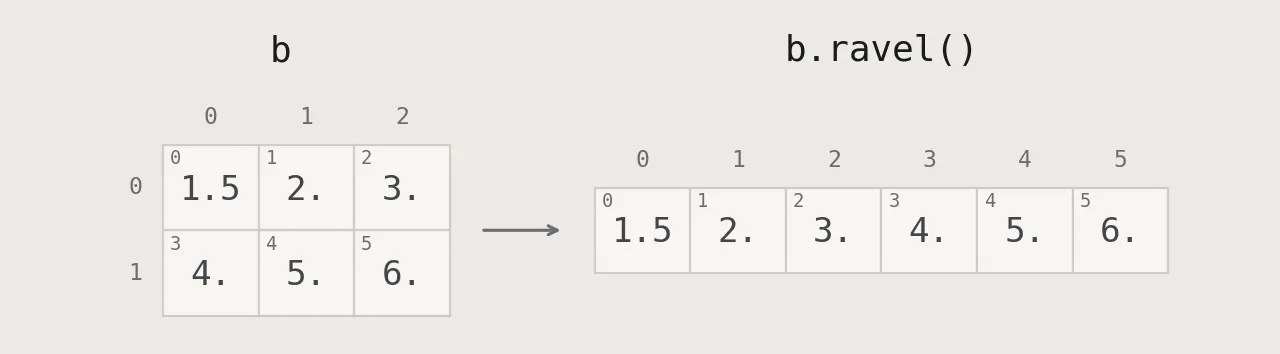
g.reshape
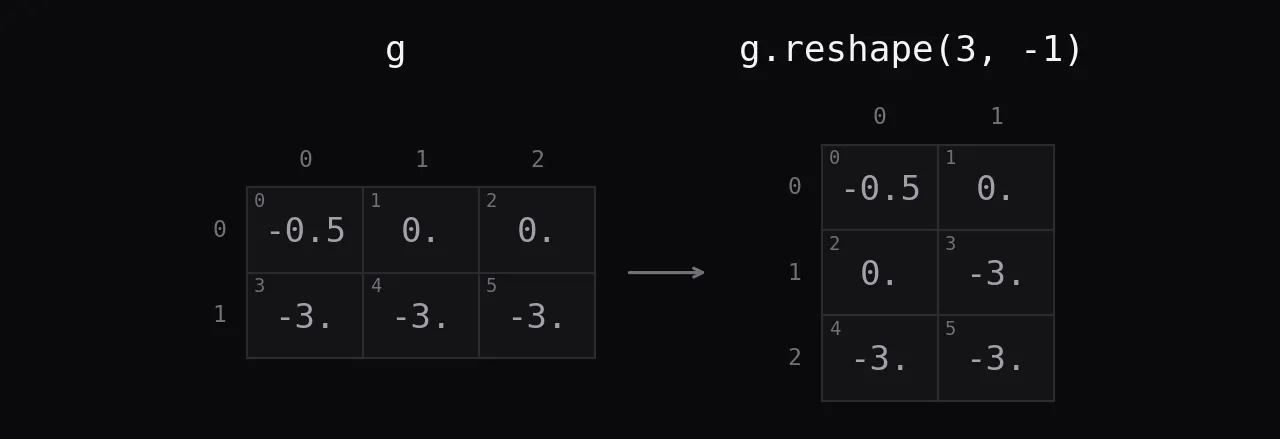
Те же данные в новой форме, порядок элементов сохраняется. -1 значит «вычисли этот размер сам». В шпаргалке написано -2; NumPy это принимает, но документировано именно -1.
g.reshape(3, -1)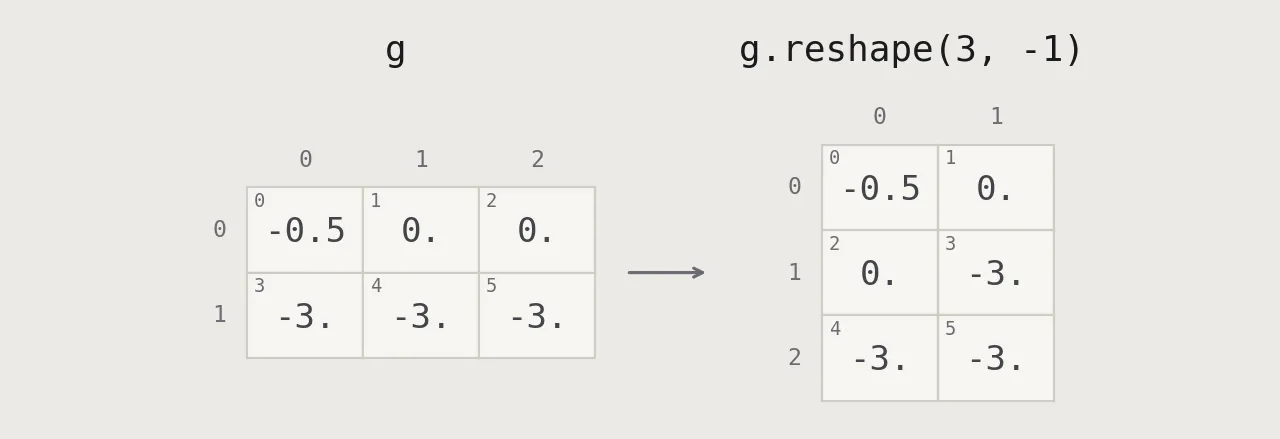
resize
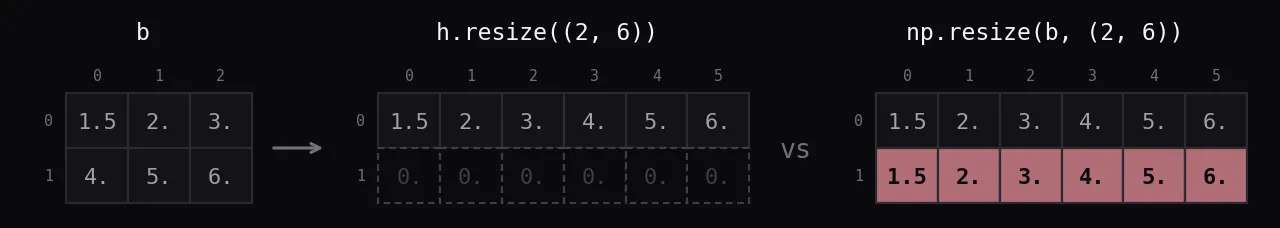
В шпаргалке h.resize вызывается у view, и это падает с ValueError: cannot resize this array: it does not own its data. У массива, который владеет своими данными, метод работает на месте и дополняет нулями. Функция np.resize возвращает новый массив и повторяет данные.
h = b.copy()
h.resize((2, 6))
np.resize(b, (2, 6))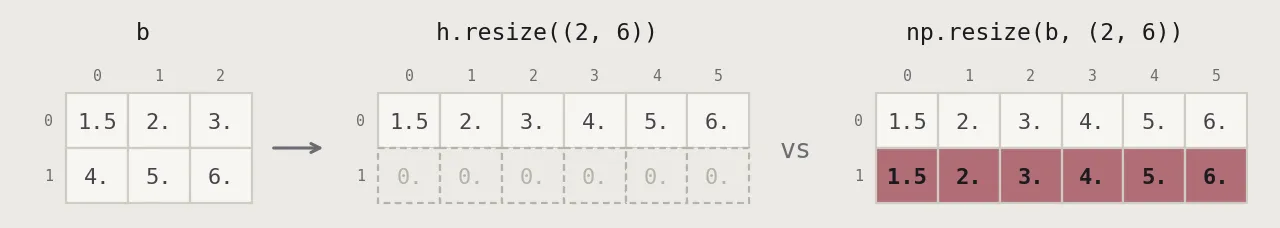
Добавление и удаление элементов
np.append
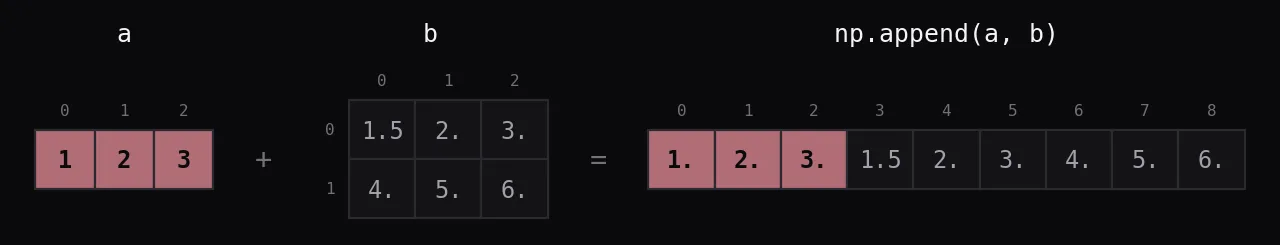
Вытягивает оба массива и склеивает их в новый одномерный. Чтобы сохранить форму, передайте axis=.
np.append(a, b)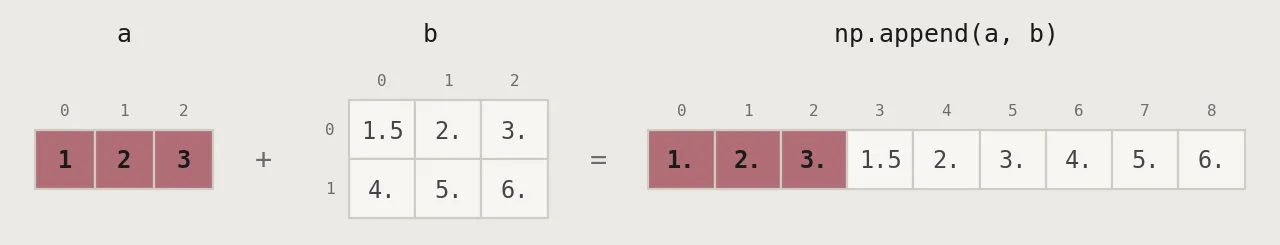
np.insert
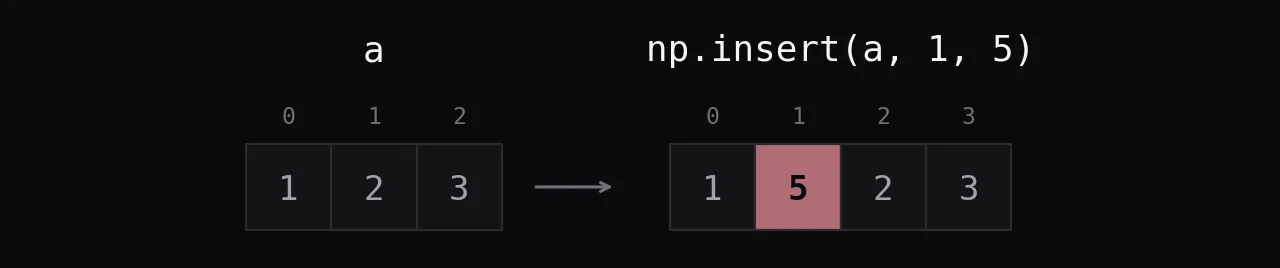
Вставляет 5 перед индексом 1 и возвращает новый массив. Массив NumPy никогда не растёт на месте.
np.insert(a, 1, 5)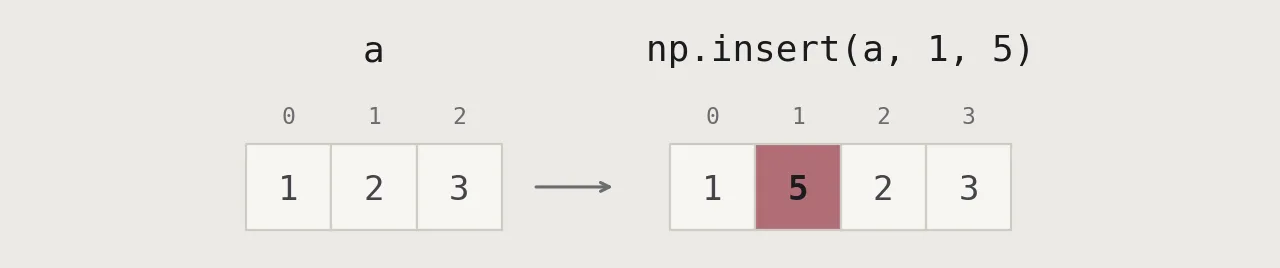
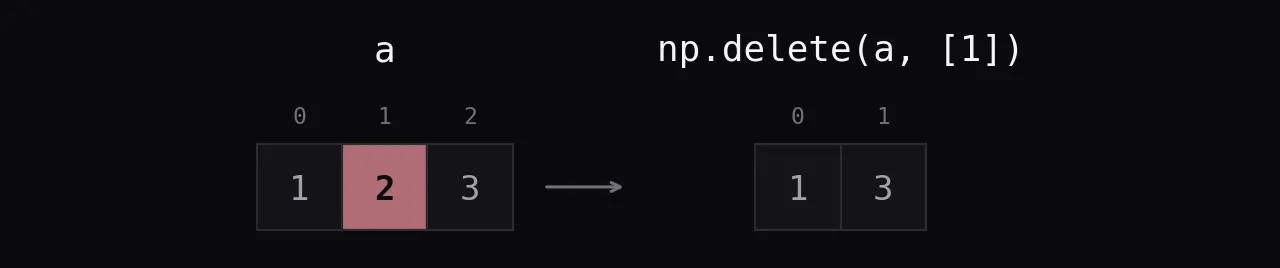
np.delete
Удаляет индекс 1 и возвращает новый массив.
np.delete(a, [1])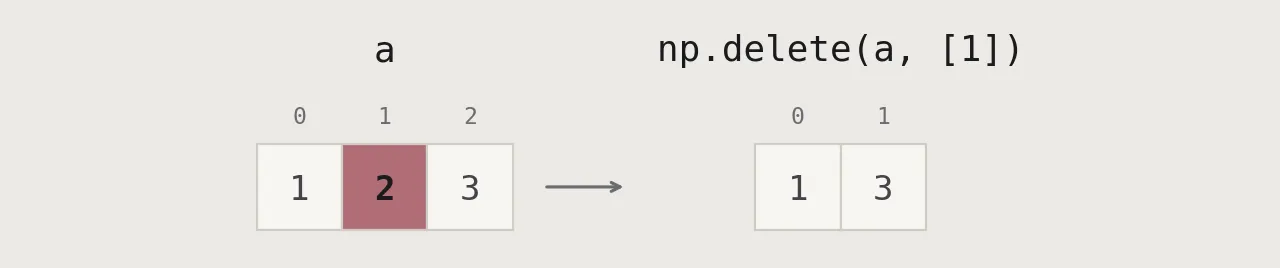
Объединение массивов
np.concatenate
Склеивает массивы вдоль уже существующей оси.
np.concatenate((a, d), axis=0)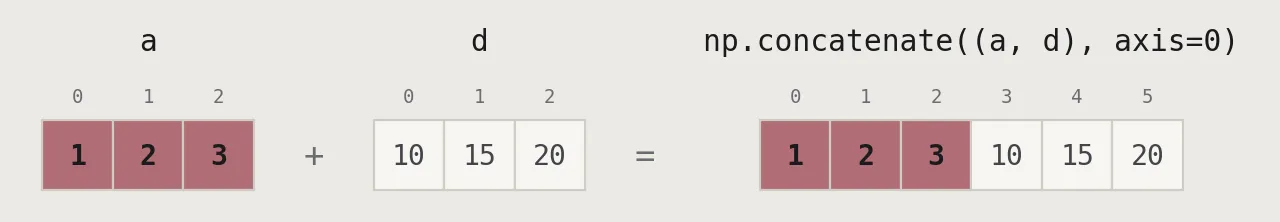
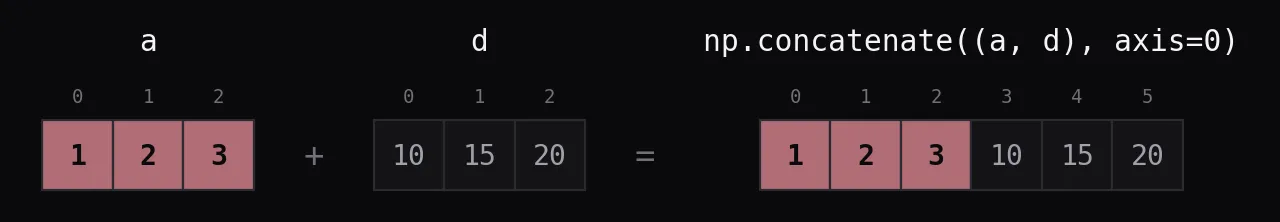
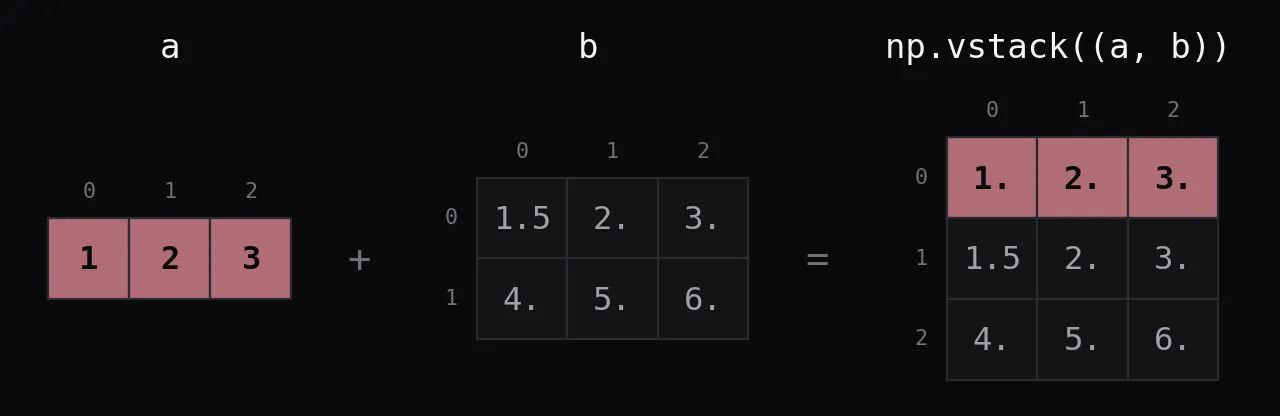
np.vstack
Складывает строки: a становится первой строкой, за ней идут строки b.
np.vstack((a, b))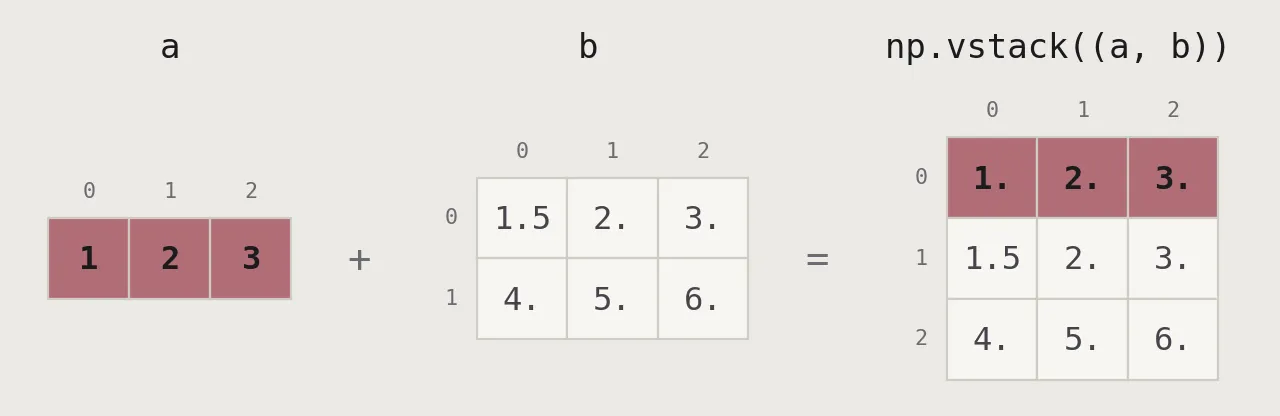
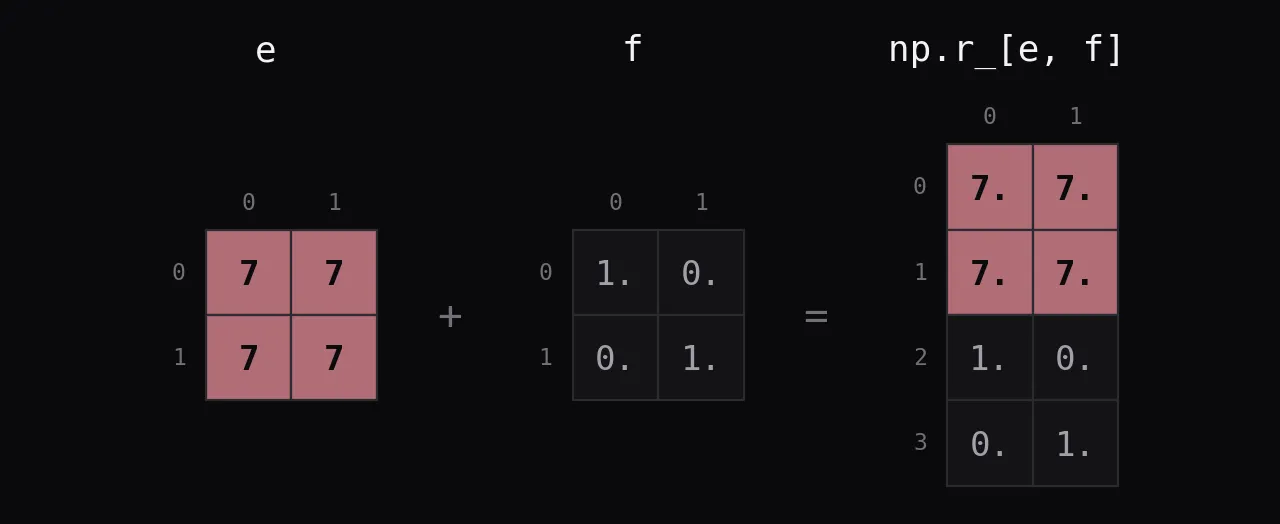
np.r_
Сокращённая запись в стиле индексации, склеивает вдоль оси 0; здесь то же, что np.vstack((e, f)).
np.r_[e, f]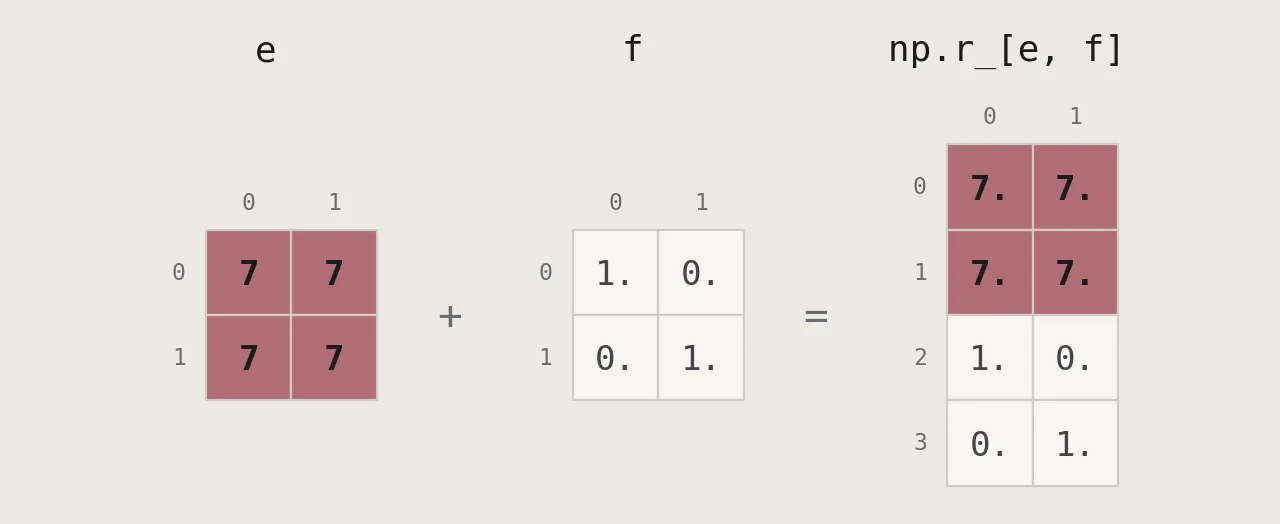
np.hstack
Склеивает бок о бок, вдоль оси 1.
np.hstack((e, f))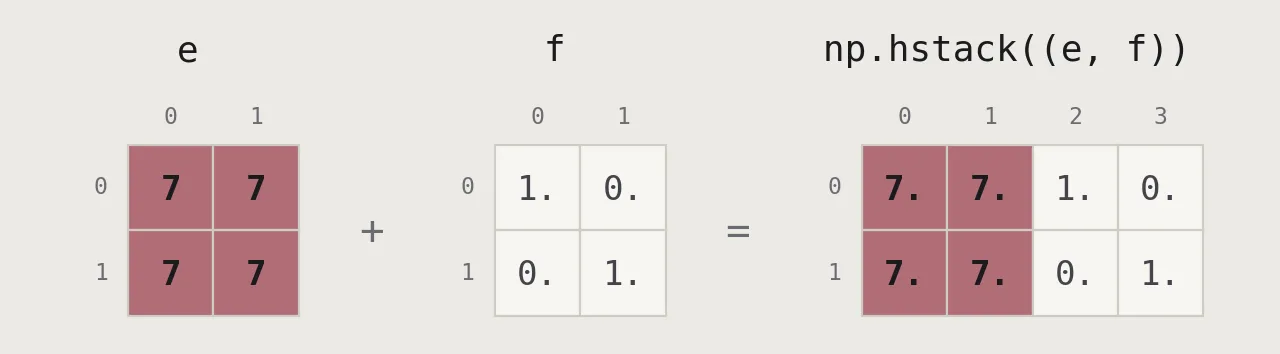
np.column_stack
Делает из одномерных массивов столбцы. np.c_[a, d] даёт тот же результат.
np.column_stack((a, d))
np.c_[a, d]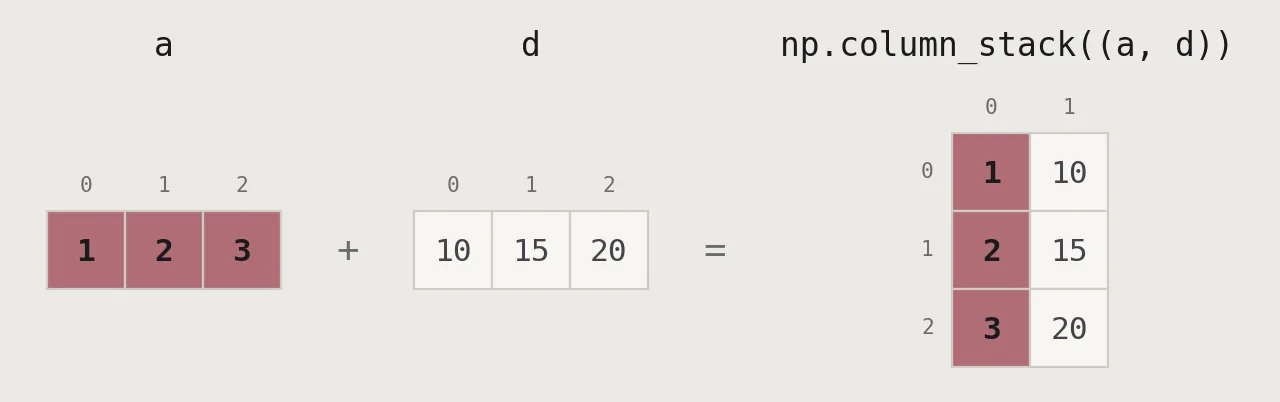
Разбиение массивов
np.hsplit
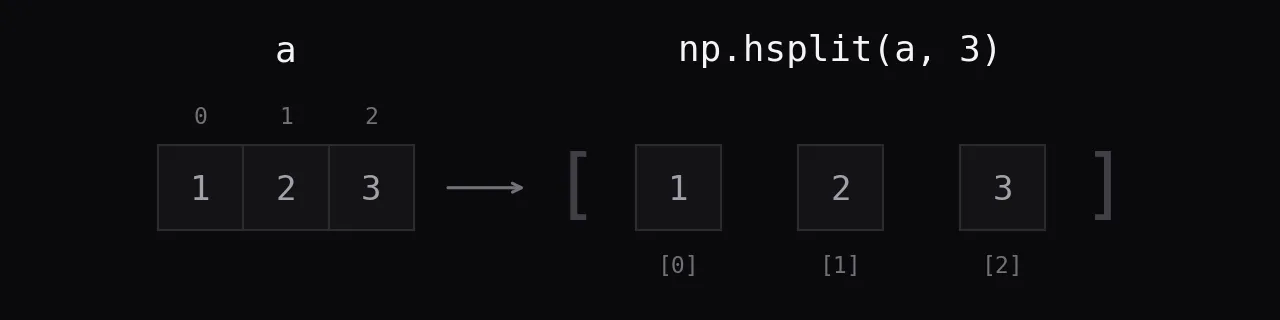
Делит на 3 равные части вдоль оси 1; у одномерного массива это его единственная ось. Результат - список массивов.
np.hsplit(a, 3)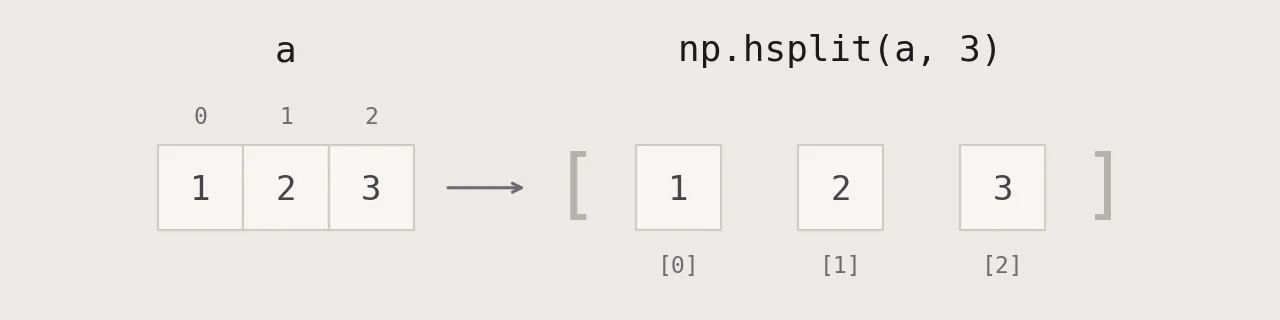
np.vsplit
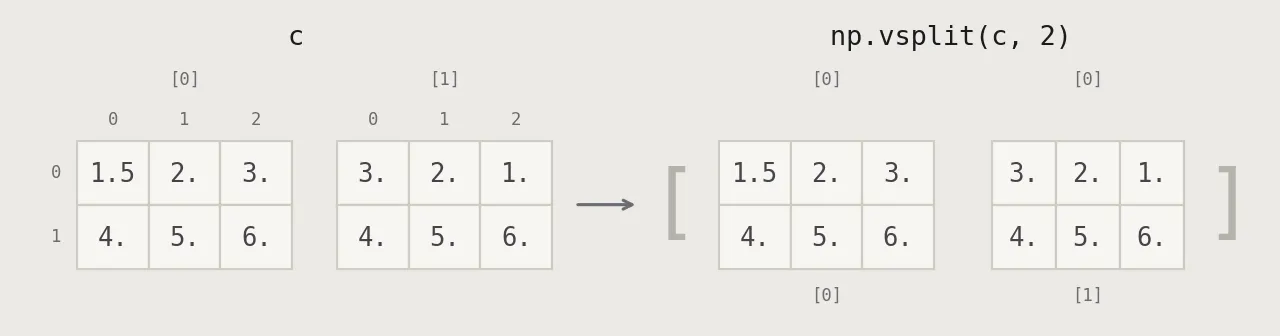
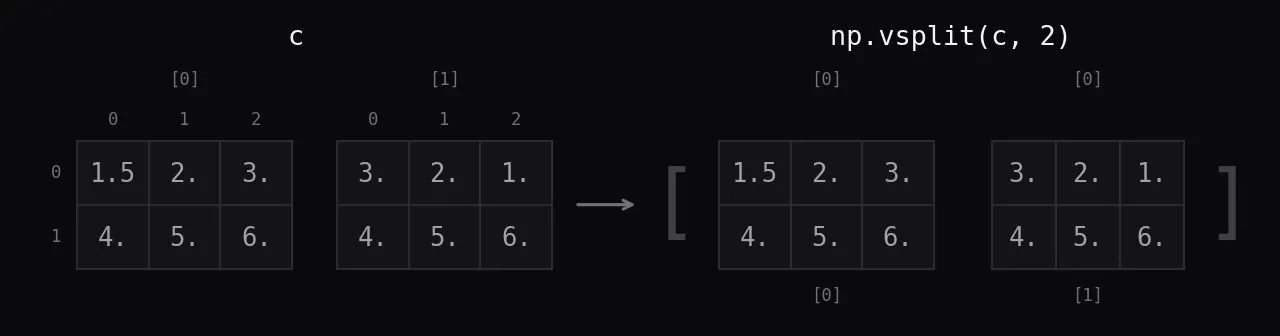
Делит вдоль оси 0 на 2 части, здесь это два блока c. Значения, которые шпаргалка печатает для этой строки, неверны; на картинке настоящие.
np.vsplit(c, 2)