latent state // ログ
2026年11月15日 // ML // 38分

NumPy チートシート

↓ .md

DataCamp の NumPy チートシート の全例を NumPy 2.4 で実行しました。各例にコードと図があります。図は同じコードを実行して描いているので、NumPy が実際に返すものを示しています。

図の読み方:色の付いたセルは、その操作が選ぶ・読む・生成するセルです。太い枠は、そのステップで書き込まれたセルです。点線の薄いセルは、ブロードキャストで NumPy が繰り返す値です。セルの隅の小さな数字は要素の順番です。縁の灰色の数字はインデックスで、0 から数えます。

元のチートシートが NumPy 2 で失敗する、または誤っている箇所は修正し、何が変わったかを本文に書きました。例では次の配列を使います:

import numpy as np

a = np.array([1, 2, 3])
b = np.array([(1.5, 2, 3), (4, 5, 6)], dtype=float)
c = np.array([[(1.5, 2, 3), (4, 5, 6)], [(3, 2, 1), (4, 5, 6)]], dtype=float)
d = np.arange(10, 25, 5)
e = np.full((2, 2), 7)
f = np.eye(2)
g = a - b

配列の作成

1D, 2D, 3D

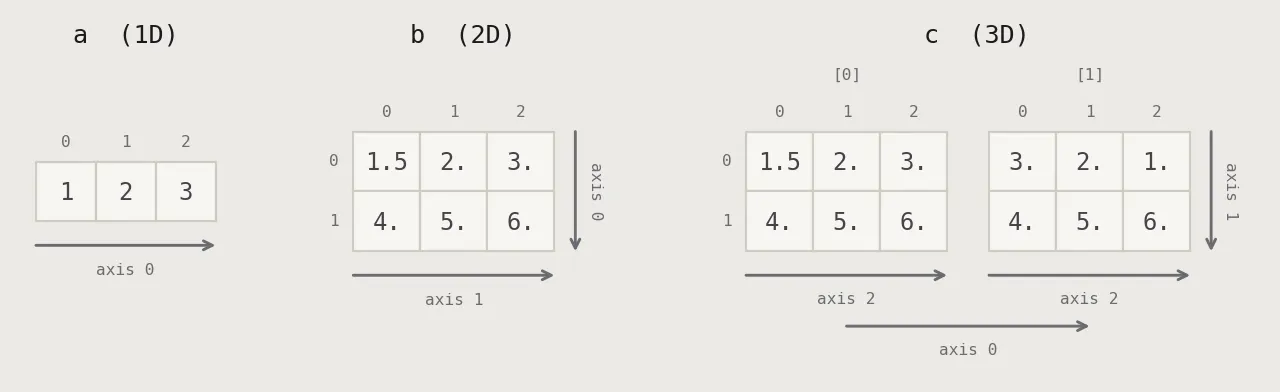
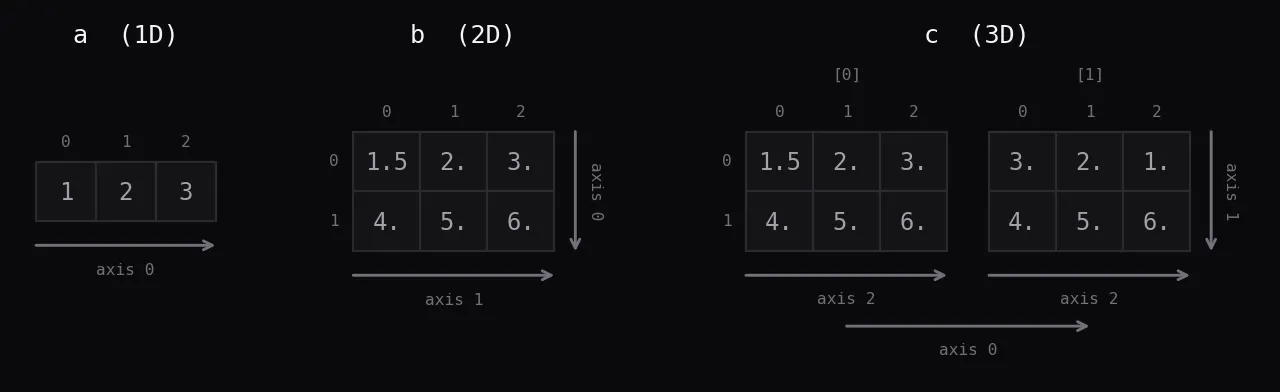
軸は外側から内側へ番号が付き、軸 0 が最初のインデックスです。2D 配列では軸 0 は行をたどり、3D 配列ではブロックをたどります。

a = np.array([1, 2, 3])
b = np.array([(1.5, 2, 3), (4, 5, 6)], dtype=float)
c = np.array([[(1.5, 2, 3), (4, 5, 6)], [(3, 2, 1), (4, 5, 6)]], dtype=float)
軸は外側から内側へ番号が付き、軸 0 が最初のインデックスです。2D 配列では軸 0 は行をたどり、3D 配列ではブロックをたどります。

初期値の配列

np.zeros

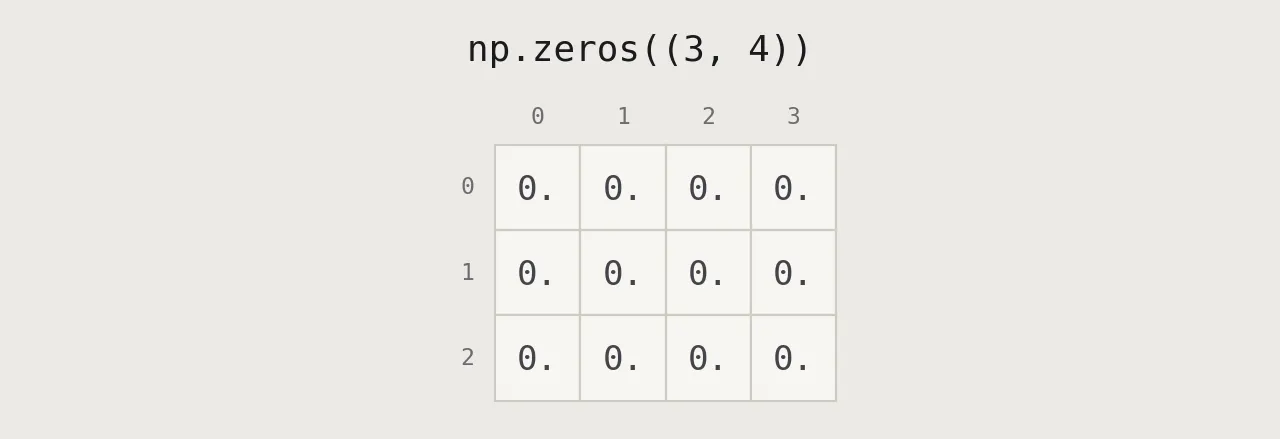
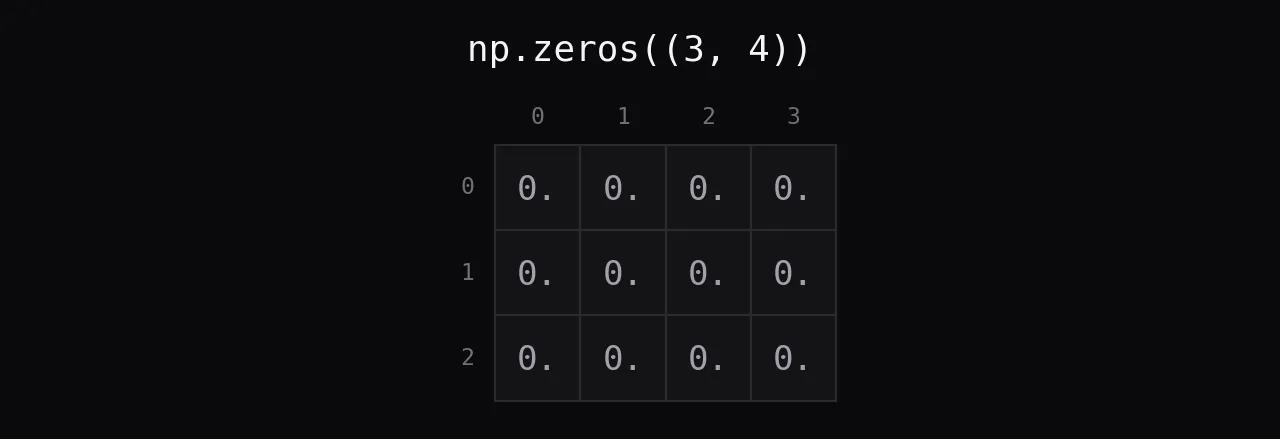
指定した形の配列を 0 で埋めます。既定の型は float64 なので 0. と表示されます。

np.zeros((3, 4))
指定した形の配列を 0 で埋めます。既定の型は float64 なので 0

np.ones

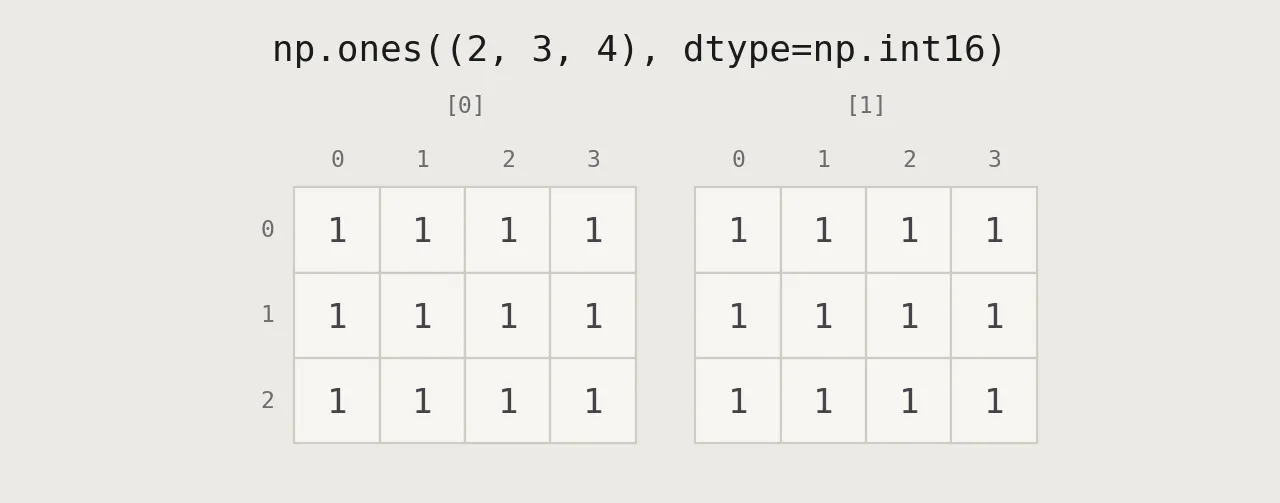
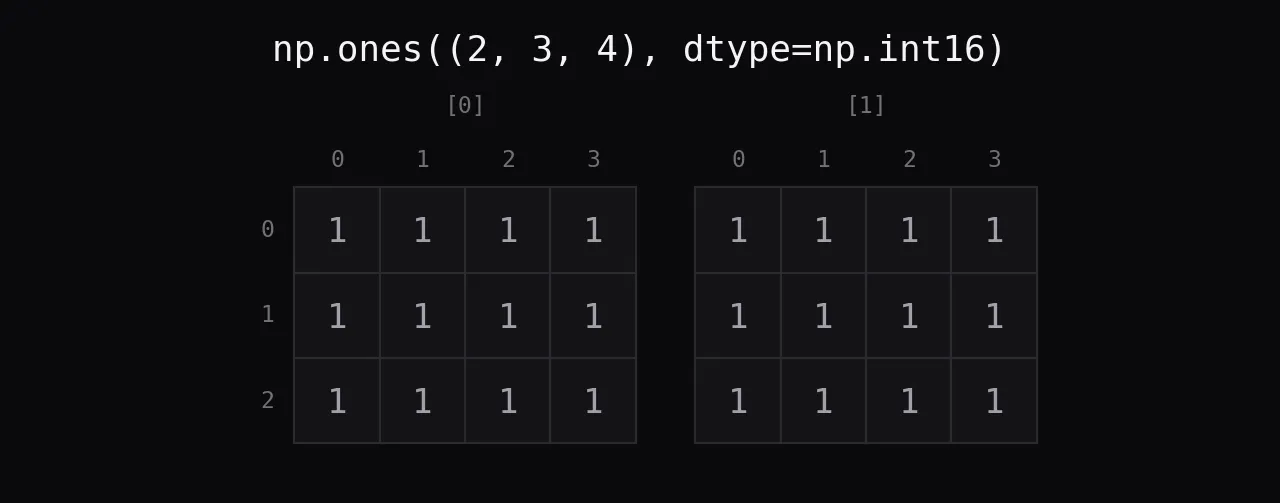
1 で埋めた配列で、ここでは 16 ビット整数です。形 (2, 3, 4) は、3 行 4 列のブロックが 2 つという意味です。

np.ones((2, 3, 4), dtype=np.int16)
1 で埋めた配列で、ここでは 16 ビット整数です。形 (2, 3, 4) は、3 行 4 列のブロックが 2 つという意味です。

np.arange

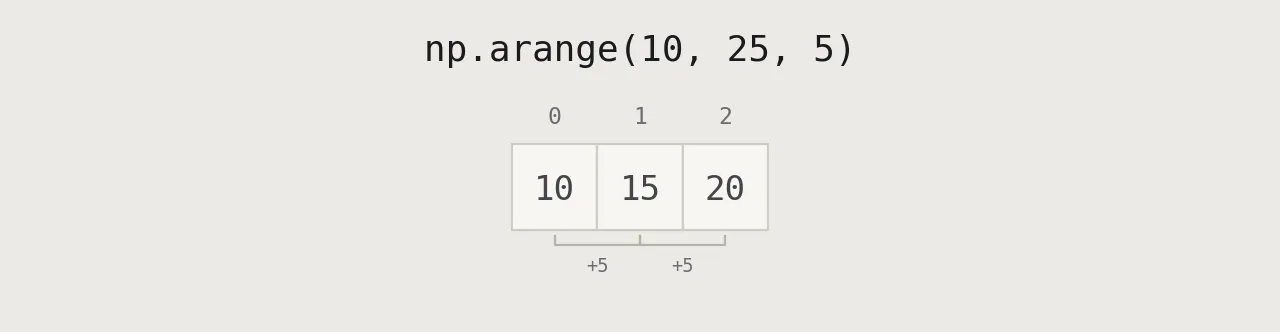
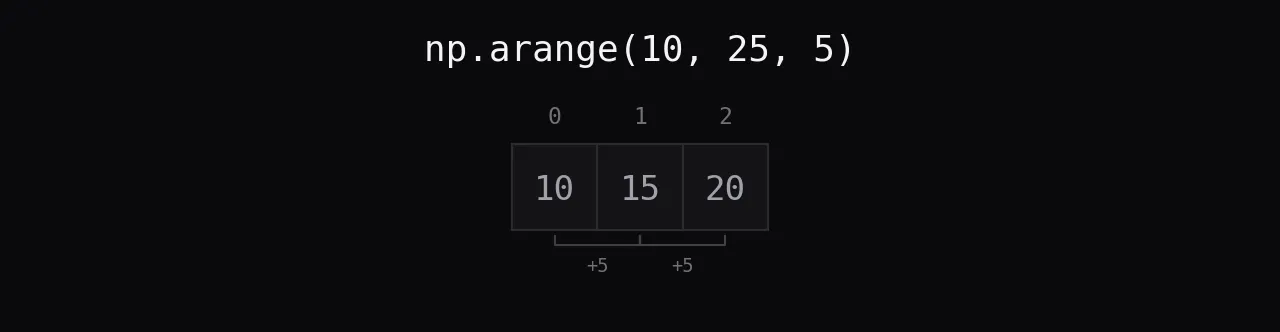
start から stop まで一定の刻みで値を並べます。stop 自体は含まれないので、25 は結果にありません。

d = np.arange(10, 25, 5)
start から stop まで一定の刻みで値を並べます。stop 自体は含まれないので、25 は結果にありません。

np.linspace

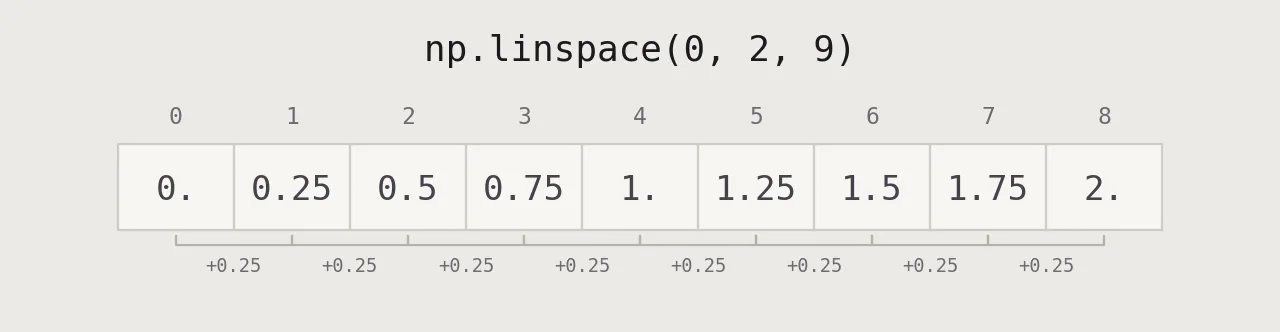
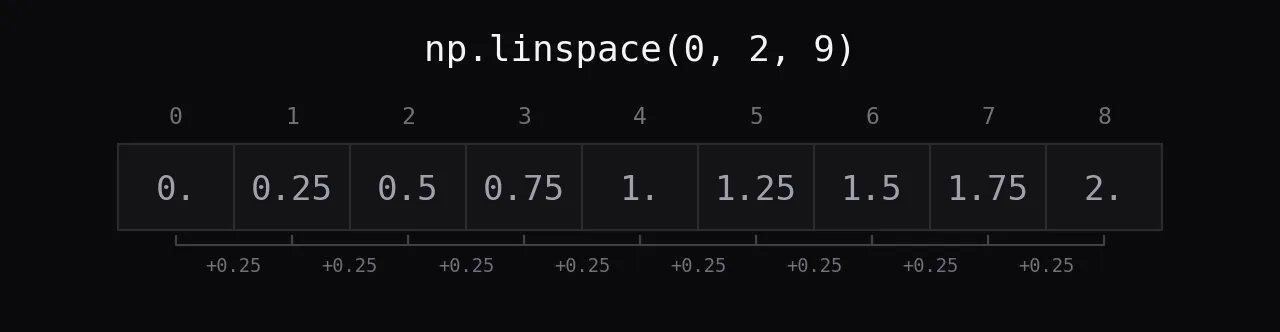
指定した個数の値を等間隔に並べ、両端を含みます。0 から 2 までの 9 点なら刻みは 0.25 です。

np.linspace(0, 2, 9)
指定した個数の値を等間隔に並べ、両端を含みます。0 から 2 までの 9 点なら刻みは 0.25 です。

np.full

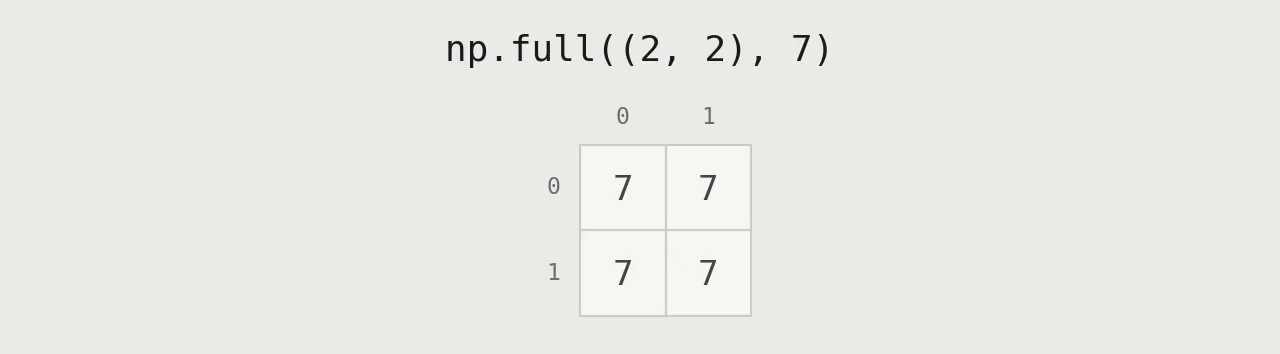
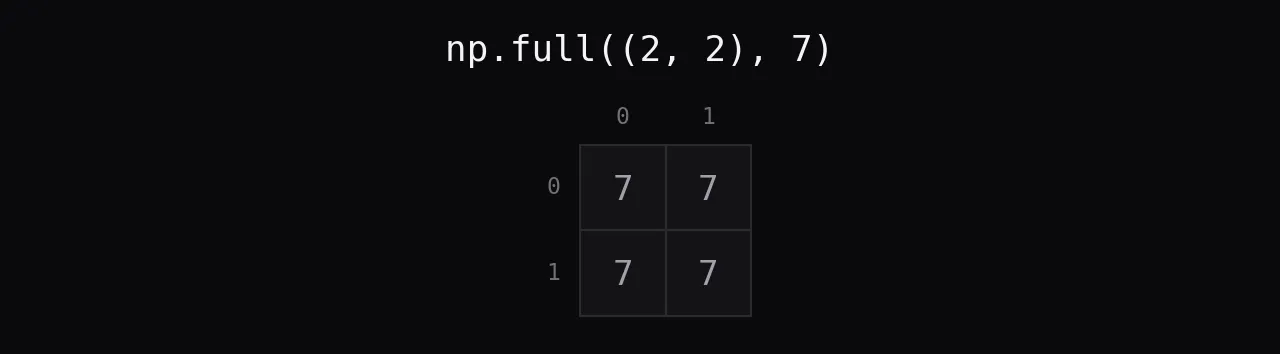
任意の形を一つの定数で埋めます。

e = np.full((2, 2), 7)
任意の形を一つの定数で埋めます。
任意の形を一つの定数で埋めます。

np.eye

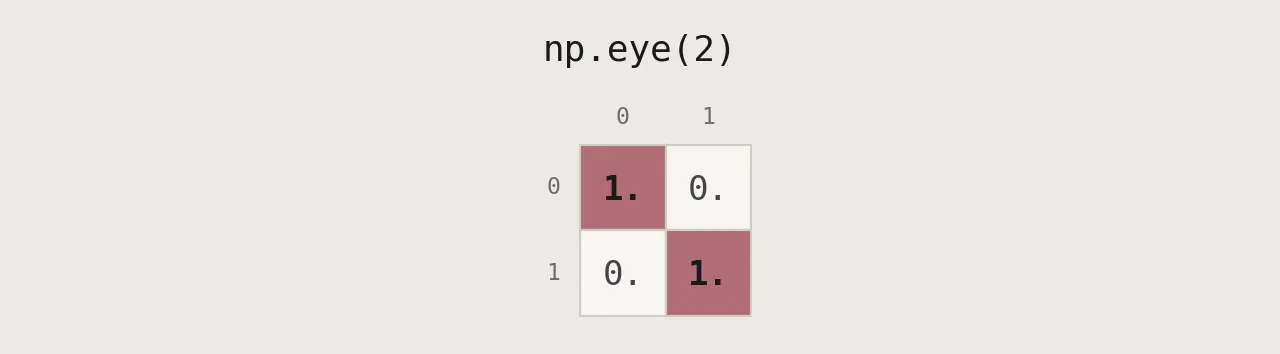
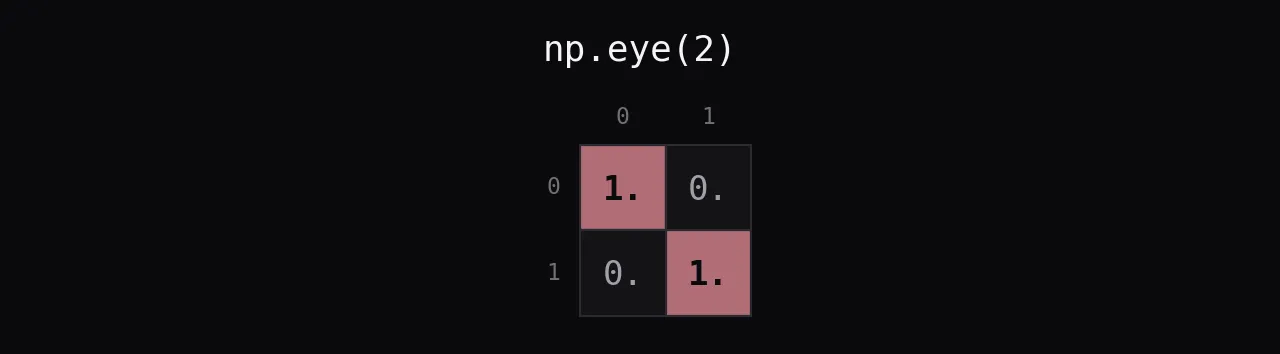
単位行列です。対角線が 1、それ以外が 0 になります。

f = np.eye(2)
単位行列です。対角線が 1、それ以外が 0 になります。

np.random.random

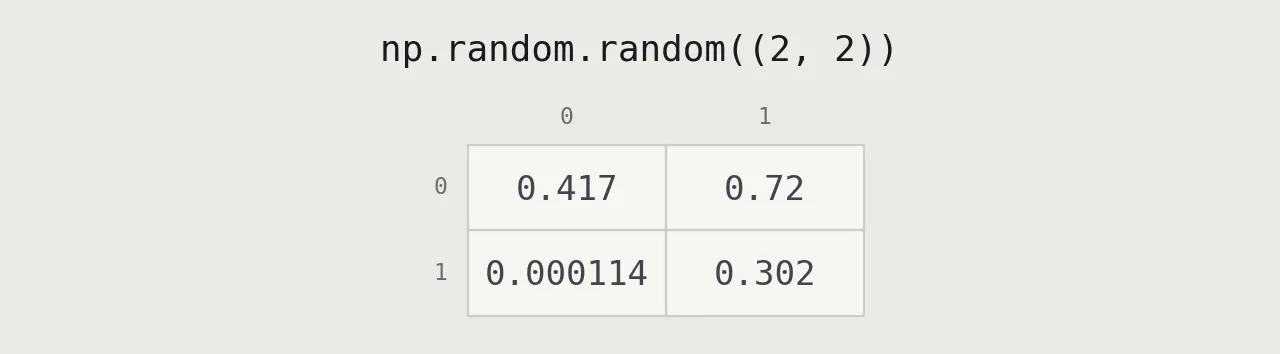
0 以上 1 未満の一様乱数です。新しいコードでは np.random.default_rng().random((2, 2)) と書くのが普通です。

np.random.random((2, 2))
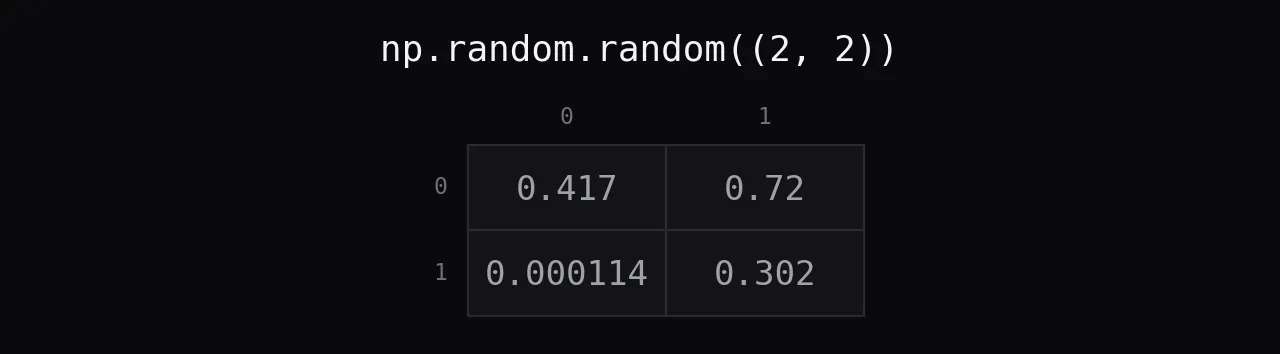
0 以上 1 未満の一様乱数です。新しいコードでは np.random.default_rng().random((2, 2)) と書くのが普通です。

np.empty

メモリを確保するだけで初期化しません。中身はそのメモリに前から残っていた値なので、読む前に必ず値を入れます。

np.empty((3, 2))
メモリを確保するだけで初期化しません。中身はそのメモリに前から残っていた値なので、読む前に必ず値を入れます。

入出力

np.save, np.load

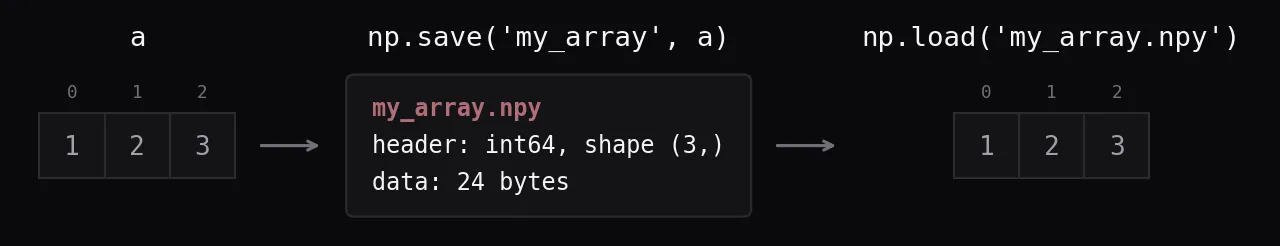
np.save は一つの配列を NumPy のバイナリ形式 .npy で書き出し、拡張子も自分で付けます。ファイルには型と形を書いた小さなヘッダーがあり、その後に生のバイトが続きます。int64 の値 3 つで 24 バイトです。

np.save('my_array', a)
np.load('my_array.npy')
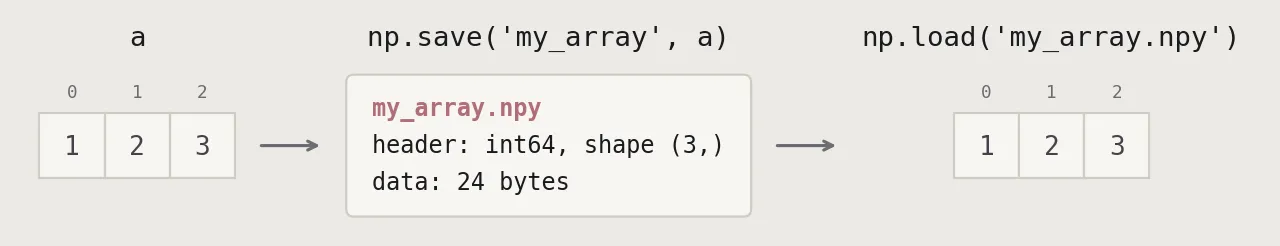
np.save は一つの配列を NumPy のバイナリ形式 .npy で書き出し、拡張子も自分で付けます。ファイルには型と形を書いた小さなヘッダーがあり、その後に生のバイトが続きます。int64 の値 3 つで 24 バイトです。

np.savez

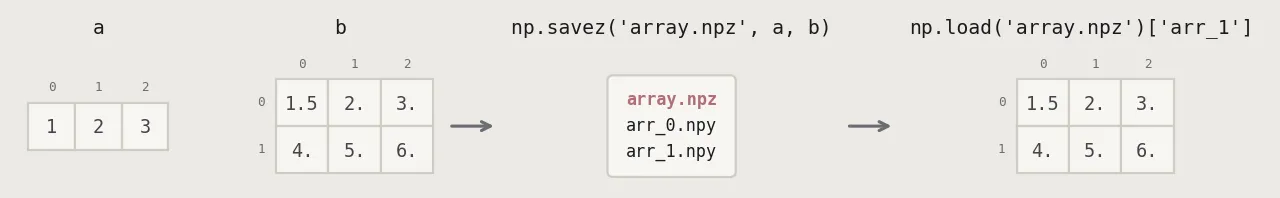
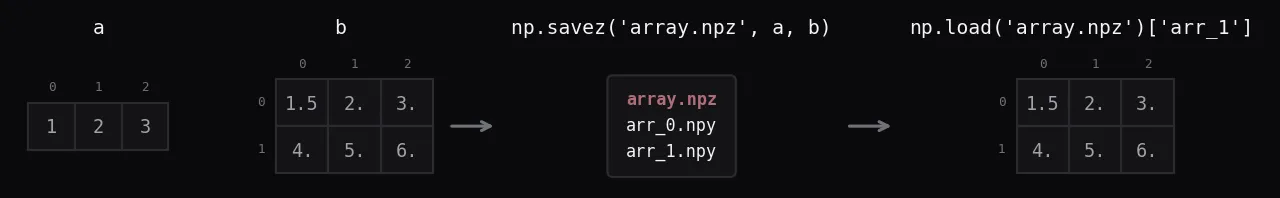
複数の配列を非圧縮の .npz アーカイブにまとめます。位置で渡した配列には arr_0、arr_1 … という名前が付きます。名前を決めたいときは np.savez('array.npz', a=a, b=b) のようにキーワードで渡します。圧縮するなら np.savez_compressed です。

np.savez('array.npz', a, b)
np.load('array.npz')['arr_1']
複数の配列を非圧縮の .npz アーカイブにまとめます。位置で渡した配列には arr_0、arr_1 … という名前が付きます。名前を決めたいときは np.savez('array.npz', a=a, b=b) のようにキーワードで渡します。圧縮するなら np.savez_compressed です。

np.savetxt, np.loadtxt

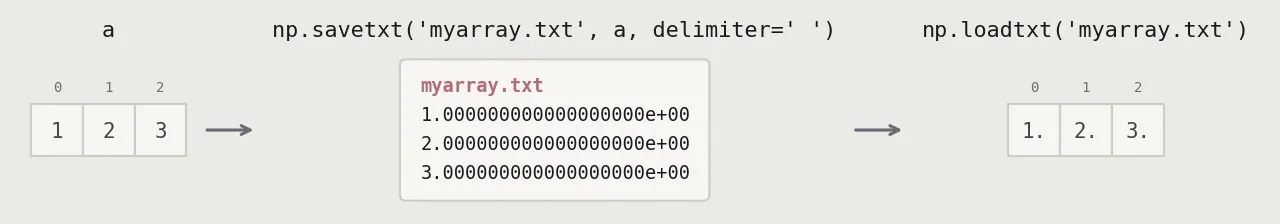
プレーンテキストで、配列の 1 行がファイルの 1 行になります。既定の書式は %.18e なので数はすべて浮動小数点で書かれ、loadtxt も浮動小数点で読み戻します。整数で書くなら fmt='%d' を渡します。

np.savetxt('myarray.txt', a, delimiter=' ')
np.loadtxt('myarray.txt')
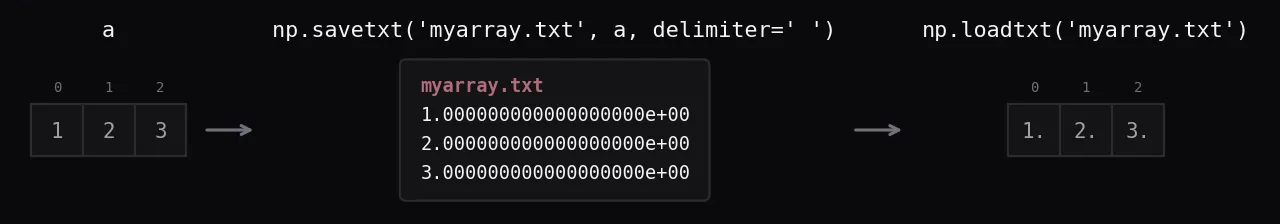
プレーンテキストで、配列の 1 行がファイルの 1 行になります。既定の書式は %.18e なので数はすべて浮動小数点で書かれ、loadtxt も浮動小数点で読み戻します。整数で書くなら fmt='%d' を渡します。

np.genfromtxt

loadtxt と似ていますが、欠損値を扱えます。空のフィールドは nan になります。

np.genfromtxt('my_file.csv', delimiter=',')
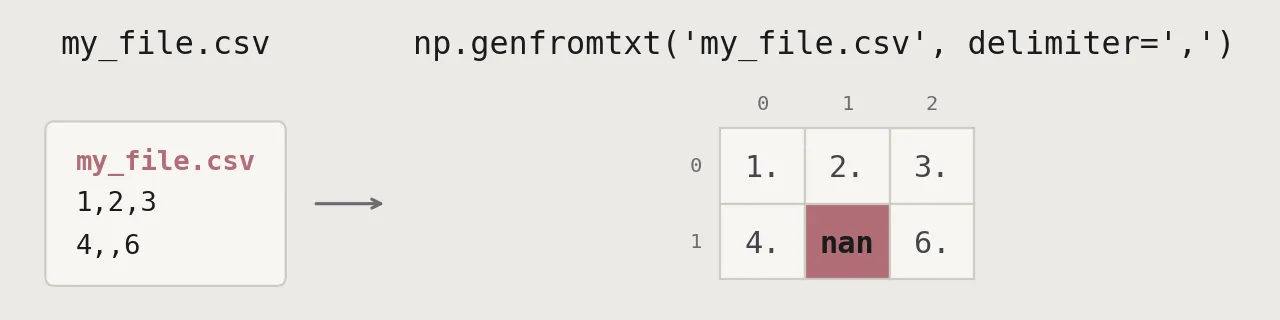
loadtxt と似ていますが、欠損値を扱えます。空のフィールドは nan になります。

データ型

dtypes

型は 1 要素が何バイトを占めるかを決めます。元のチートシートのいくつかの名前は NumPy 2 で削除されました。np.complex、np.object、np.string_、np.unicode_ は、今は np.complex128、np.object_、np.bytes_、np.str_ です。また、チートシートは float32 を倍精度としていますが、実際は単精度で、倍精度は float64 です。object 配列は 8 バイトのポインタを持ち、unicode 文字列は 1 文字 4 バイトを使います。

np.int64       # signed 64-bit integer
np.float32     # single-precision float
np.complex128  # complex number, two float64
np.bool        # True / False
np.object_     # any Python object
np.bytes_      # fixed-length byte string, e.g. 'S5'
np.str_        # fixed-length unicode string, e.g. 'U5'
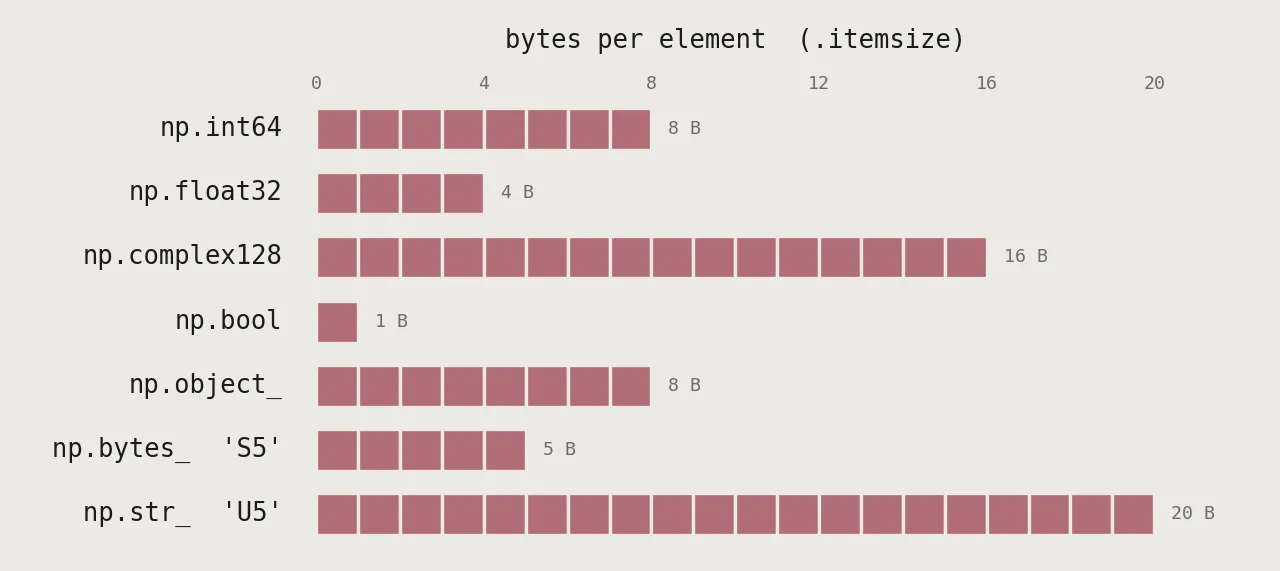
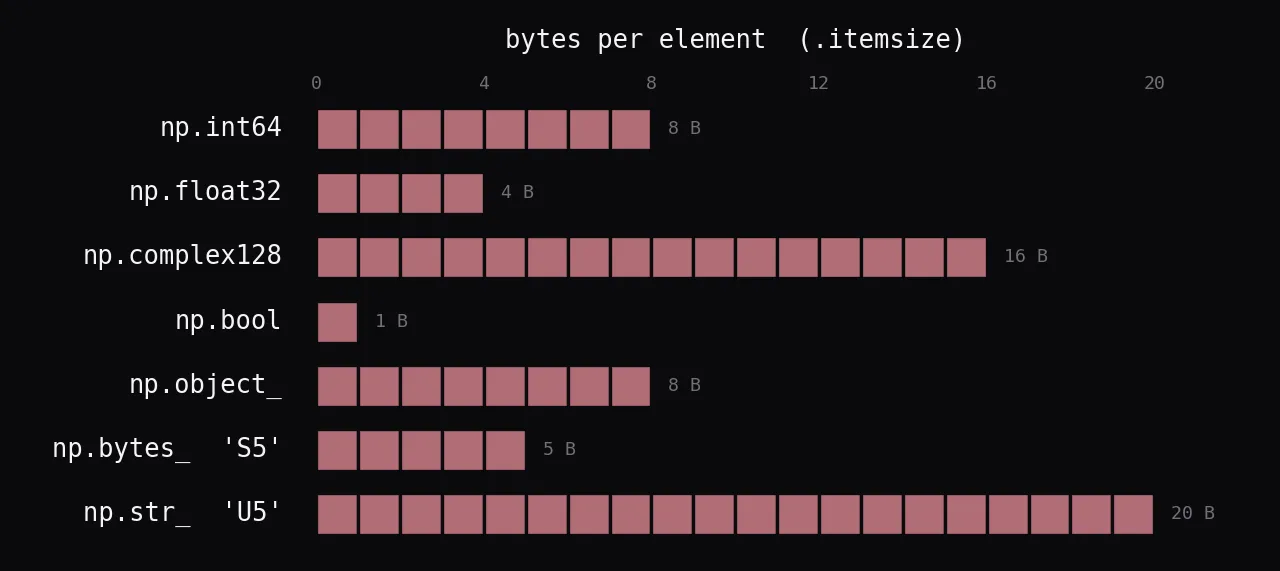
型は 1 要素が何バイトを占めるかを決めます。元のチートシートのいくつかの名前は NumPy 2 で削除されました。np.complex、np.object、np.string_、np.unicode_ は、今は np.complex128、np.object_、np.bytes_、np.str_ です。また、チートシートは float32 を倍精度としていますが、実際は単精度で、倍精度は float64 です。object 配列は 8 バイトのポインタを持ち、unicode 文字列は 1 文字 4 バイトを使います。

配列を調べる

a.shape

各軸の長さをタプルで返します。1D 配列なら要素が一つのタプルです。

a.shape
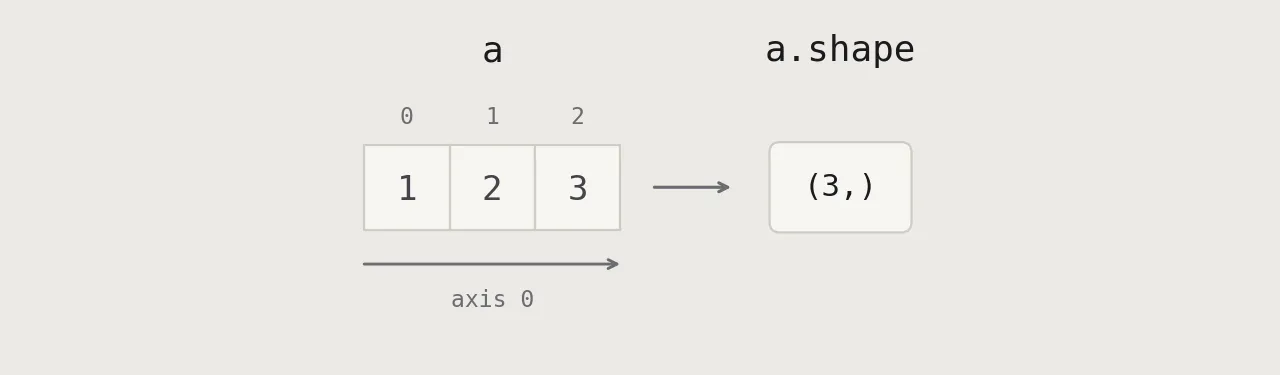
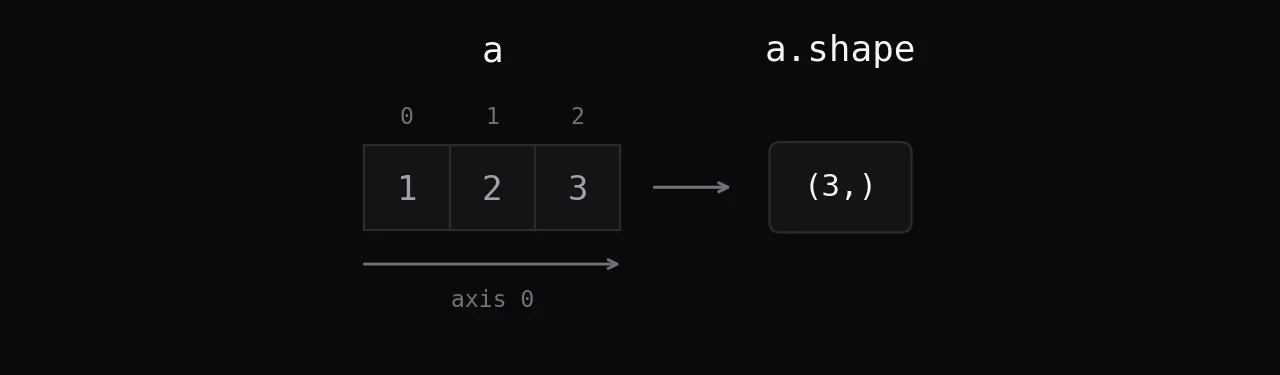
各軸の長さをタプルで返します。1D 配列なら要素が一つのタプルです。

len

len は最初の軸だけを数えます。2D 配列なら要素数ではなく行数になります。

len(b)    # len(a) is 3
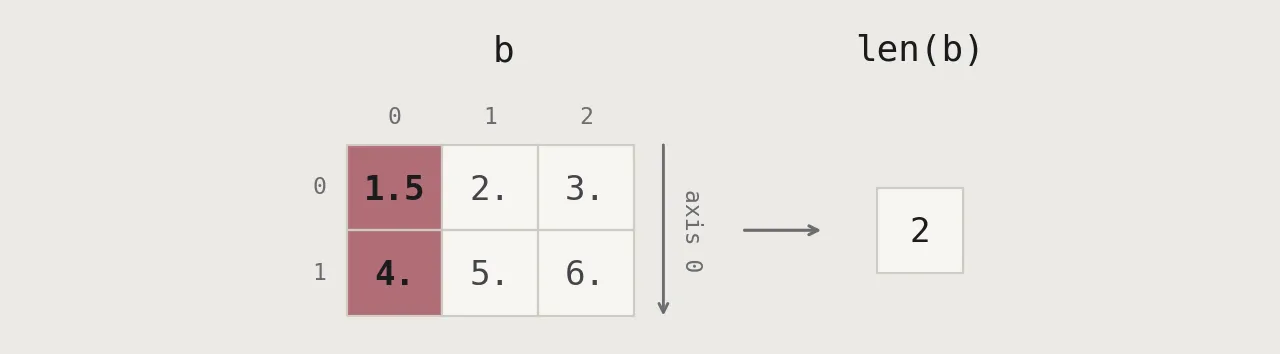
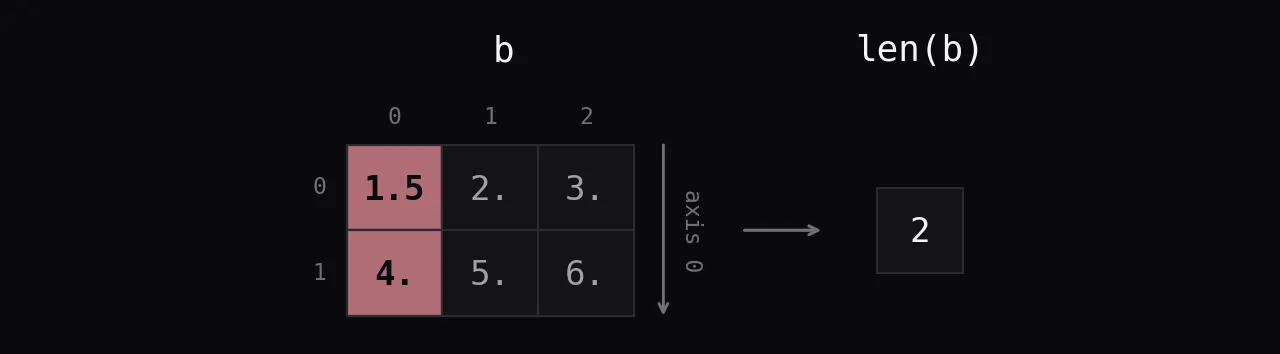
len は最初の軸だけを数えます。2D 配列なら要素数ではなく行数になります。

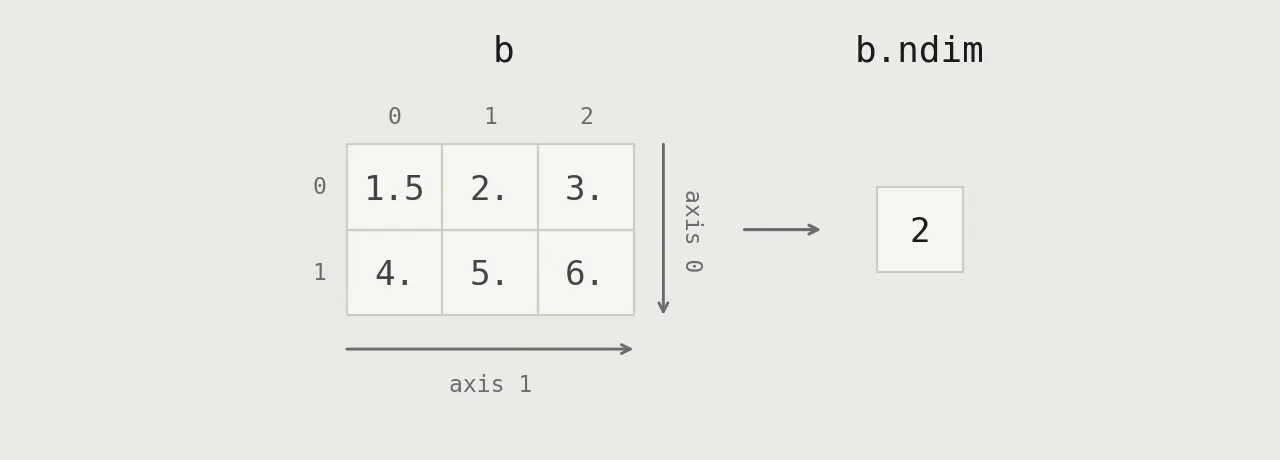
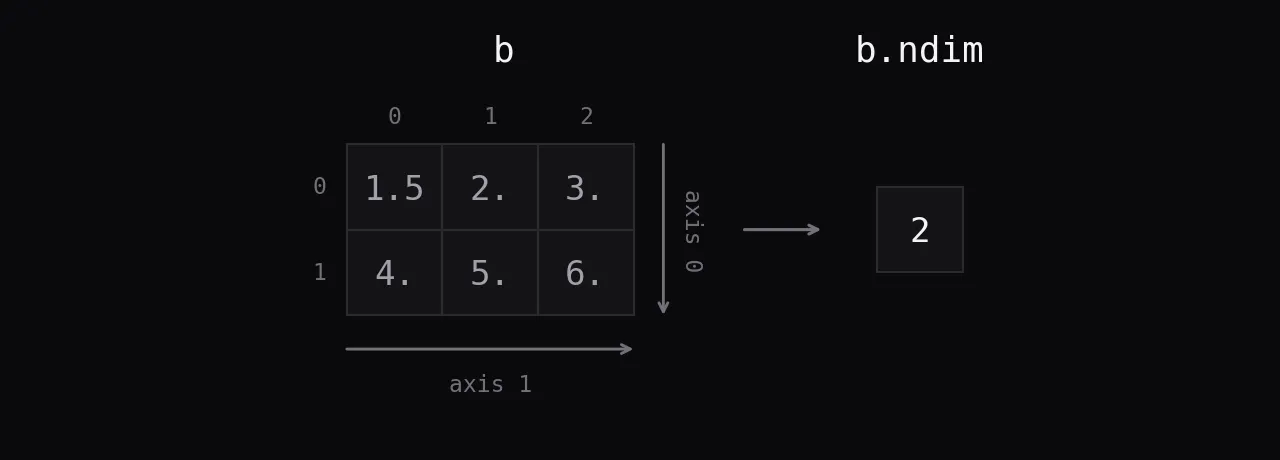
b.ndim

軸の数です。

b.ndim
軸の数です。
軸の数です。

e.size

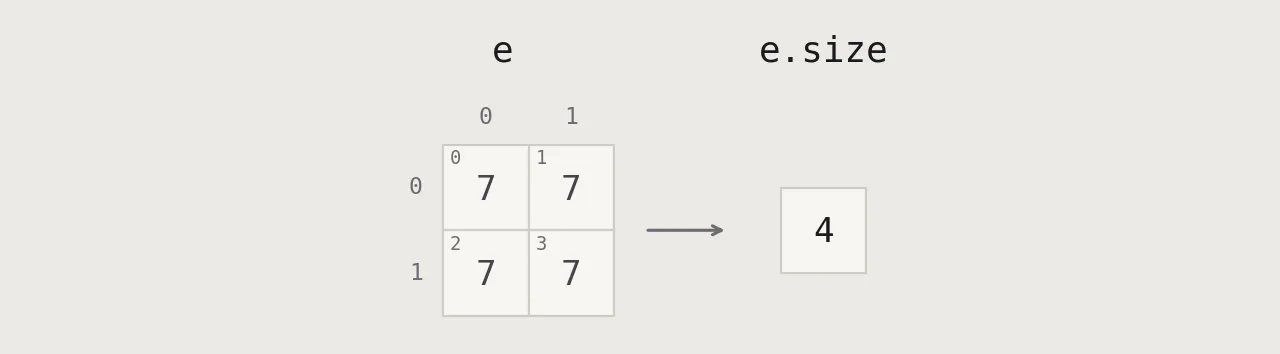
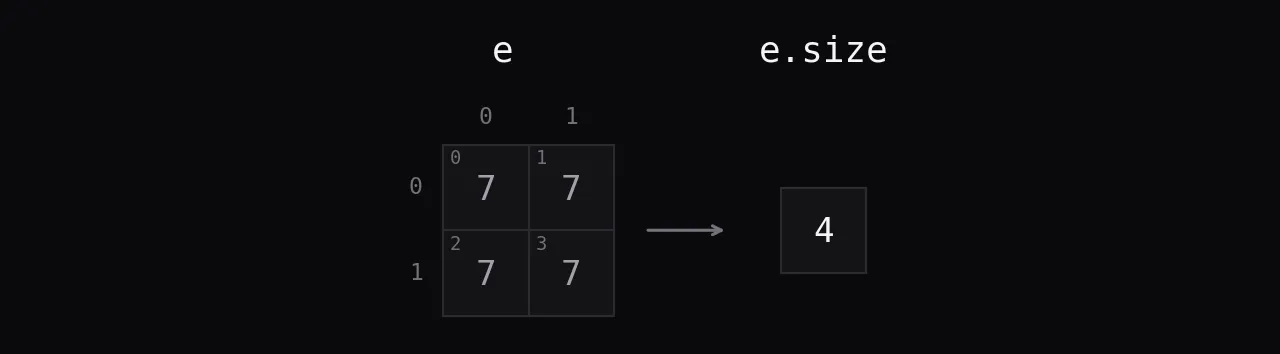
要素の総数で、形の各値の積です。

e.size
要素の総数で、形の各値の積です。
要素の総数で、形の各値の積です。

b.dtype

要素の型を、dtype オブジェクトとその名前で返します。

b.dtype
b.dtype.name
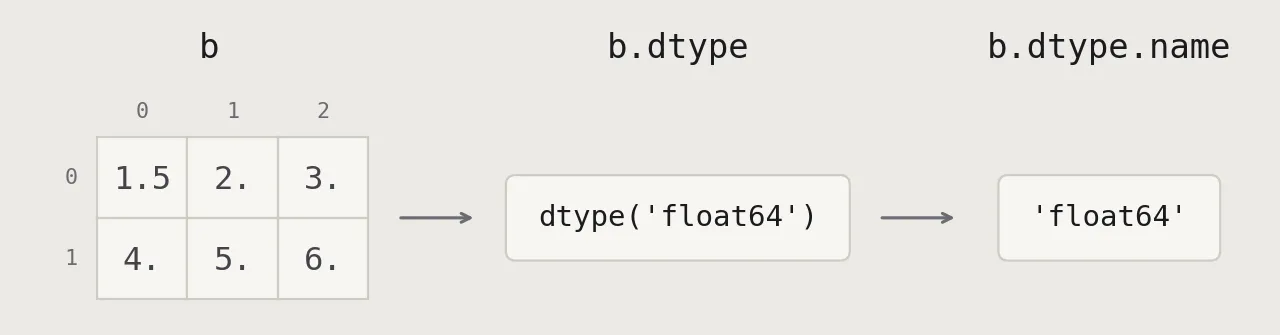
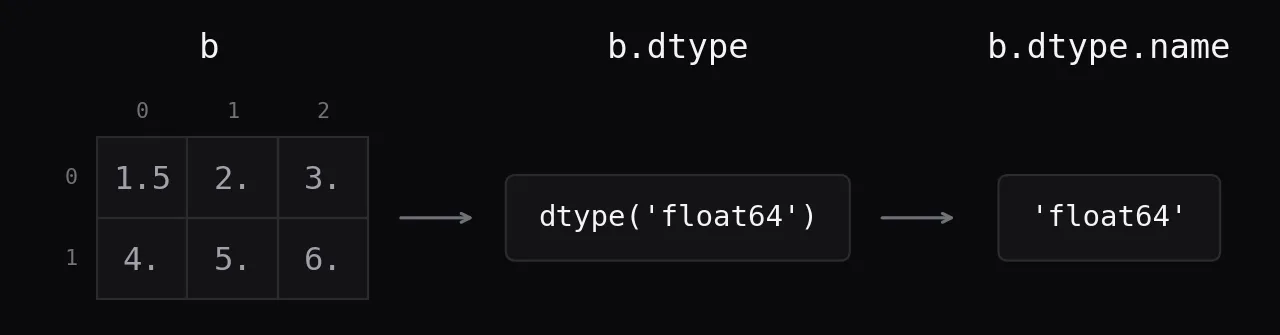
要素の型を、dtype オブジェクトとその名前で返します。

b.astype

別の型に変換したコピーを返します。float から int へは 0 方向に切り捨てるので、1.5 は 1 になります。

b.astype(int)
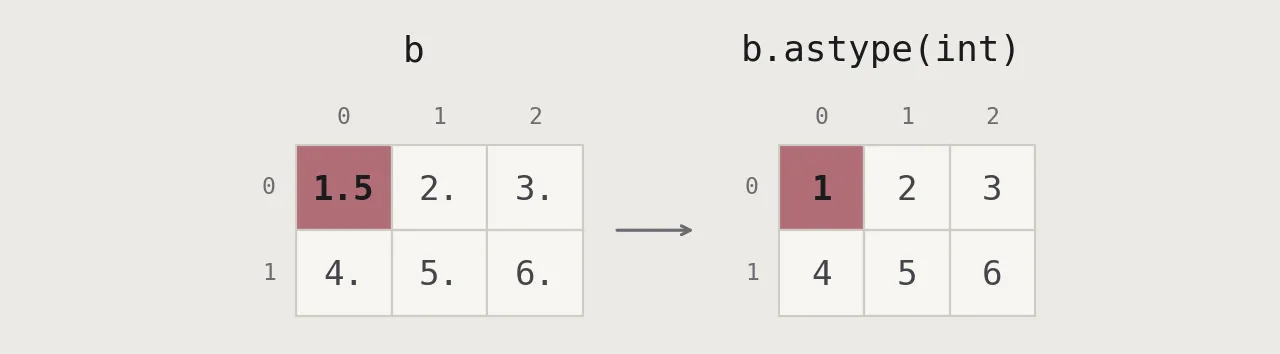
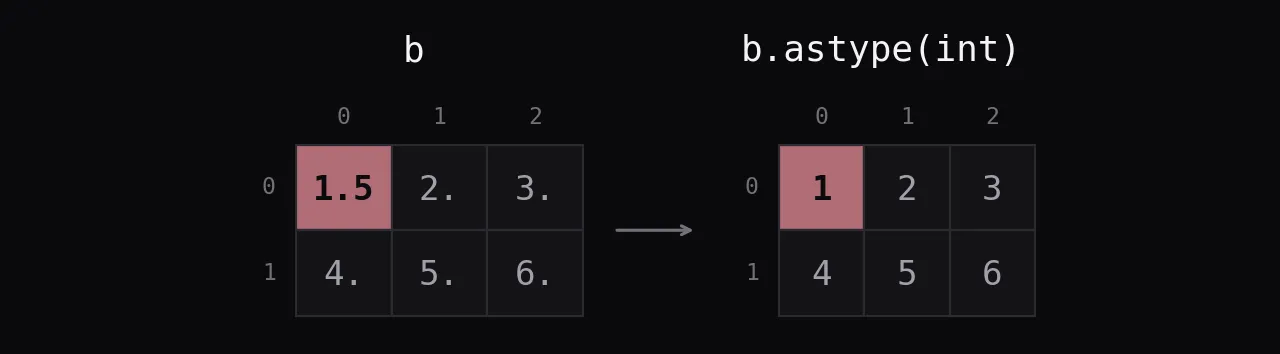
別の型に変換したコピーを返します。float から int へは 0 方向に切り捨てるので、1.5 は 1 になります。

ヘルプ

np.info

NumPy の任意のオブジェクトのドキュメントを表示します。help() も使えます。

np.info(np.ndarray.dtype)
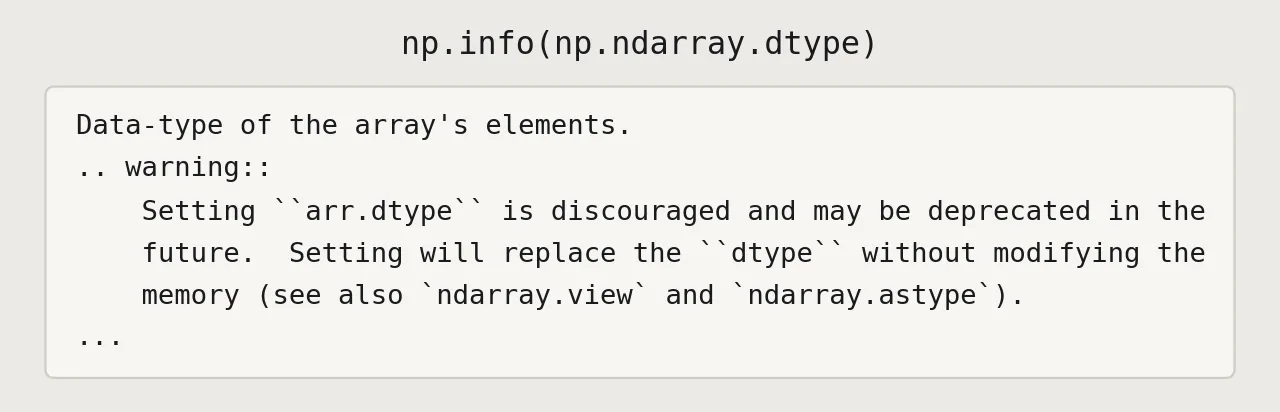
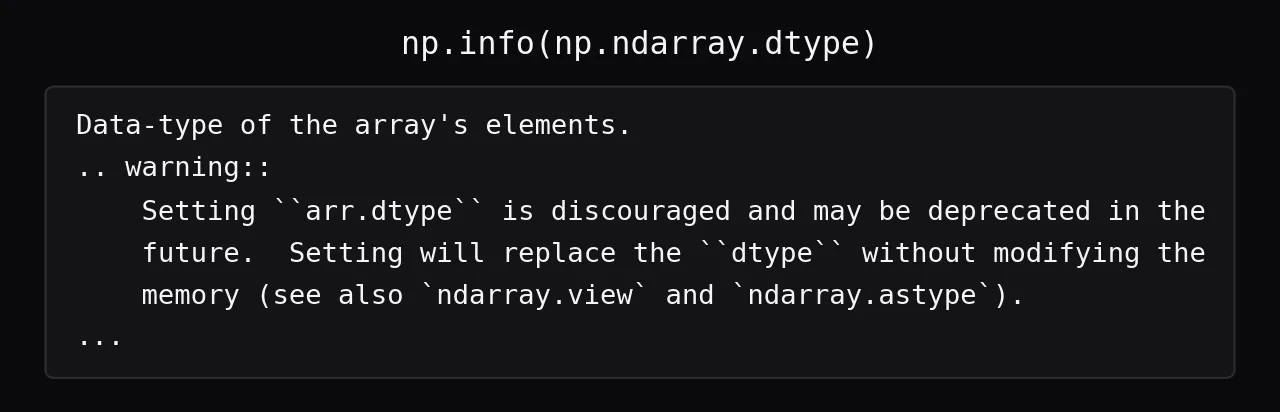
NumPy の任意のオブジェクトのドキュメントを表示します。help() も使えます。

算術演算

a - b

要素ごとの演算です。a の形は (3,)、b は (2, 3) なので、NumPy は a を b の各行にブロードキャストします(点線の行)。関数の形でも同じ演算です。

g = a - b
np.subtract(a, b)
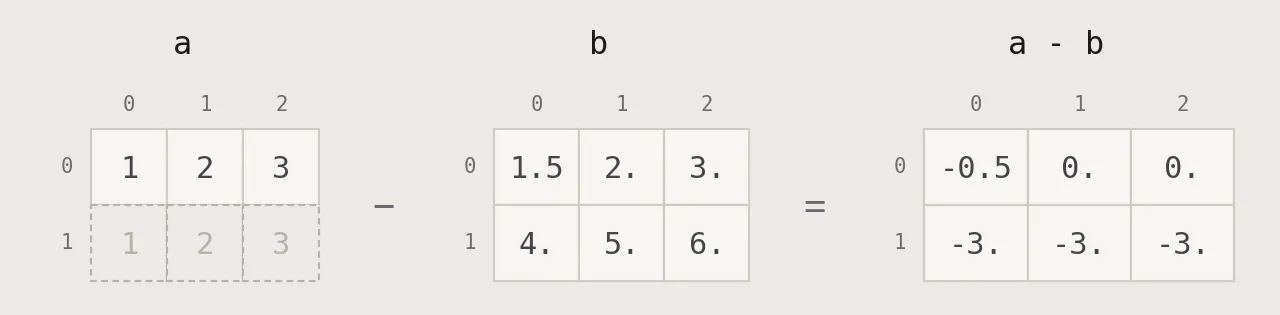
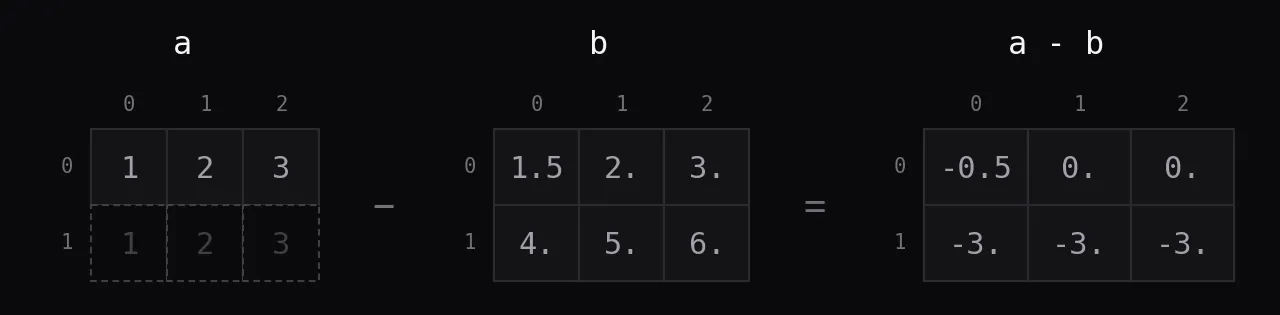
要素ごとの演算です。a の形は (3,)、b は (2, 3) なので、NumPy は a を b の各行にブロードキャストします(点線の行)。関数の形でも同じ演算です。

b + a

加算も同じようにブロードキャストされます。ブロードキャストではオペランドの順序は関係ありません。

b + a
np.add(b, a)
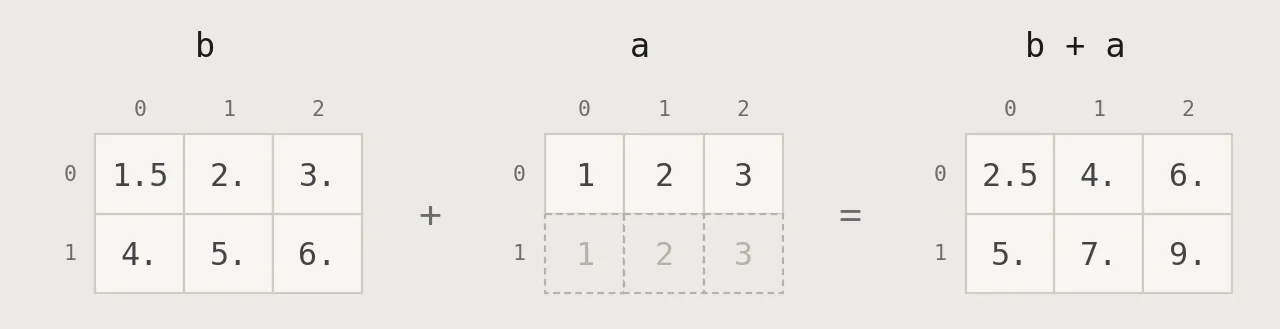
加算も同じようにブロードキャストされます。ブロードキャストではオペランドの順序は関係ありません。

a / b

/ は整数配列どうしでも必ず浮動小数点を返します。整数除算は // です。

a / b
np.divide(a, b)
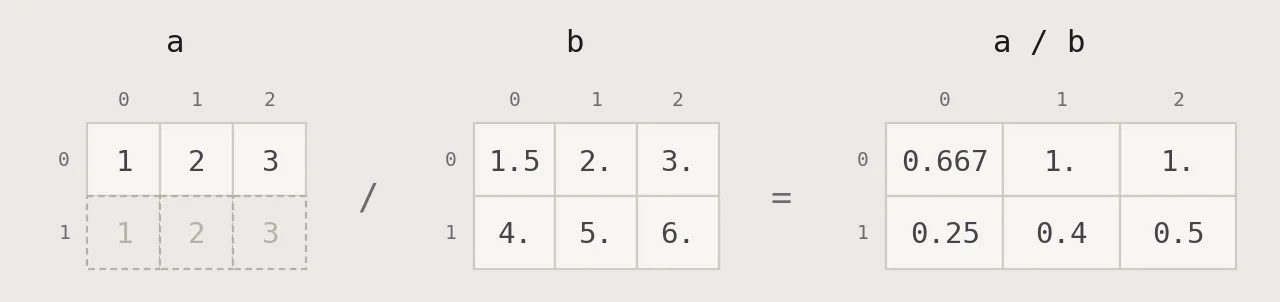
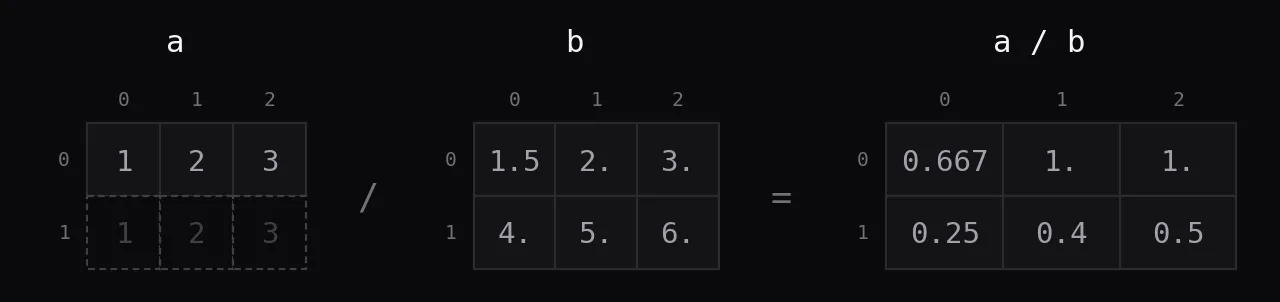
/ は整数配列どうしでも必ず浮動小数点を返します。整数除算は // です。

a * b

* は要素ごとの掛け算です。行列積ではありません。行列積は下の dot か @ です。

a * b
np.multiply(a, b)
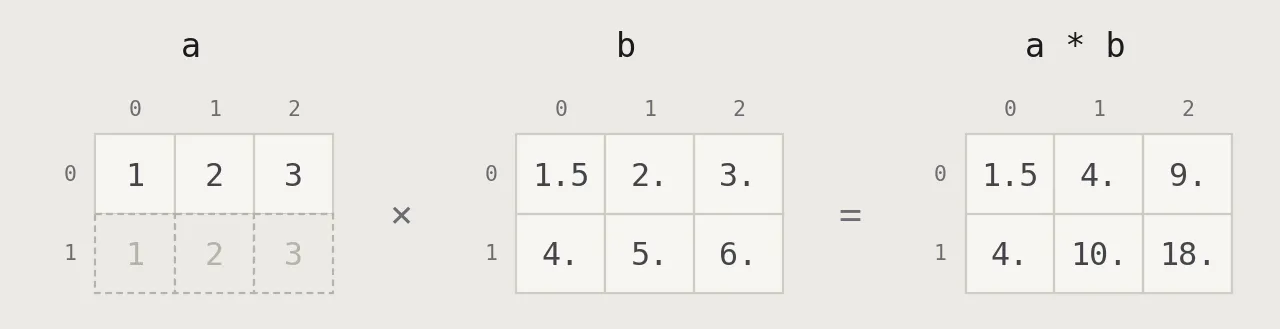
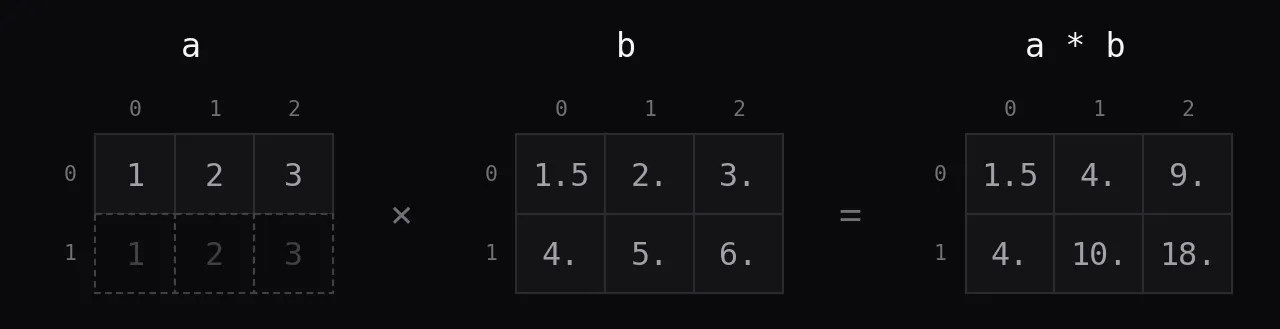
* は要素ごとの掛け算です。行列積ではありません。行列積は下の dot か @ です。

np.exp

要素ごとの数学関数は形を変えません。これは各要素を指数とする e のべき乗です。

np.exp(b)
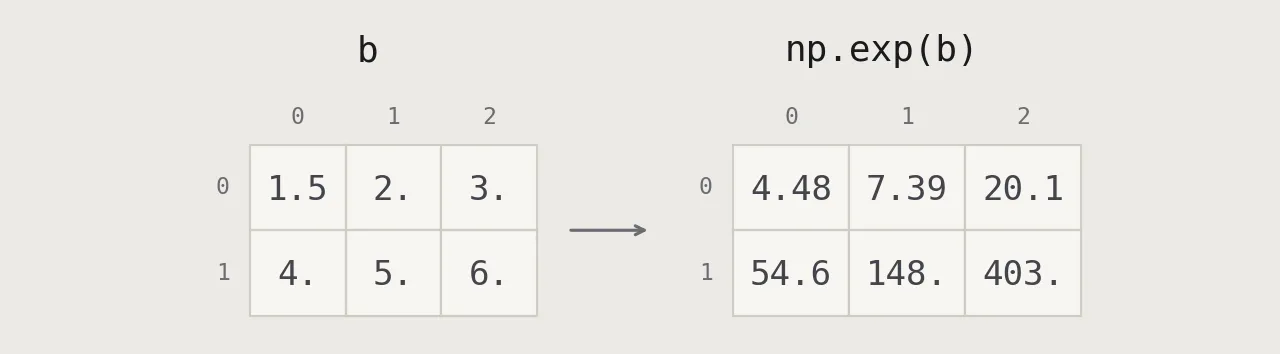
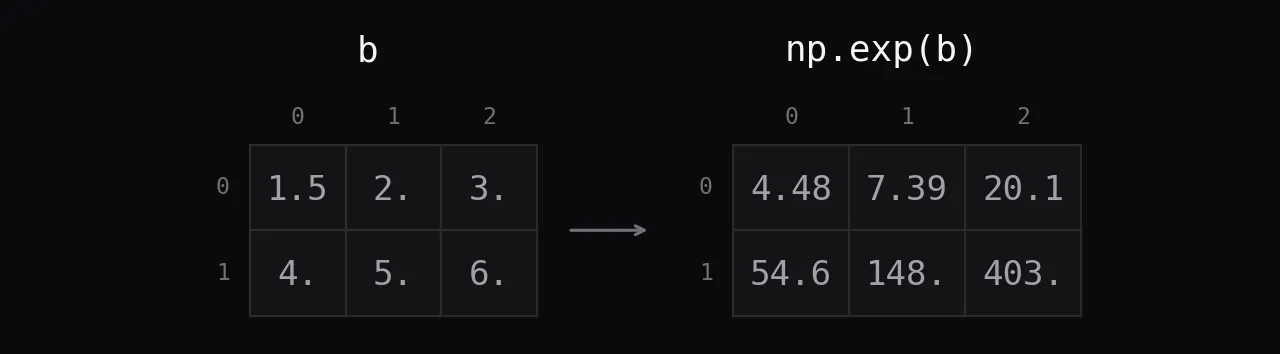
要素ごとの数学関数は形を変えません。これは各要素を指数とする e のべき乗です。

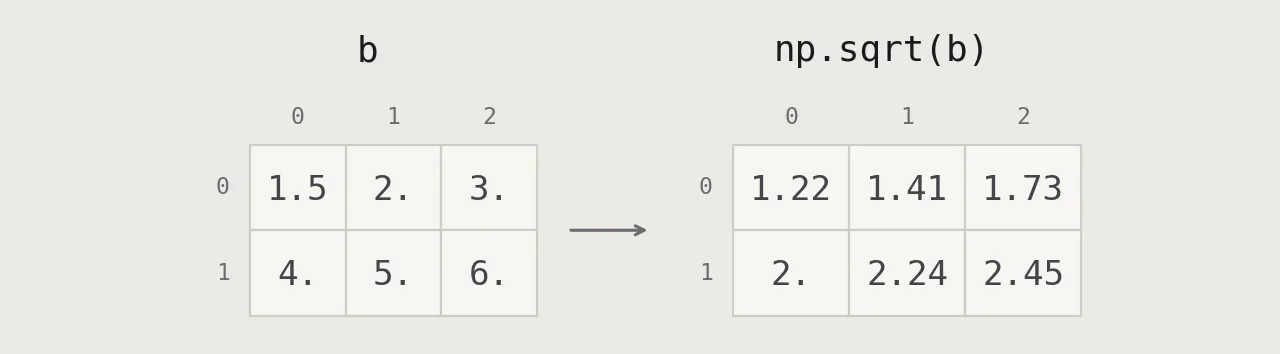
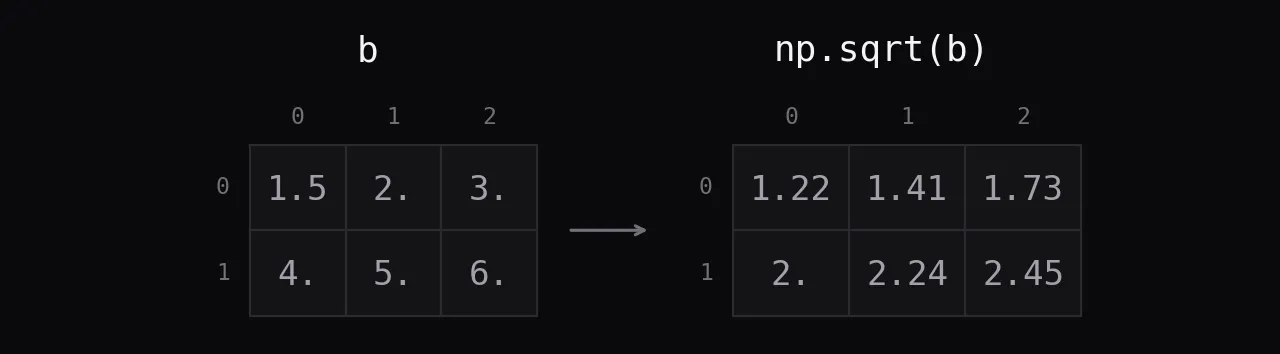
np.sqrt

各要素の平方根です。

np.sqrt(b)
各要素の平方根です。
各要素の平方根です。

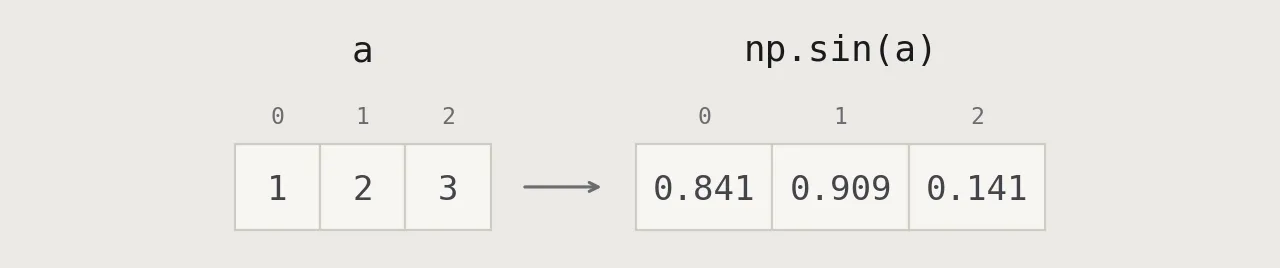
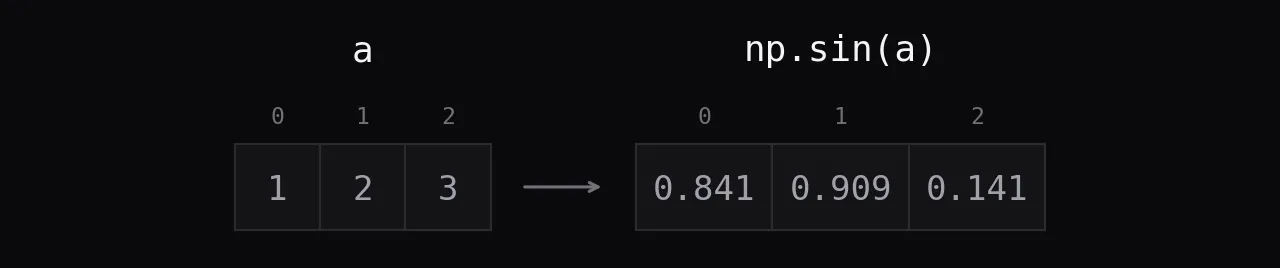
np.sin

各要素の正弦です。単位はラジアンです。

np.sin(a)
各要素の正弦です。単位はラジアンです。
各要素の正弦です。単位はラジアンです。

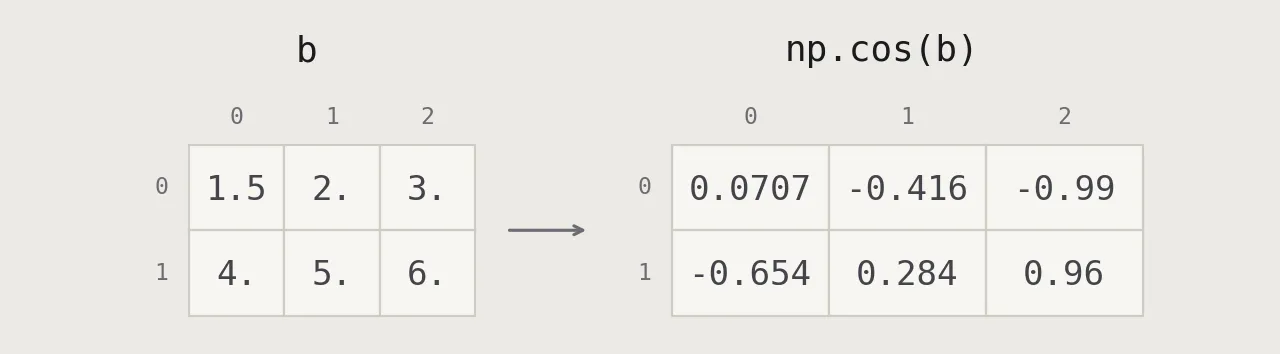
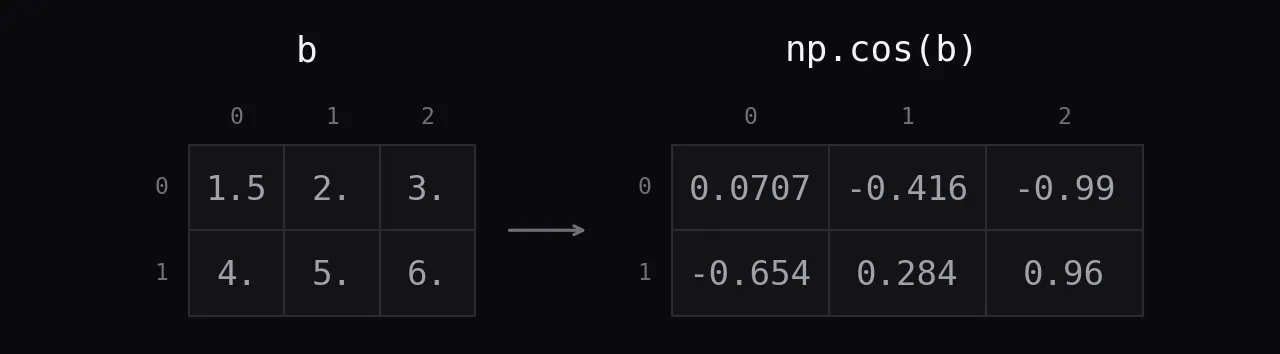
np.cos

各要素の余弦です。単位はラジアンです。

np.cos(b)
各要素の余弦です。単位はラジアンです。
各要素の余弦です。単位はラジアンです。

np.log

各要素の自然対数で、log(1) は 0 です。底が違うものは np.log10 と np.log2 です。

np.log(a)
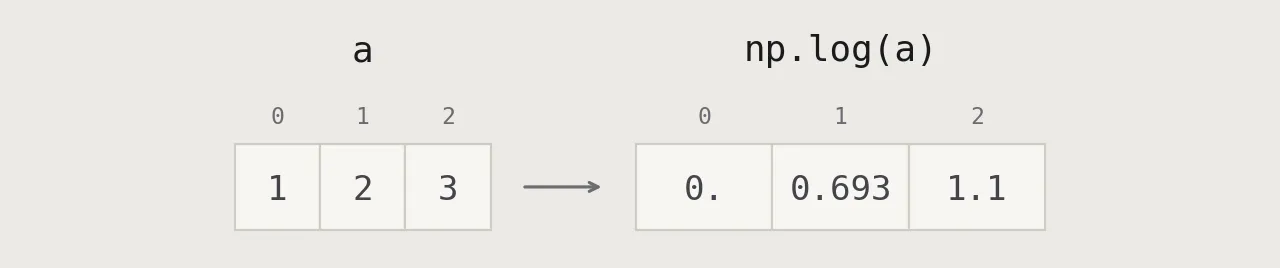
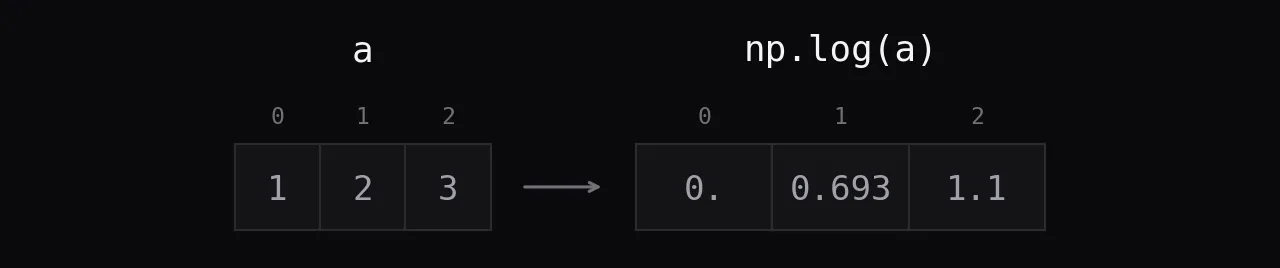
各要素の自然対数で、log(1) は 0 です。底が違うものは np.log10 と np.log2 です。

e.dot(f)

行列積です。結果の各セルは、e の行と f の列を掛けて足したものです。f は単位行列なので、結果は e と同じになります。

e.dot(f)
e @ f
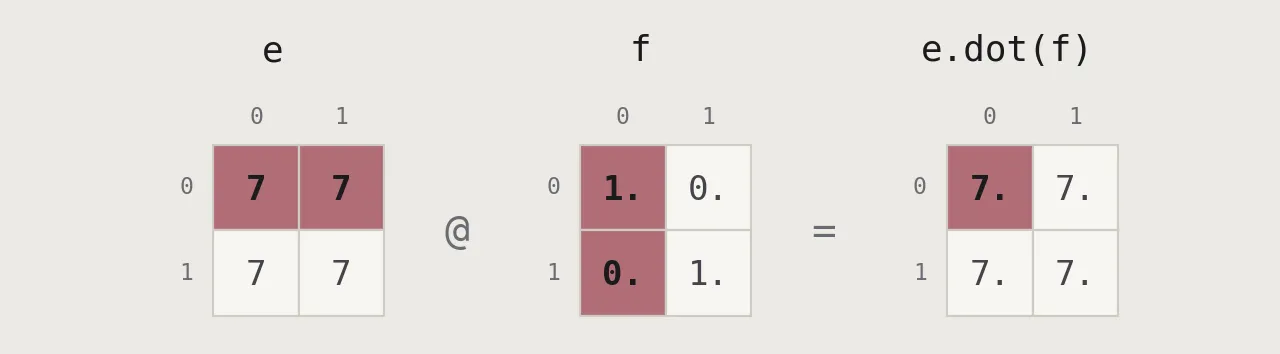
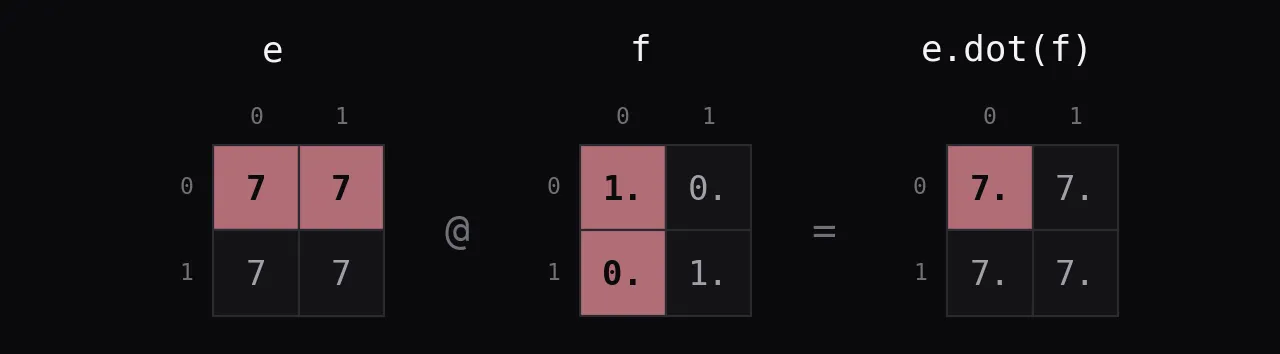
行列積です。結果の各セルは、e の行と f の列を掛けて足したものです。f は単位行列なので、結果は e と同じになります。

比較

a == b

要素ごとの比較は bool 配列を返し、算術演算と同じようにブロードキャストされます。

a == b
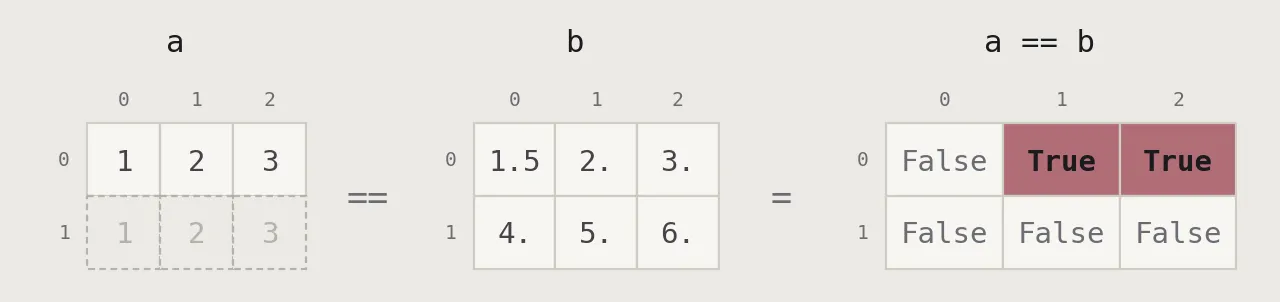
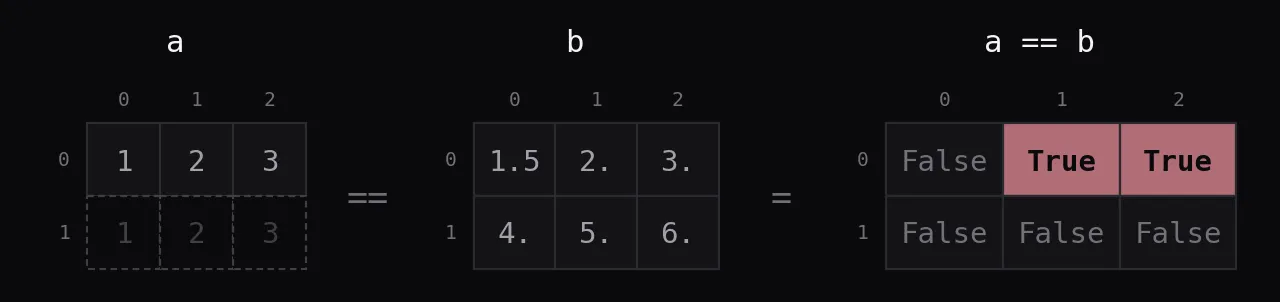
要素ごとの比較は bool 配列を返し、算術演算と同じようにブロードキャストされます。

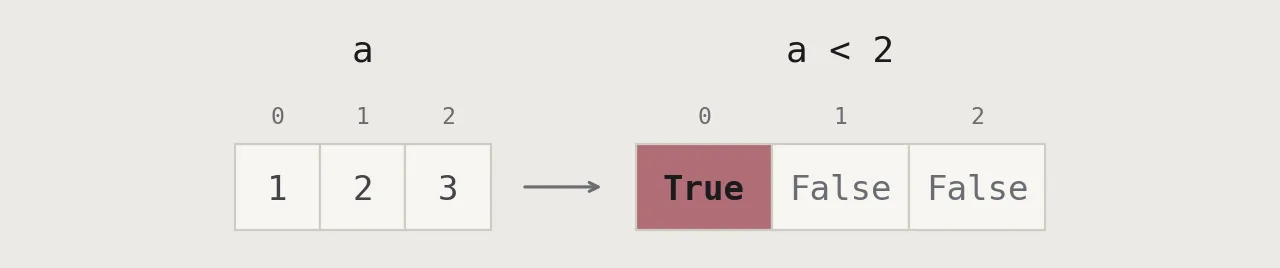
a < 2

数と比べると、すべての要素がその数と比べられます。

a < 2
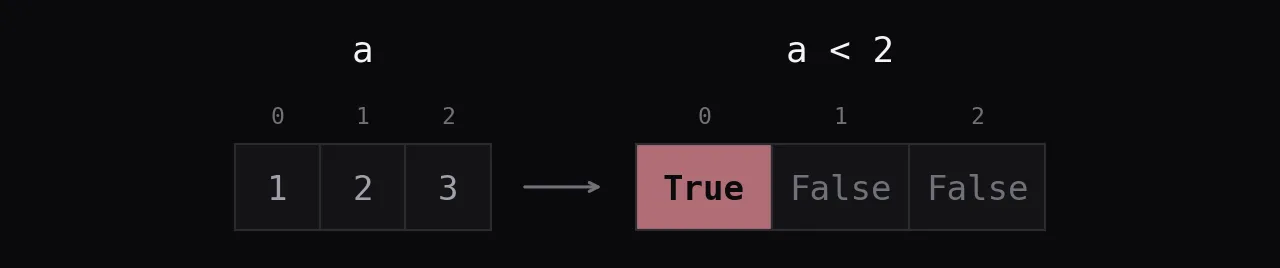
数と比べると、すべての要素がその数と比べられます。

np.array_equal

配列全体で一つの bool を返します。形とすべての値が一致したときだけ True です。ここでは形が違います。

np.array_equal(a, b)
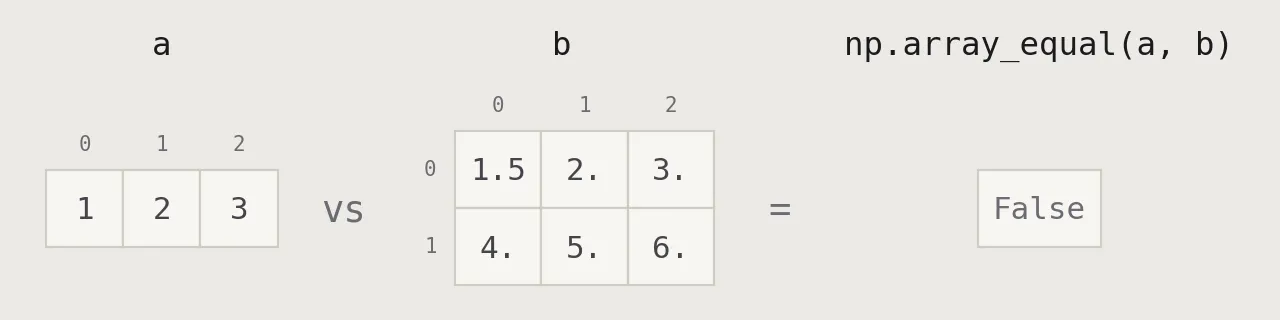
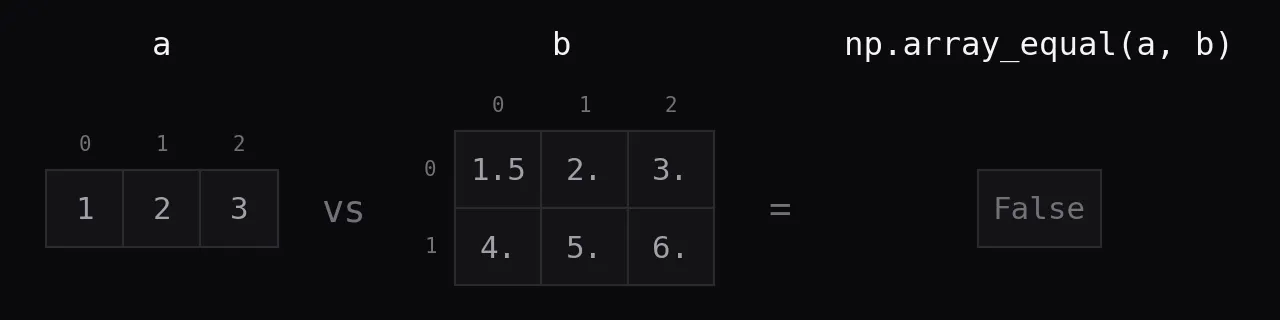
配列全体で一つの bool を返します。形とすべての値が一致したときだけ True です。ここでは形が違います。

集約関数

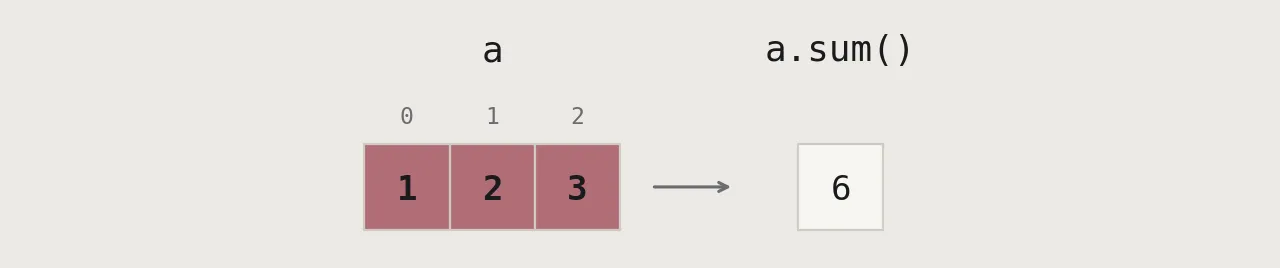
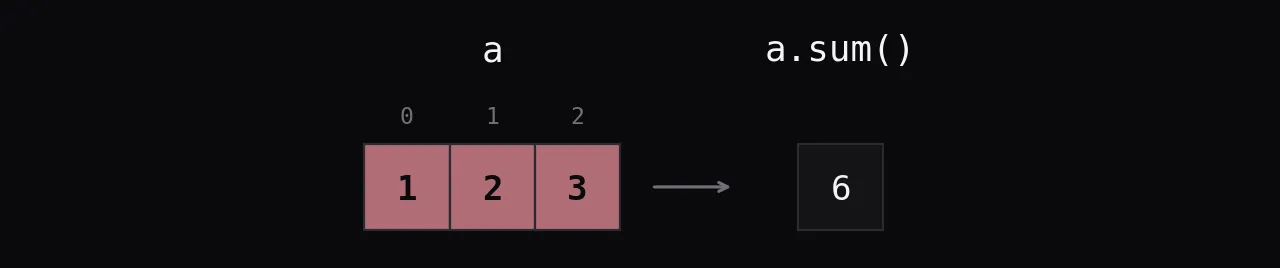
a.sum

全要素の合計です。

a.sum()
全要素の合計です。
全要素の合計です。

a.min

最小の要素です。そのインデックスは a.argmin() で得られます。

a.min()
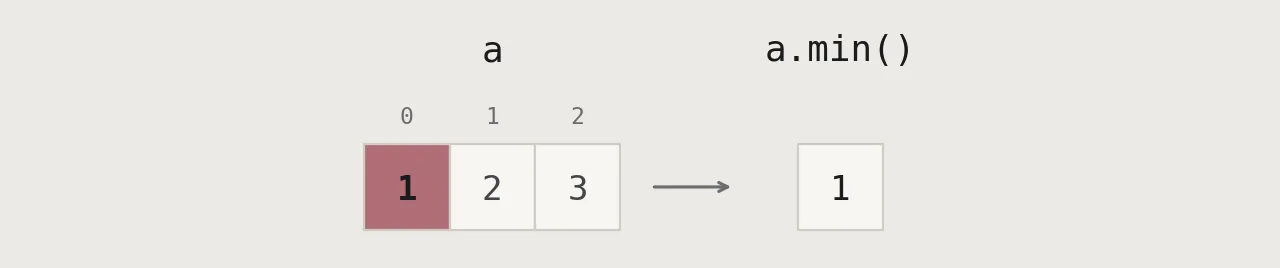
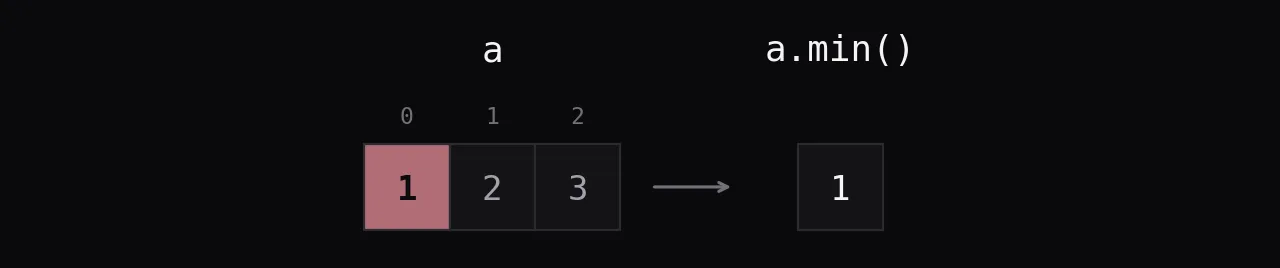
最小の要素です。そのインデックスは a.argmin() で得られます。

b.max(axis=0)

axis=0 では軸 0 に沿って、つまり行をまたいで縦に集約するので、各列から一つの値が出ます。チートシートには「行の最大値」とありますが、axis=0 では各列の最大値です。

b.max(axis=0)
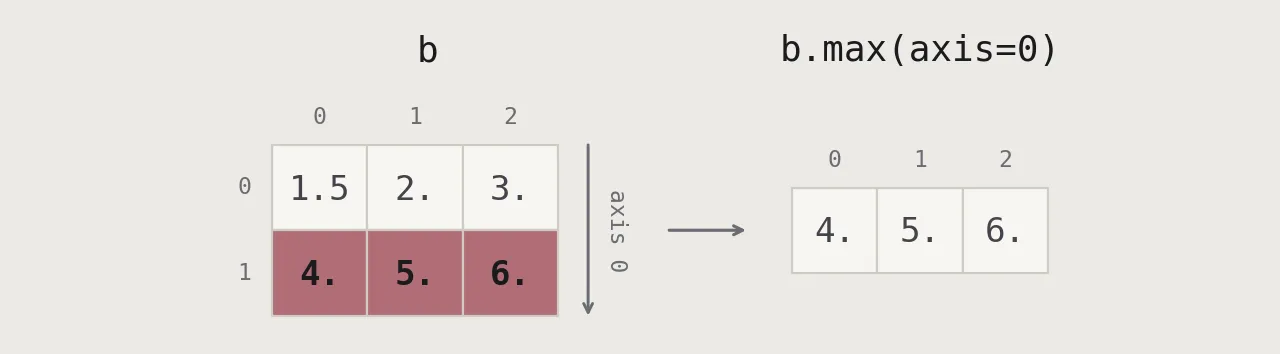
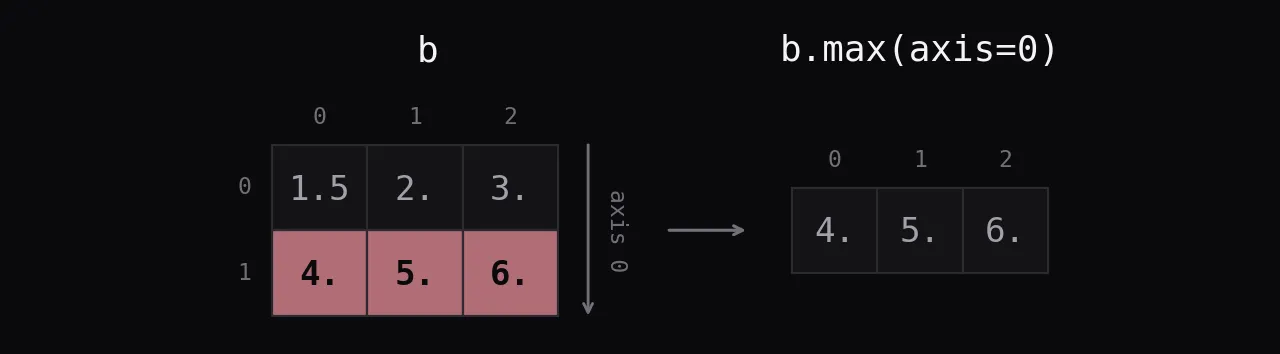
axis=0 では軸 0 に沿って、つまり行をまたいで縦に集約するので、各列から一つの値が出ます。チートシートには「行の最大値」とありますが、axis=0 では各列の最大値です。

b.cumsum(axis=1)

各行に沿った累積和です。形は変わりません。

b.cumsum(axis=1)
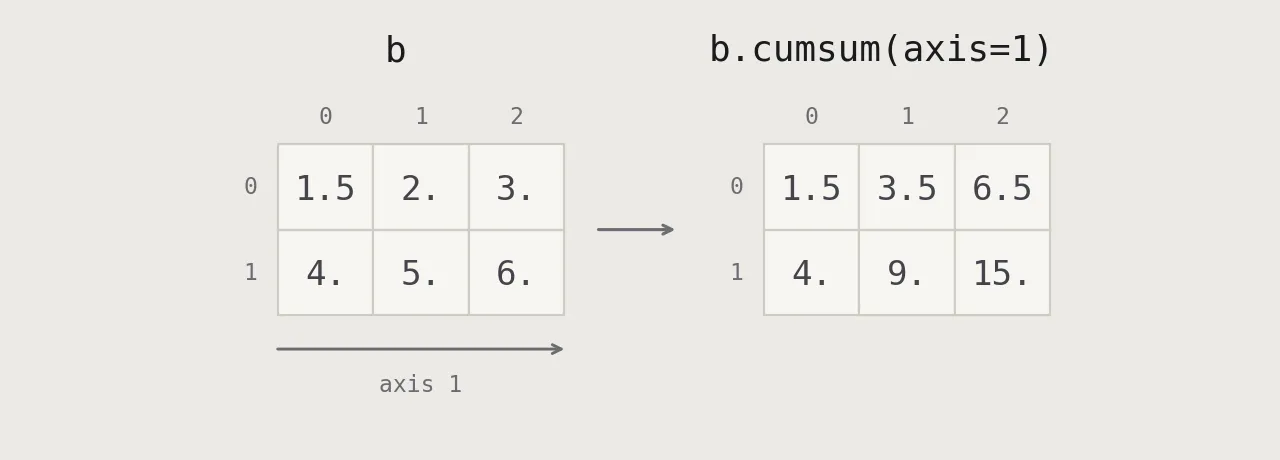
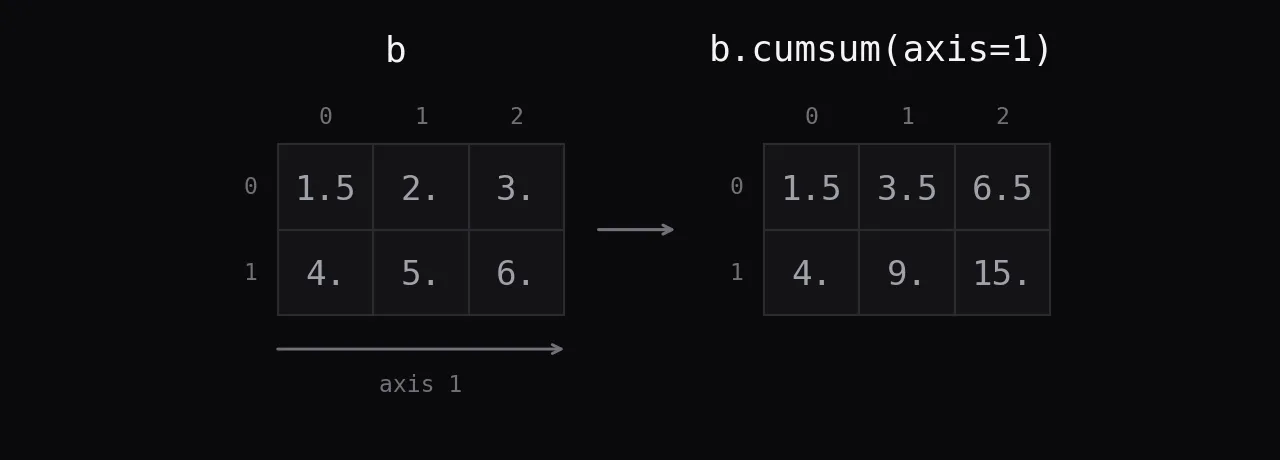
各行に沿った累積和です。形は変わりません。

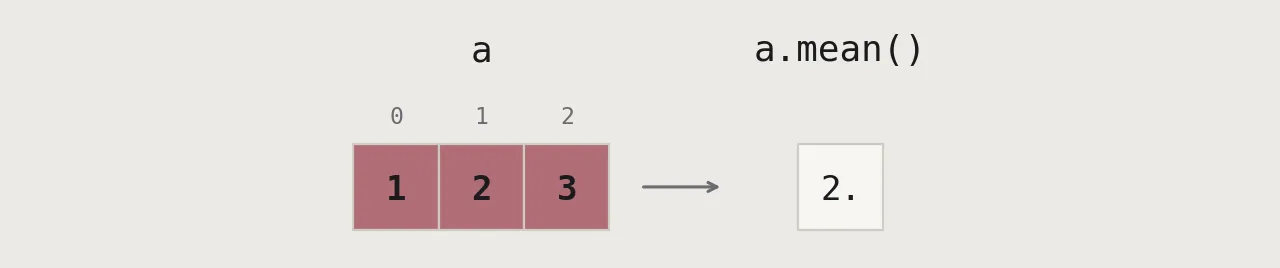
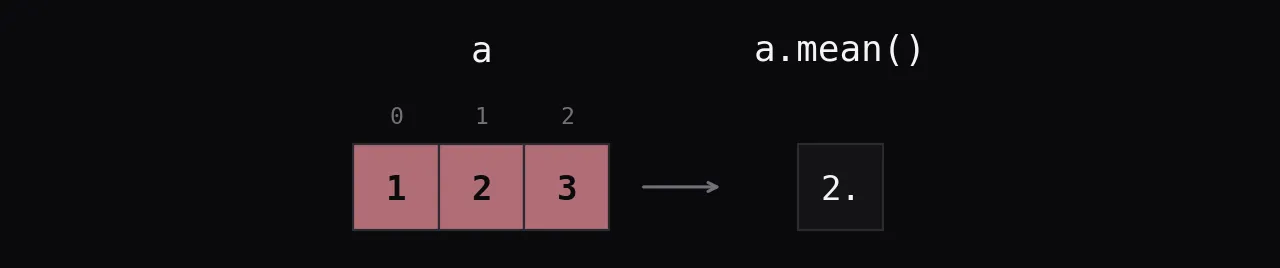
a.mean

全要素の算術平均です。

a.mean()
全要素の算術平均です。
全要素の算術平均です。

np.median

b.median() というメソッドはないので、チートシートの行は AttributeError になります。np.median を使います。値が 6 個なので、中央値は真ん中の 2 つ、3 と 4 の平均です。

np.median(b)
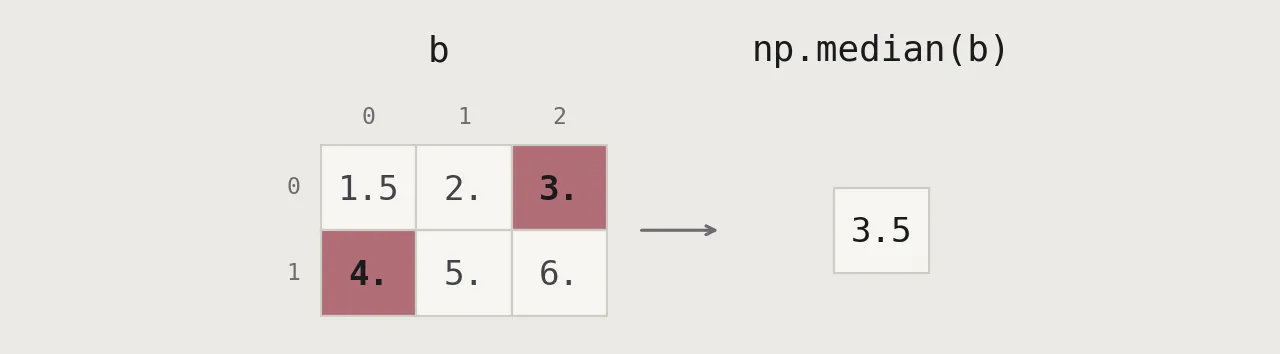
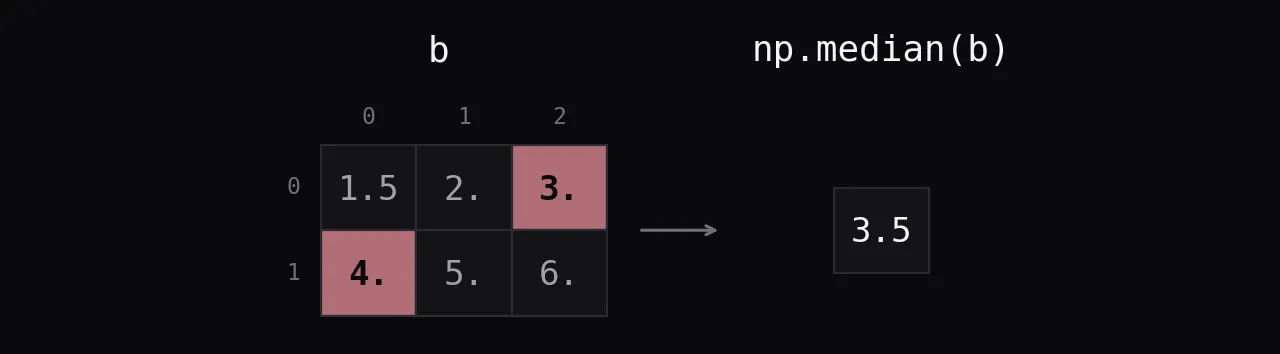
b.median() というメソッドはないので、チートシートの行は AttributeError になります。np.median を使います。値が 6 個なので、中央値は真ん中の 2 つ、3 と 4 の平均です。

np.corrcoef

a.corrcoef() というメソッドもありません。np.corrcoef は各行を一つの変数とみなし、その相関行列を返します。b の 2 行はほぼ完全に相関しています。

np.corrcoef(b)
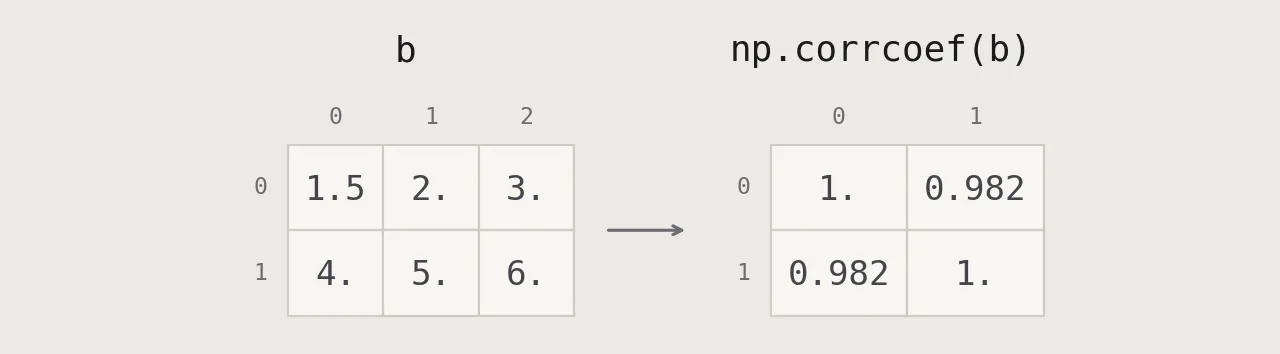
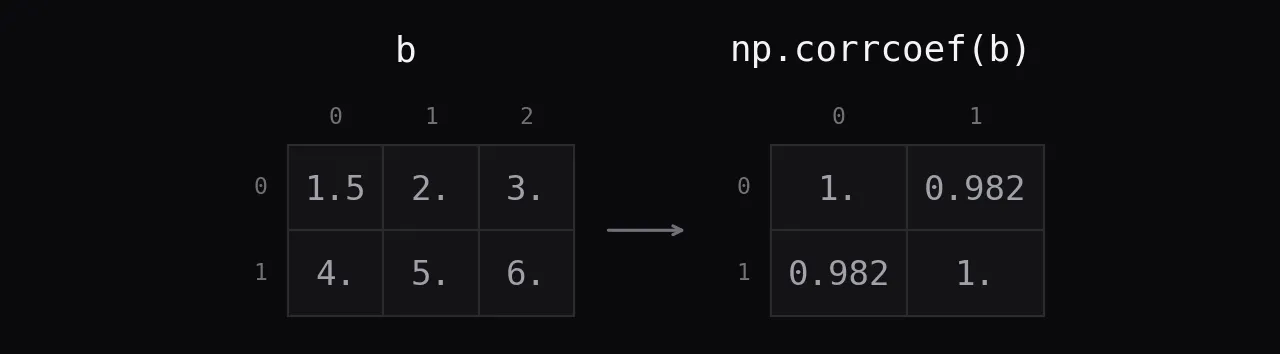
a.corrcoef() というメソッドもありません。np.corrcoef は各行を一つの変数とみなし、その相関行列を返します。b の 2 行はほぼ完全に相関しています。

np.std

全要素の標準偏差です。既定は母集団の式(ddof=0)で、標本の式にするには ddof=1 を渡します。

np.std(b)
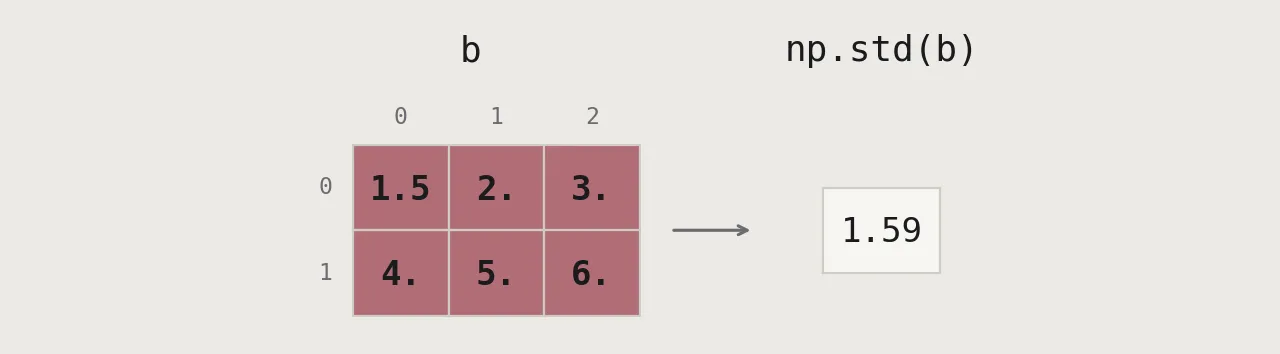
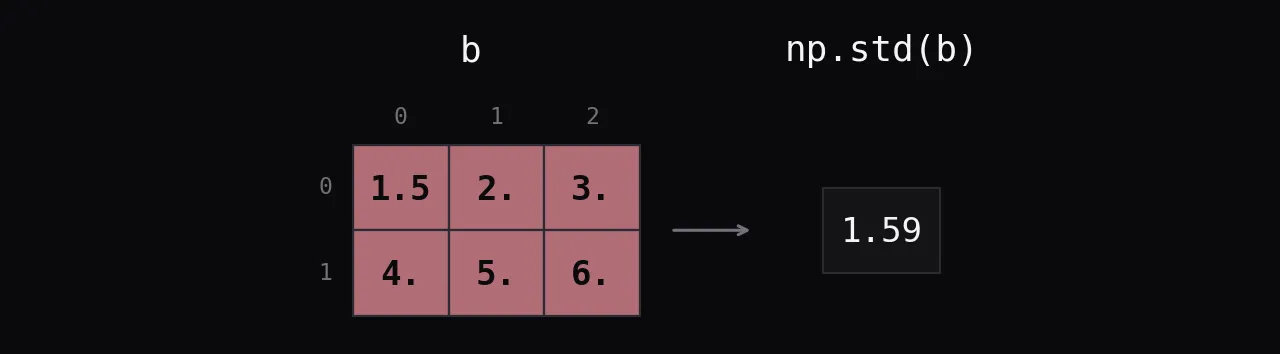
全要素の標準偏差です。既定は母集団の式(ddof=0)で、標本の式にするには ddof=1 を渡します。

配列のコピー

a.view

ビューは元の配列とメモリを共有します。h を通して書き込むと a も変わります。

h = a.view()
h[0] = 9
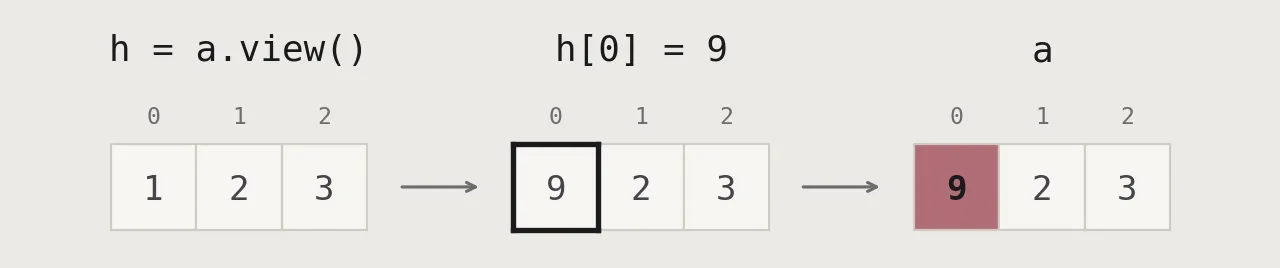
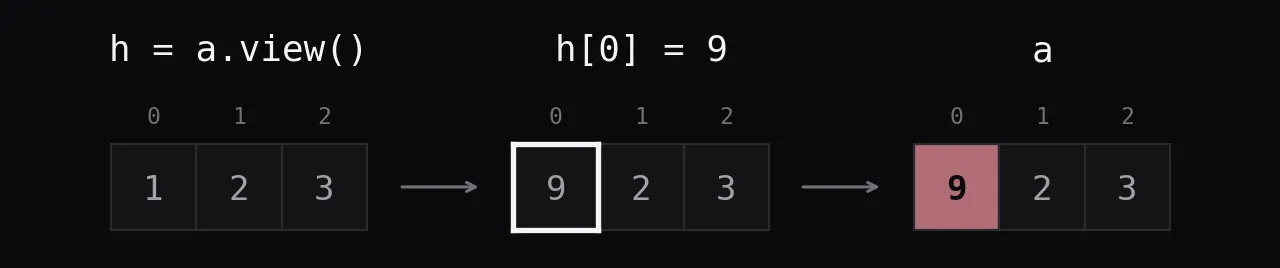
ビューは元の配列とメモリを共有します。h を通して書き込むと a も変わります。

a.copy

a.copy() も np.copy(a) も独立したコピーを作るので、a は変わりません。

h = a.copy()    # or np.copy(a)
h[0] = 9
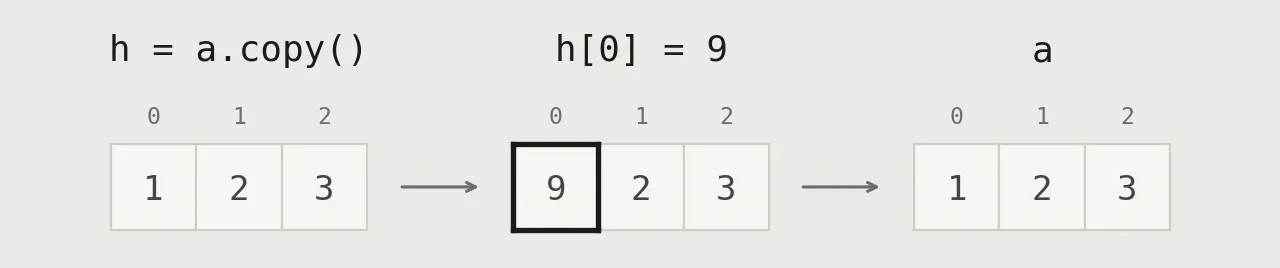
a.copy() も np.copy(a) も独立したコピーを作るので、a は変わりません。

ソート

x.sort

その場でソートし、None を返します。ソート済みのコピーが欲しいなら np.sort(x) です。チートシートの a はもうソート済みなので、ここでは x を使います。

x = np.array([3, 1, 2])
x.sort()
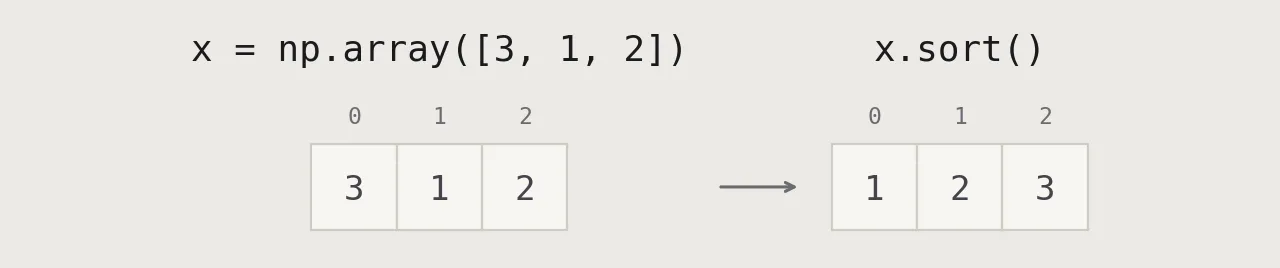
その場でソートし、None を返します。ソート済みのコピーが欲しいなら np.sort(x) です。チートシートの a はもうソート済みなので、ここでは x を使います。

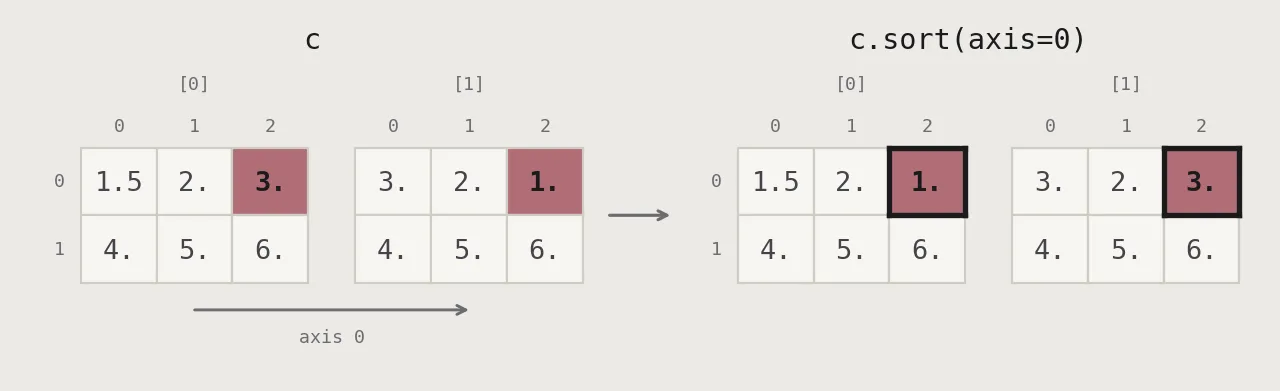
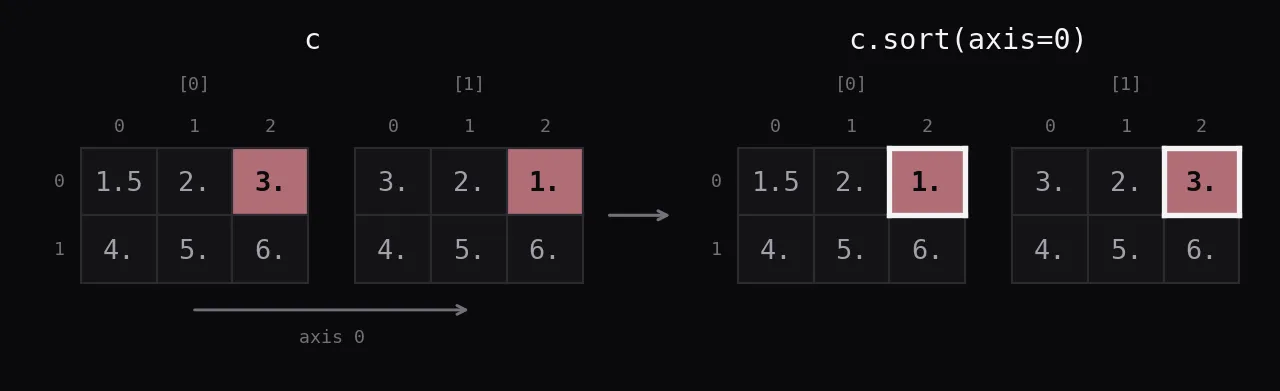
c.sort(axis=0)

軸 0 に沿ってソートします。各位置が 2 つのブロックの間で並べ替えられます。順序が逆なのは隅の 3 と 1 だけなので、入れ替わるのもそれだけです。

c.sort(axis=0)
軸 0 に沿ってソートします。各位置が 2 つのブロックの間で並べ替えられます。順序が逆なのは隅の 3 と 1 だけなので、入れ替わるのもそれだけです。

要素の取り出し・スライス・インデックス

a[2]

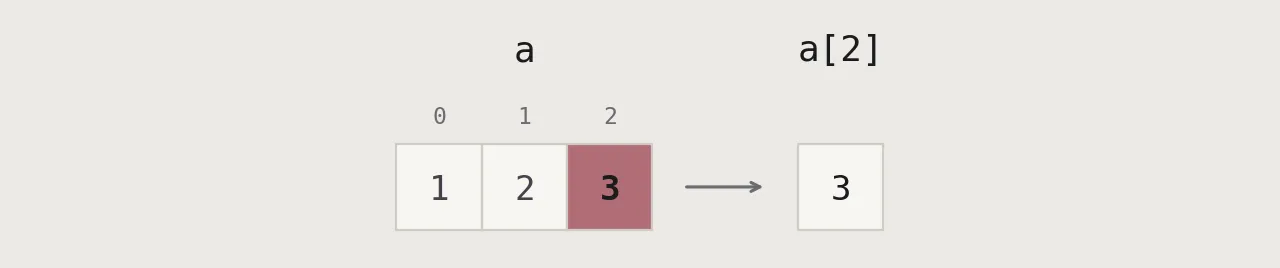
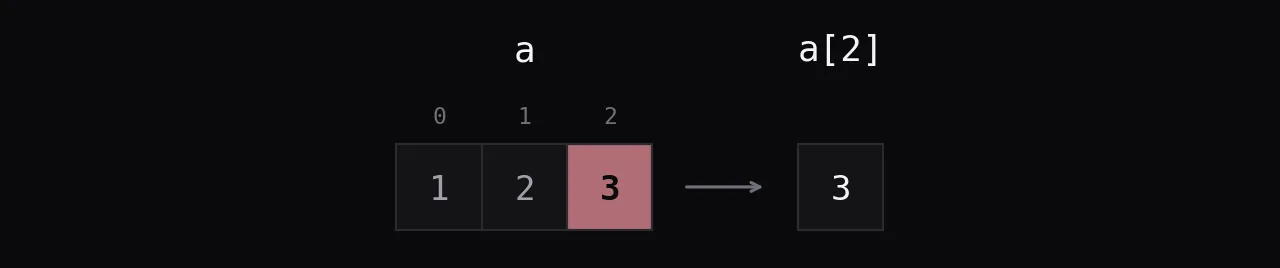
インデックス 2 の要素です。

a[2]
インデックス 2 の要素です。
インデックス 2 の要素です。

b[1, 2]

行 1、列 2 の要素です。b[1][2] と同じですが、インデックス操作が 2 回ではなく 1 回で済みます。

b[1, 2]
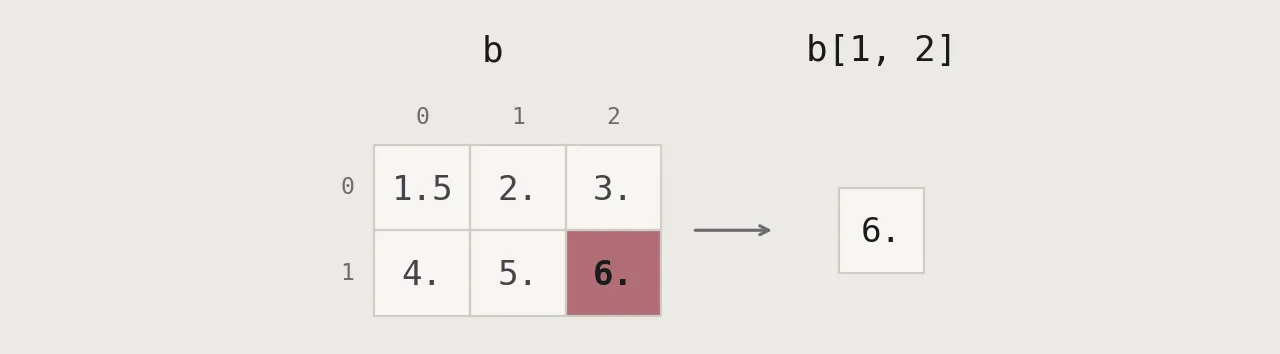
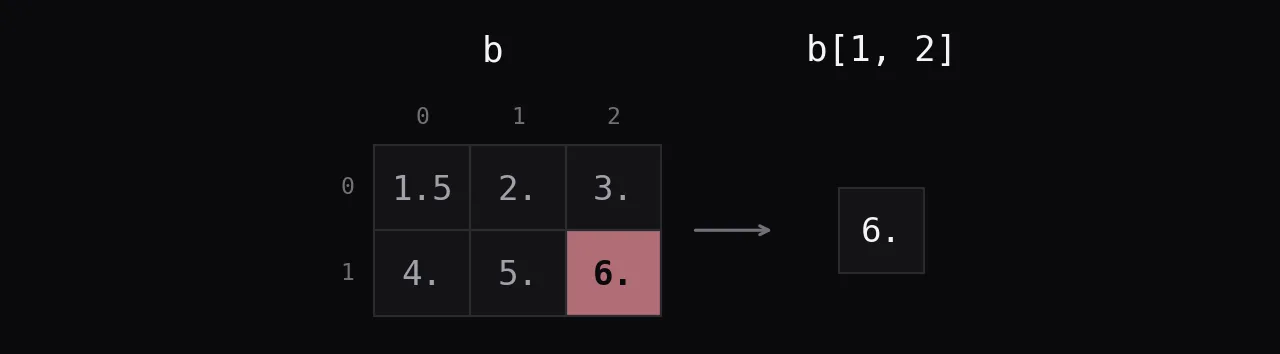
行 1、列 2 の要素です。b[1][2] と同じですが、インデックス操作が 2 回ではなく 1 回で済みます。

a[0:2]

start は含み、stop は含みません。インデックス 0 と 1 です。

a[0:2]
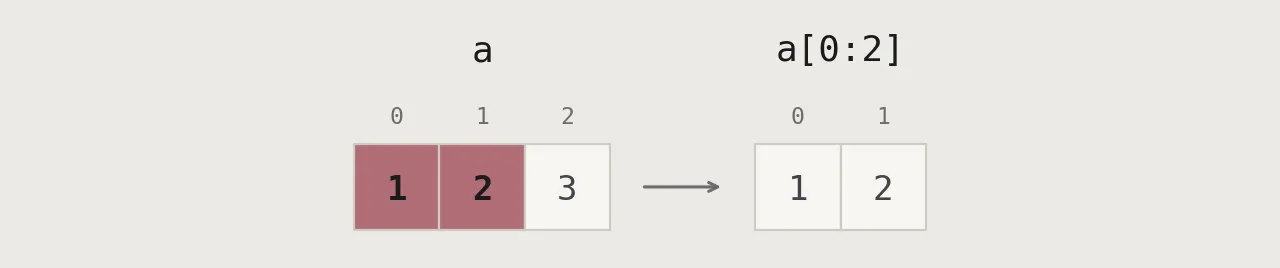
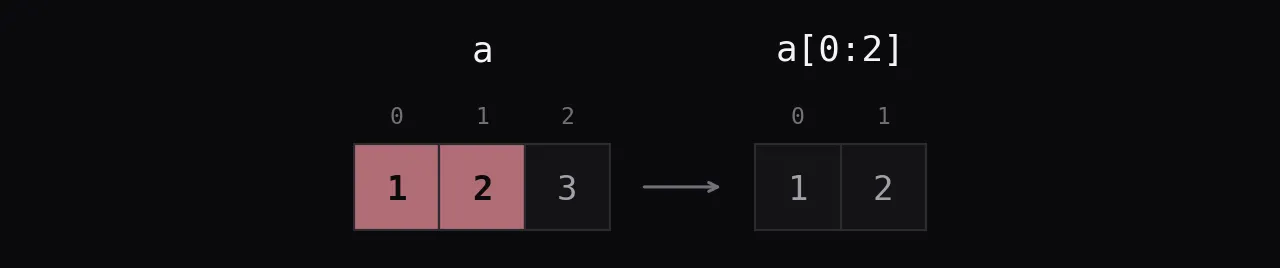
start は含み、stop は含みません。インデックス 0 と 1 です。

b[0:2, 1]

列 1 の行 0 と 1 です。単一のインデックスはその軸をなくすので、結果は 1D です。

b[0:2, 1]
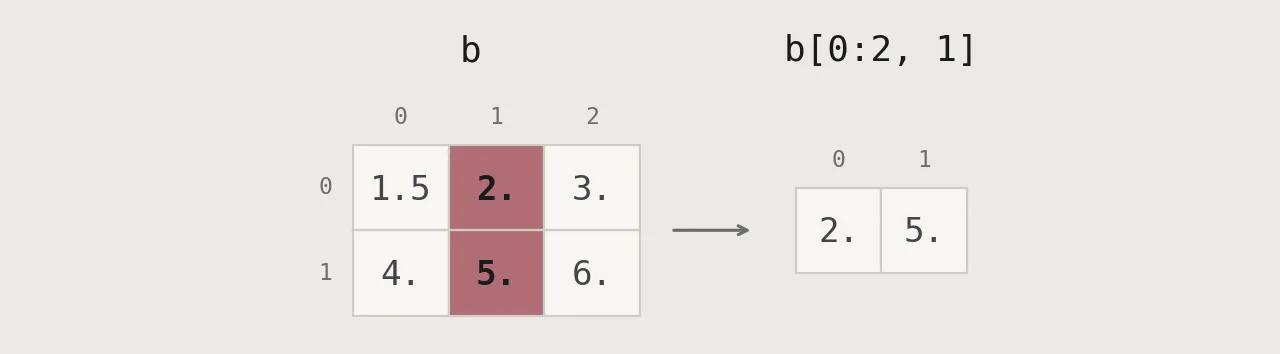
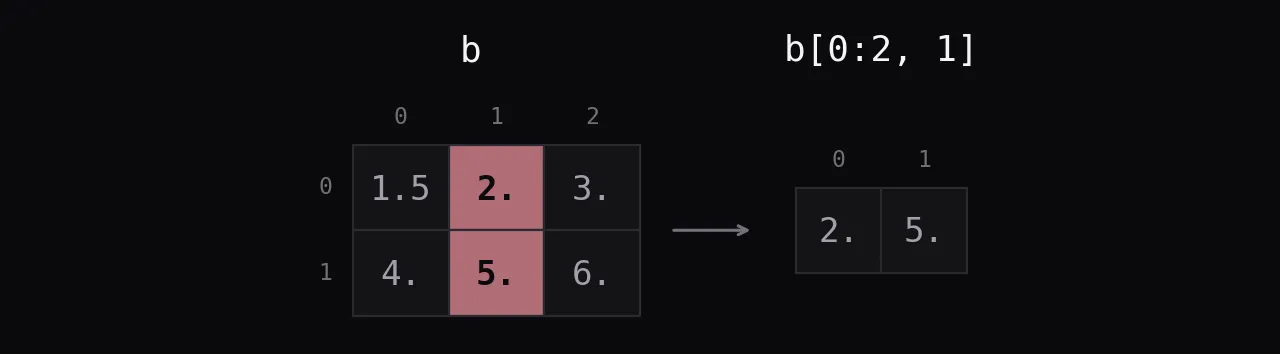
列 1 の行 0 と 1 です。単一のインデックスはその軸をなくすので、結果は 1D です。

b[:1]

スライスは軸を残します。b[:1] は 1 行の 2D 配列で、b[0] なら 1D です。b[0:1, :] と同じです。

b[:1]
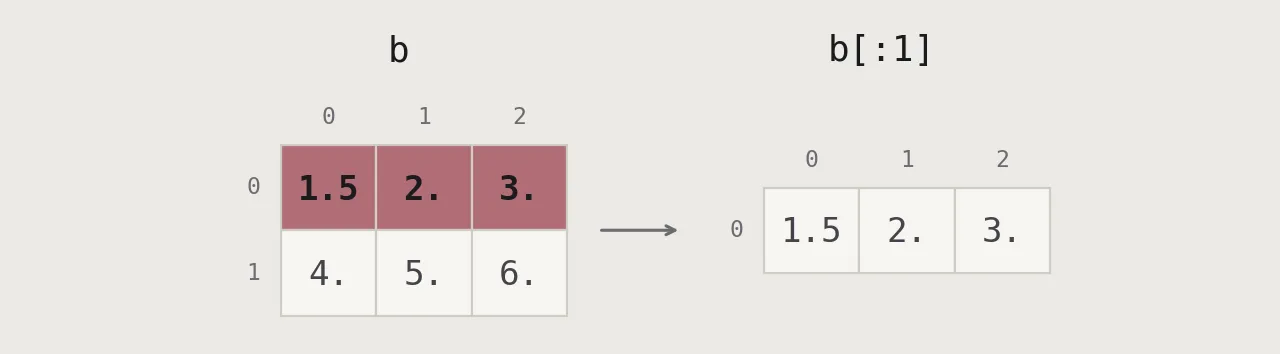
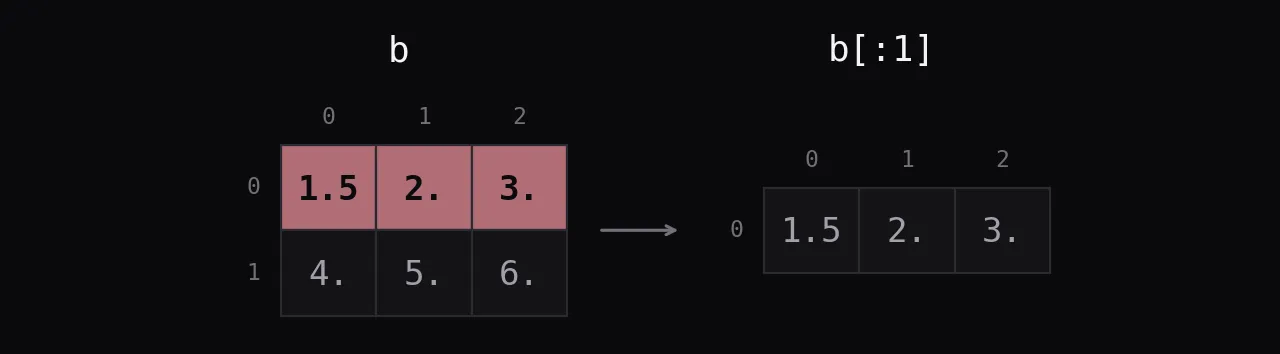
スライスは軸を残します。b[:1] は 1 行の 2D 配列で、b[0] なら 1D です。b[0:1, :] と同じです。

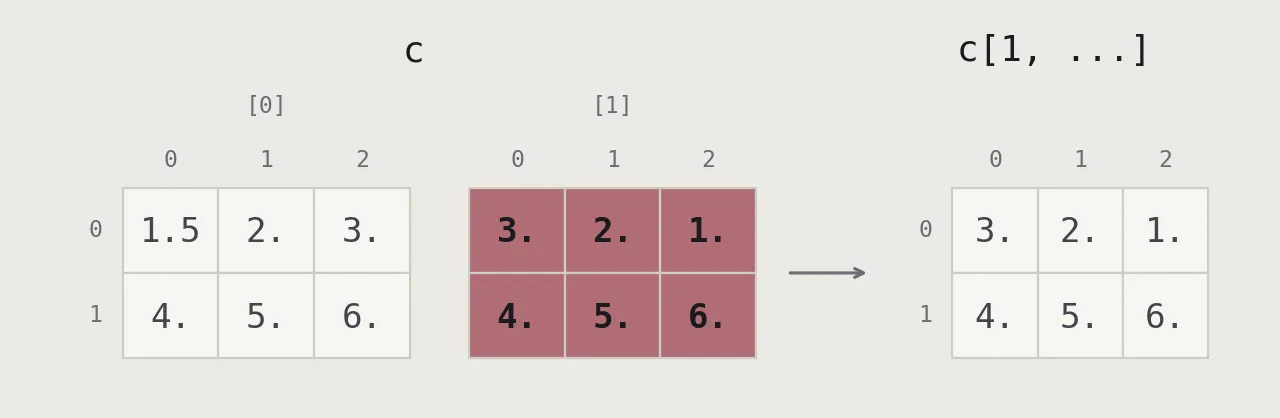
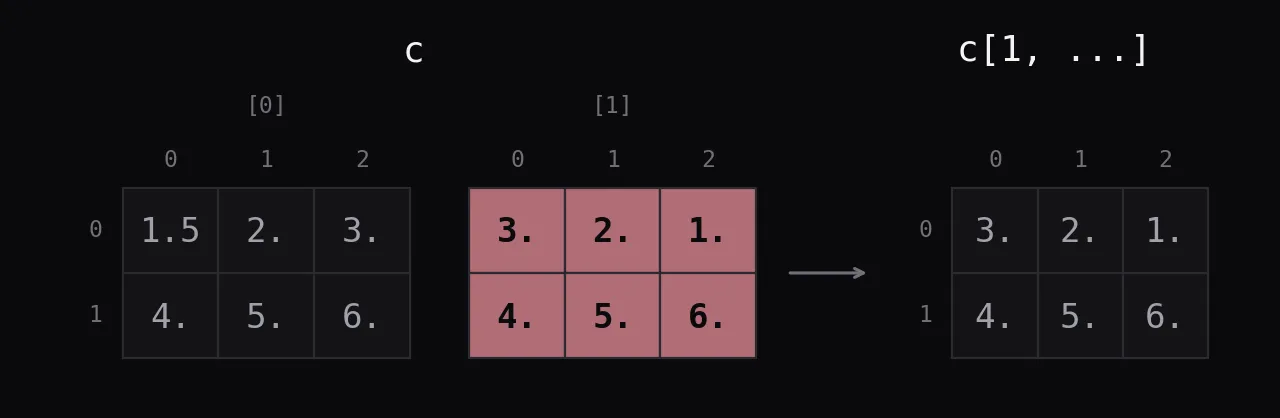
c[1, …]

... は必要な数の : の代わりになるので、c[1, ...] は c[1, :, :]、つまり 2 番目のブロックです。チートシートの出力は括弧が一つ多く印刷されていますが、結果は 2D です。

c[1, ...]
a[::-1]

負の刻みは後ろ向きにたどります。小さな数字は各要素がどこから来たかを示します。結果はコピーではなくビューです。

a[::-1]
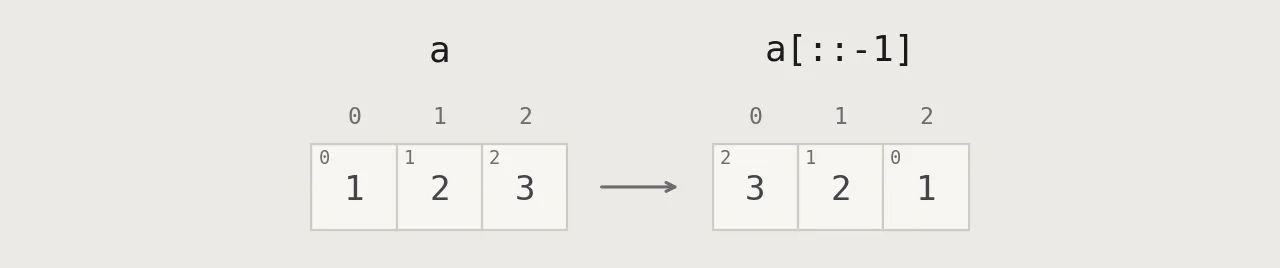
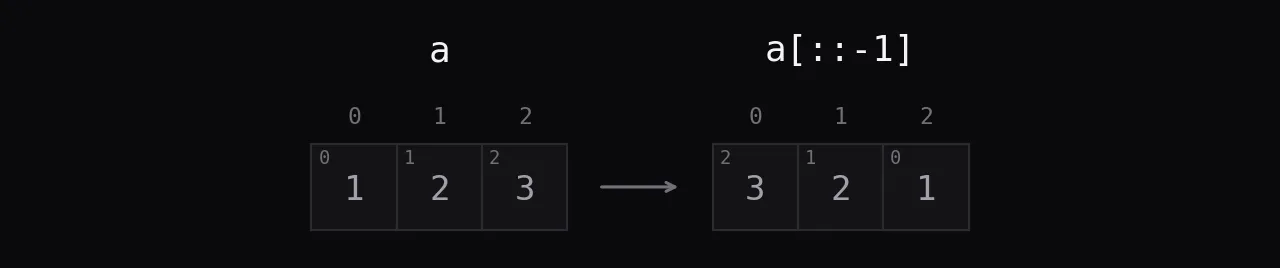
負の刻みは後ろ向きにたどります。小さな数字は各要素がどこから来たかを示します。結果はコピーではなくビューです。

a[a < 2]

bool 配列をインデックスに使うと、True の位置の要素だけが残ります。結果は常に 1D で、常にコピーです。

a[a < 2]
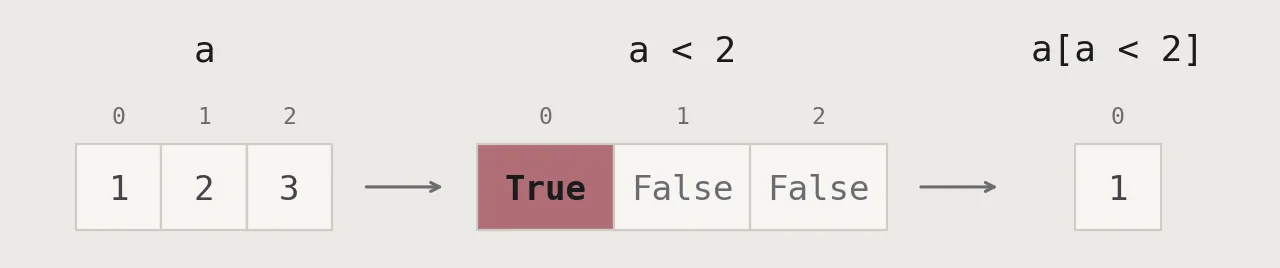
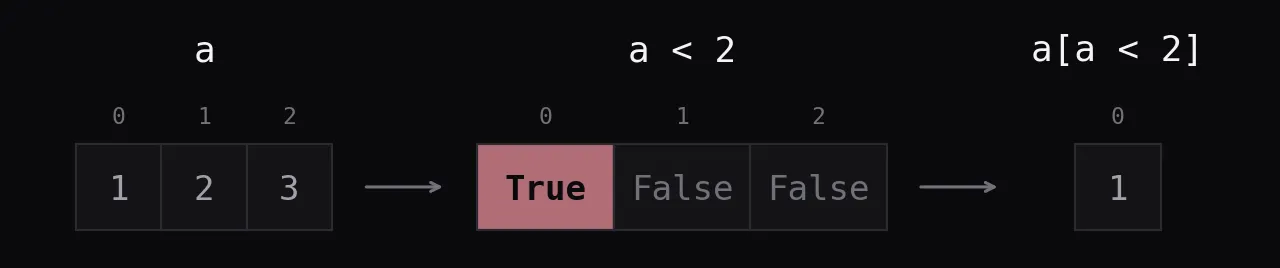
bool 配列をインデックスに使うと、True の位置の要素だけが残ります。結果は常に 1D で、常にコピーです。

b[[1, 0, 1, 0], [0, 1, 2, 0]]

2 つのインデックスのリストが組になり、(1, 0)、(0, 1)、(1, 2)、(0, 0) を選びます。小さな数字は順番です。ファンシーインデックスはコピーを返します。

b[[1, 0, 1, 0], [0, 1, 2, 0]]
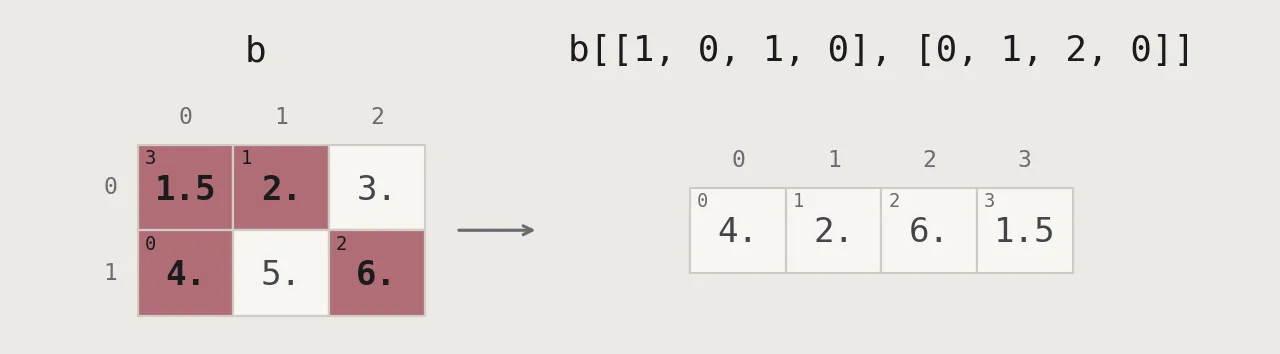
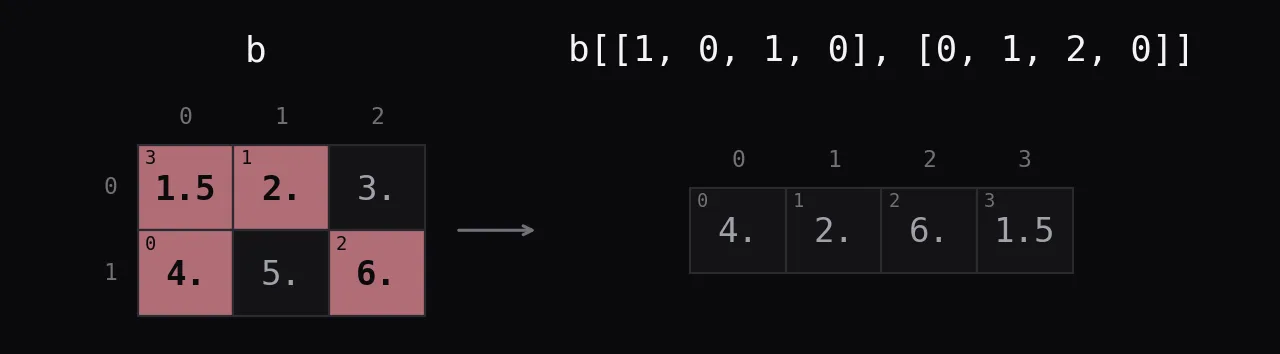
2 つのインデックスのリストが組になり、(1, 0)、(0, 1)、(1, 2)、(0, 0) を選びます。小さな数字は順番です。ファンシーインデックスはコピーを返します。

b[[1, 0, 1, 0]][:, [0, 1, 2, 0]]

まず行 1, 0, 1, 0 を、次にその結果から列 0, 1, 2, 0 を取ります。行と列が繰り返された 4x4 のグリッドになります。b[np.ix_([1, 0, 1, 0], [0, 1, 2, 0])] なら 1 ステップです。

b[[1, 0, 1, 0]][:, [0, 1, 2, 0]]
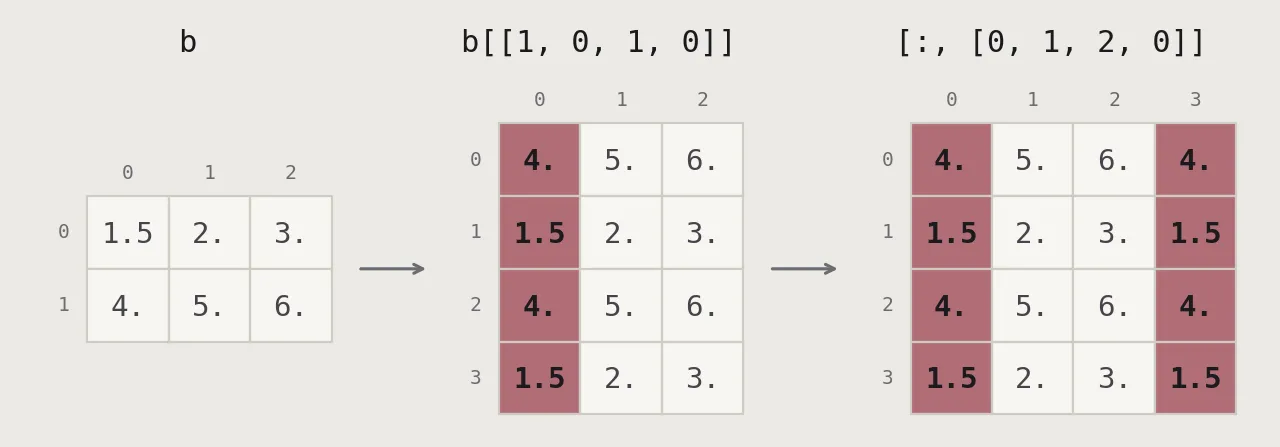
まず行 1, 0, 1, 0 を、次にその結果から列 0, 1, 2, 0 を取ります。行と列が繰り返された 4x4 のグリッドになります。b[np.ix_([1, 0, 1, 0], [0, 1, 2, 0])] なら 1 ステップです。

a[1:3] = 1

チートシートにはない例で、スライスを通した代入です。a[1:3] は a[1:3, :] の省略形で、右辺の一つの数は選ばれたすべてのセルにブロードキャストされます。隣り合わない行にはリストを使います:a[[0, 3]] = 1。

a = np.zeros((4, 4))
a[1:3] = 1     # rows 1 and 2
a[:, 3] = 1    # column 3
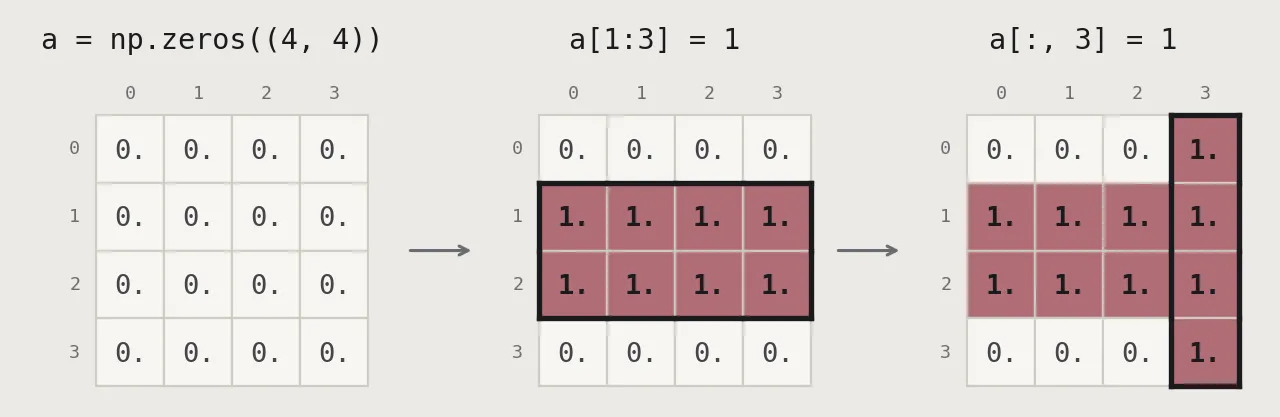
チートシートにはない例で、スライスを通した代入です。a[1:3] は a[1:3, :] の省略形で、右辺の一つの数は選ばれたすべてのセルにブロードキャストされます。隣り合わない行にはリストを使います:a[[0, 3]] = 1。

形の変更

np.transpose

軸を入れ替えるので、行 0 が列 0 になります。.T は短い書き方で、2 回転置すると b に戻ります。

i = np.transpose(b)
i.T
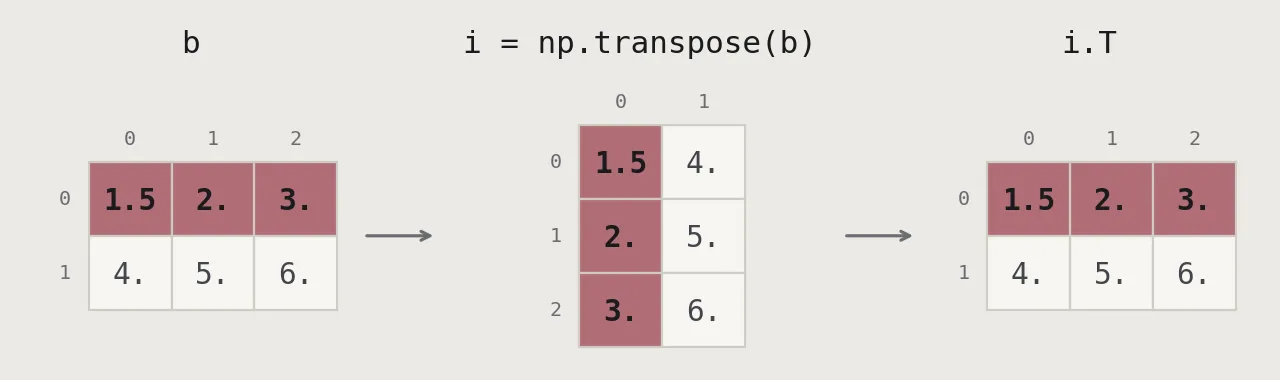
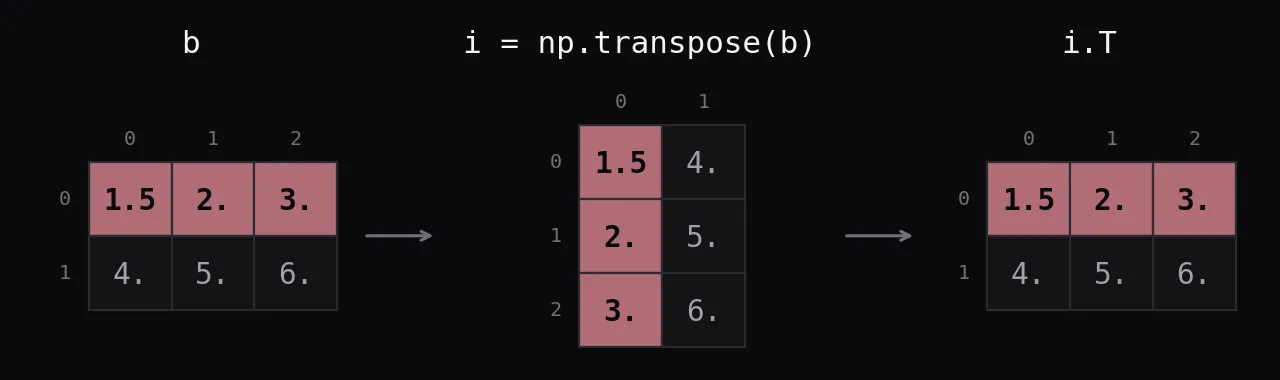
軸を入れ替えるので、行 0 が列 0 になります。.T は短い書き方で、2 回転置すると b に戻ります。

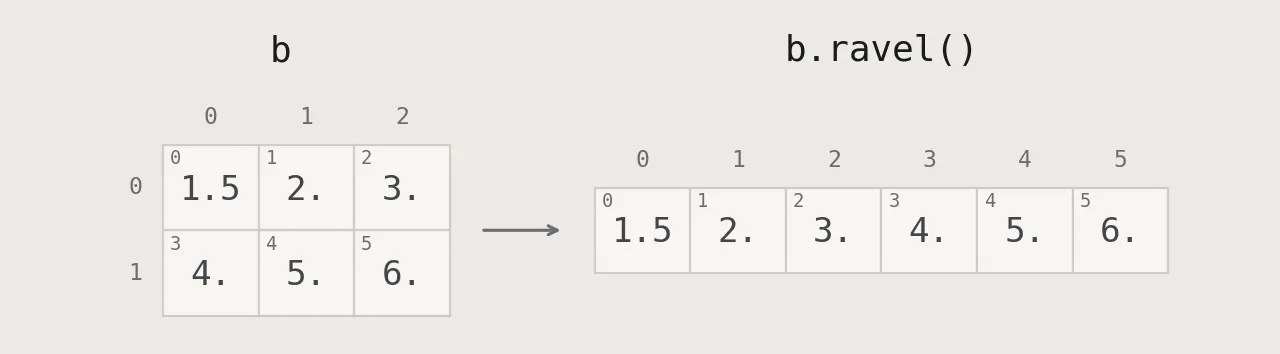
b.ravel

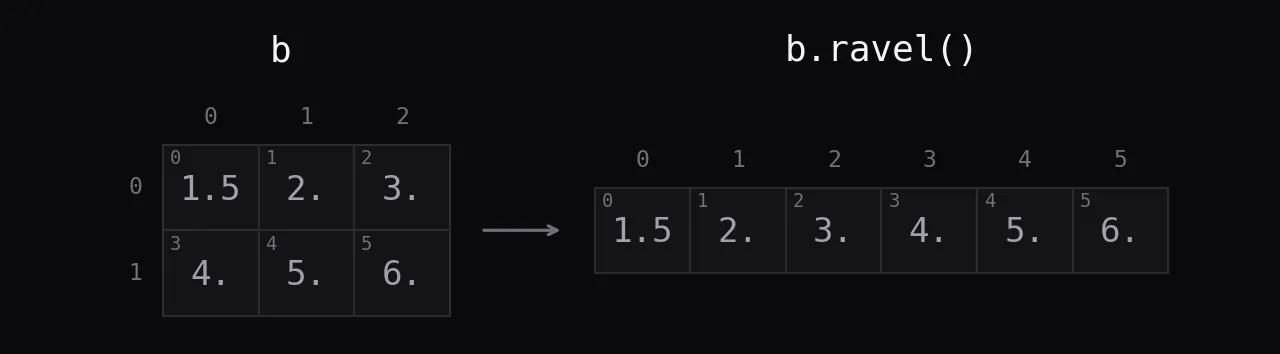
行の順に 1D へ平らにします。

b.ravel()
行の順に 1D へ平らにします。
行の順に 1D へ平らにします。

g.reshape

同じデータを新しい形にします。要素の順序は保たれます。-1 は「この長さは自動で計算して」という意味です。チートシートは -2 と書いていて NumPy はたまたま受け付けますが、ドキュメントにある値は -1 です。

g.reshape(3, -1)
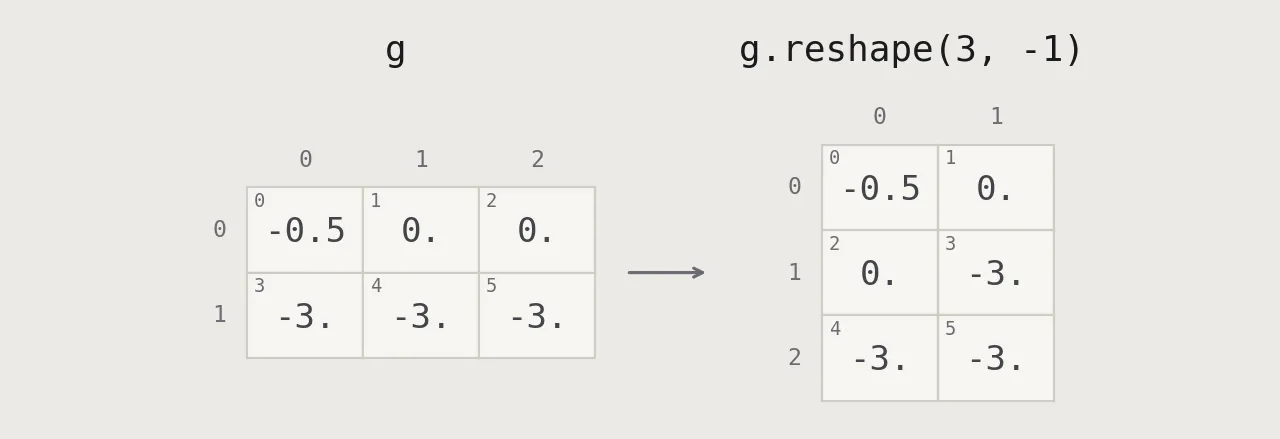
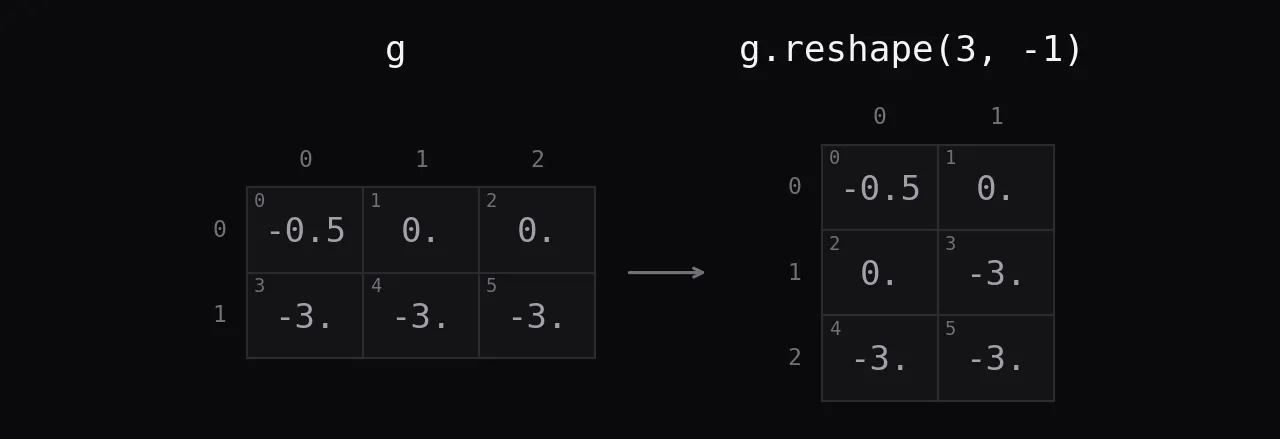
同じデータを新しい形にします。要素の順序は保たれます。-1 は「この長さは自動で計算して」という意味です。チートシートは -2 と書いていて NumPy はたまたま受け付けますが、ドキュメントにある値は -1 です。

resize

チートシートはビューに対して h.resize を呼んでいて、ValueError: cannot resize this array: it does not own its data になります。自分のデータを持つ配列なら、メソッドはその場で動き、足りない分を 0 で埋めます。関数 np.resize は新しい配列を返し、データを繰り返して埋めます。

h = b.copy()
h.resize((2, 6))
np.resize(b, (2, 6))
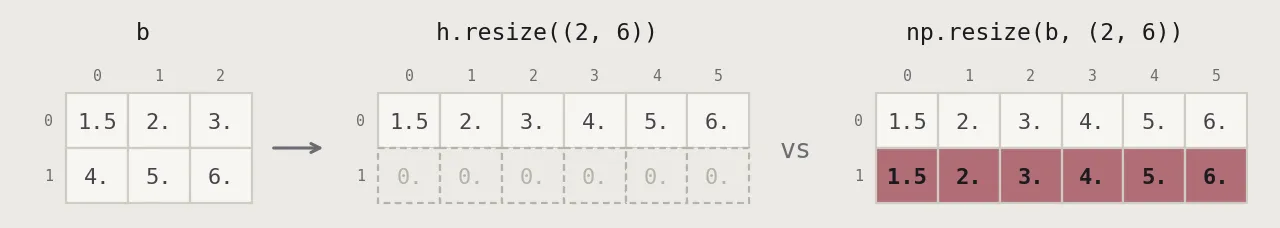
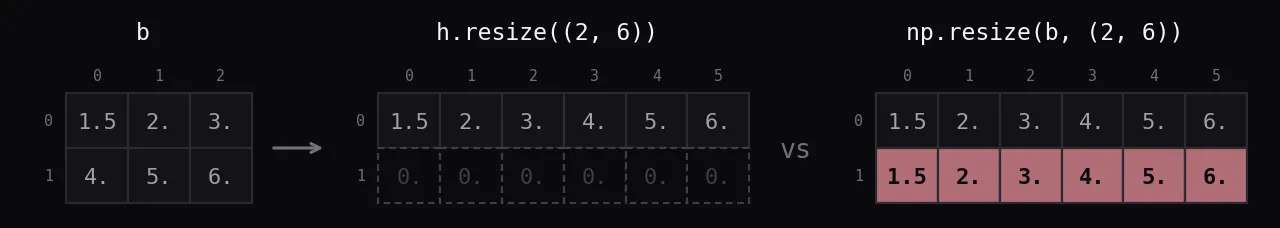
チートシートはビューに対して h.resize を呼んでいて、ValueError: cannot resize this array: it does not own its data になります。自分のデータを持つ配列なら、メソッドはその場で動き、足りない分を 0 で埋めます。関数 np.resize は新しい配列を返し、データを繰り返して埋めます。

要素の追加と削除

np.append

両方の配列を平らにして、新しい 1D 配列につなげます。形を保つなら axis= を渡します。

np.append(a, b)
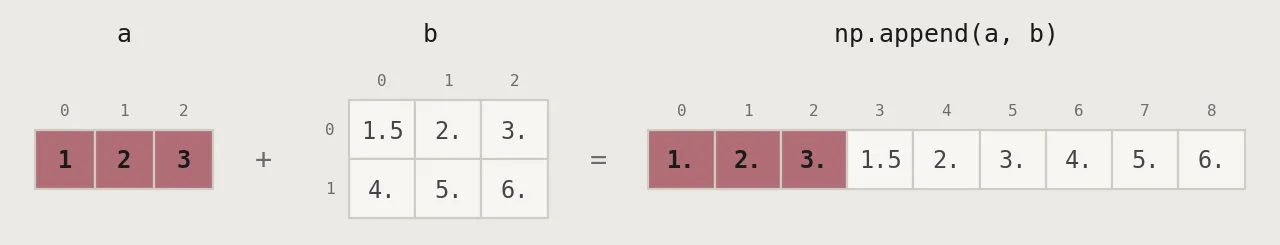
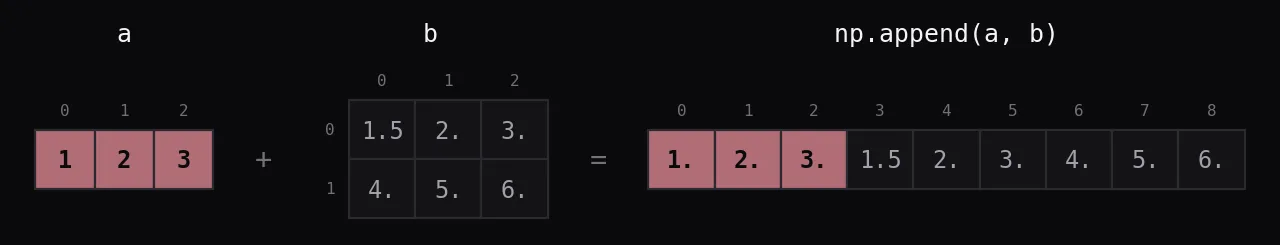
両方の配列を平らにして、新しい 1D 配列につなげます。形を保つなら axis= を渡します。

np.insert

インデックス 1 の前に 5 を挿入し、新しい配列を返します。NumPy の配列がその場で大きくなることはありません。

np.insert(a, 1, 5)
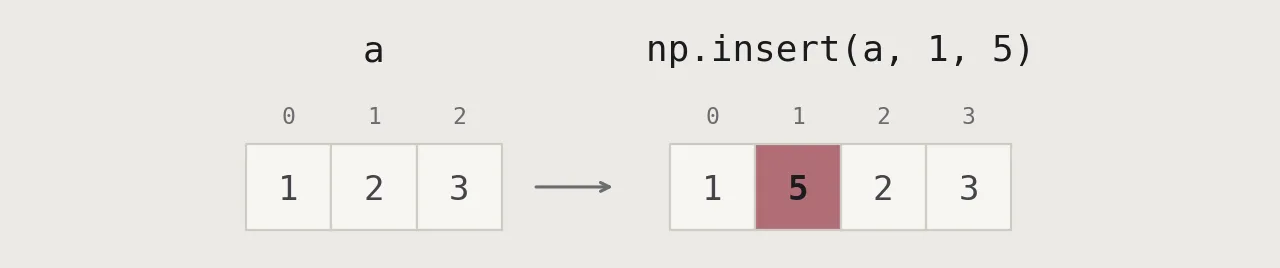
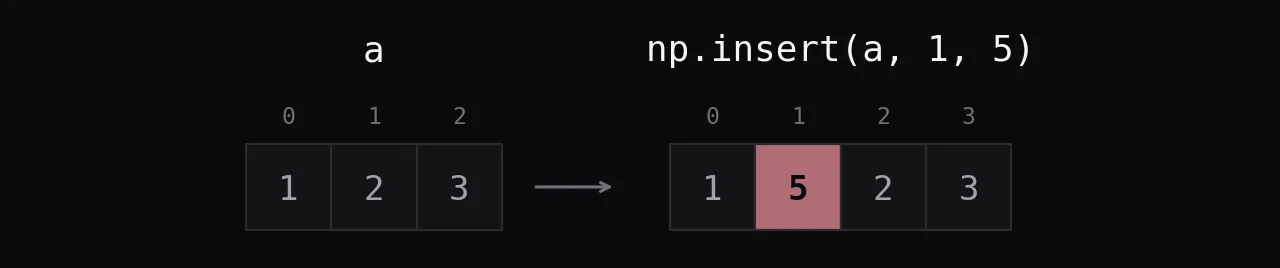
インデックス 1 の前に 5 を挿入し、新しい配列を返します。NumPy の配列がその場で大きくなることはありません。

np.delete

インデックス 1 を削除した新しい配列を返します。

np.delete(a, [1])
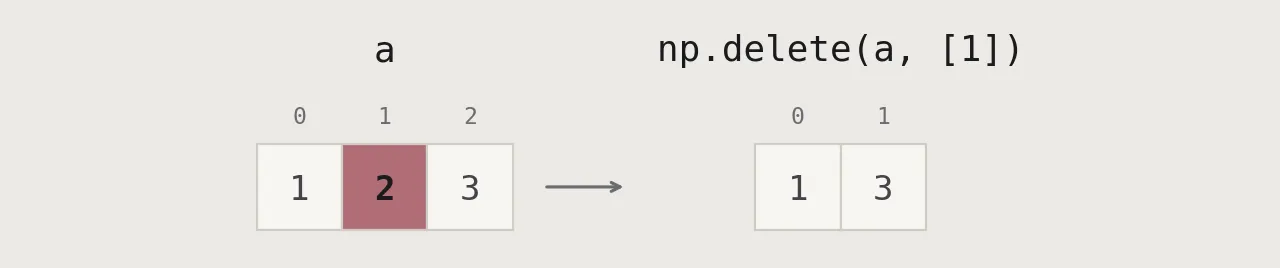
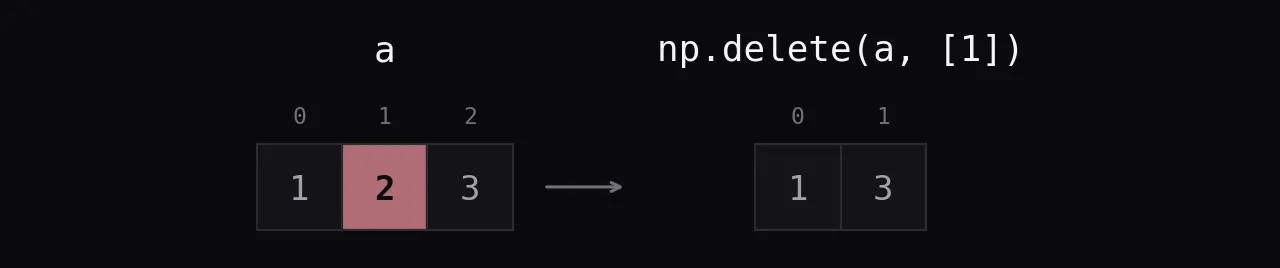
インデックス 1 を削除した新しい配列を返します。

配列の結合

np.concatenate

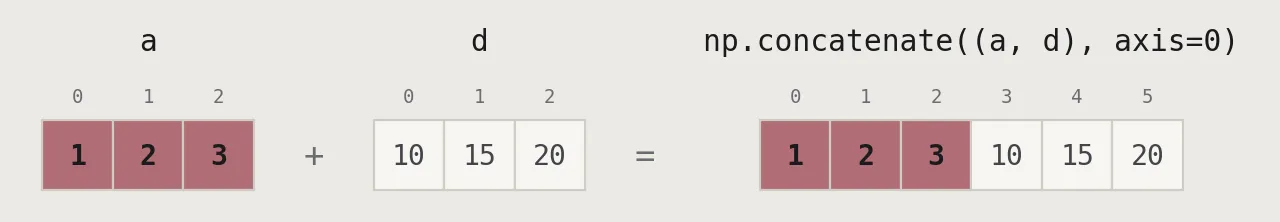
既にある軸に沿って配列をつなげます。

np.concatenate((a, d), axis=0)
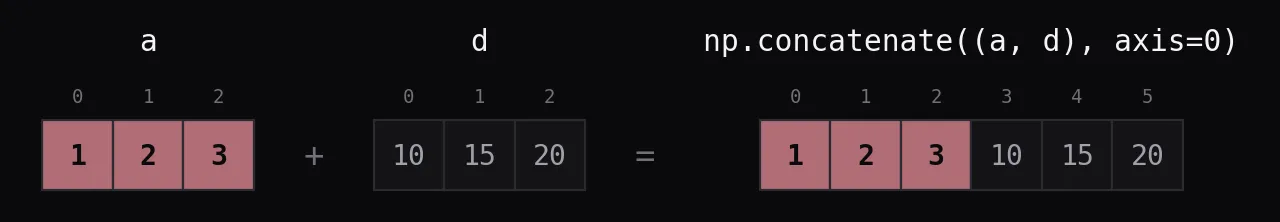
既にある軸に沿って配列をつなげます。
既にある軸に沿って配列をつなげます。

np.vstack

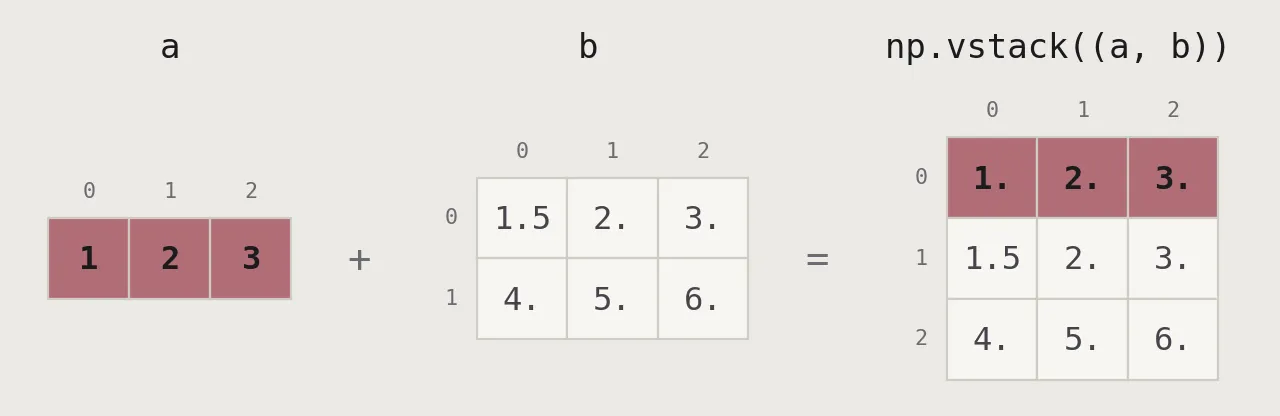
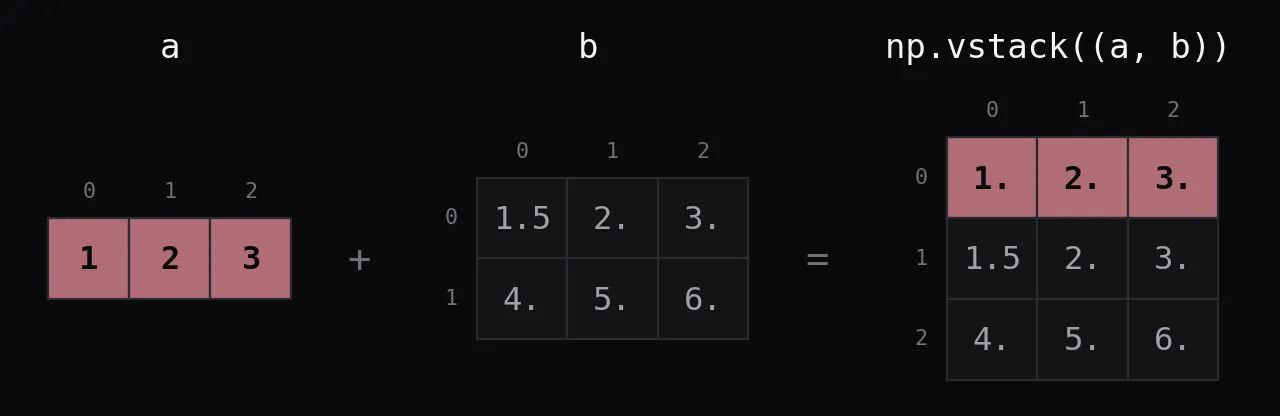
行を積み重ねます。a が最初の行になり、b の行が続きます。

np.vstack((a, b))
行を積み重ねます。a が最初の行になり、b の行が続きます。

np.r_

インデックス風の省略記法で、軸 0 に沿ってつなげます。ここでは np.vstack((e, f)) と同じです。

np.r_[e, f]
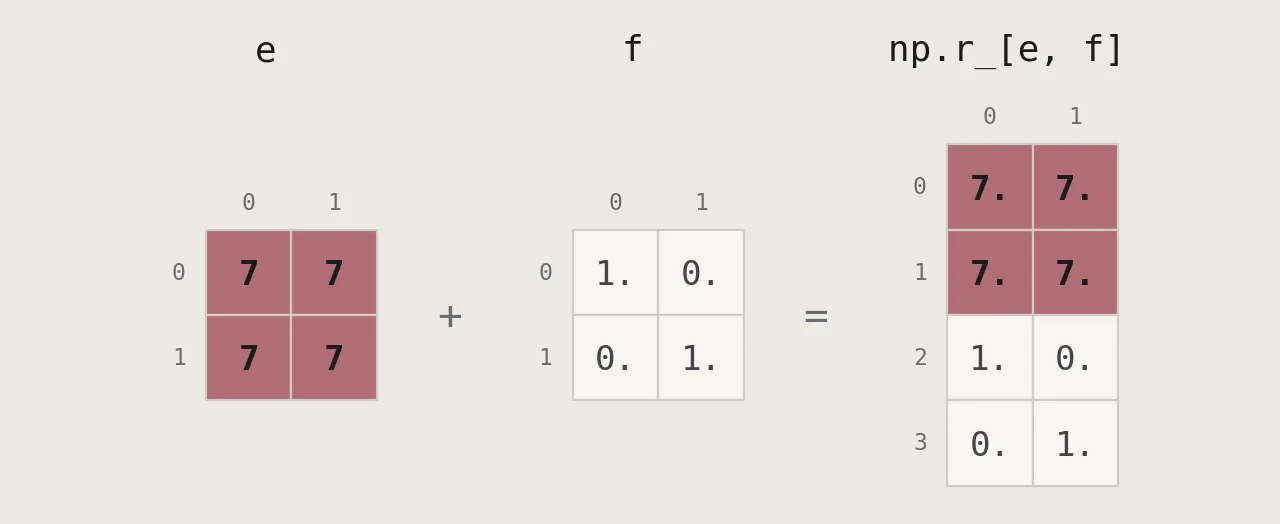
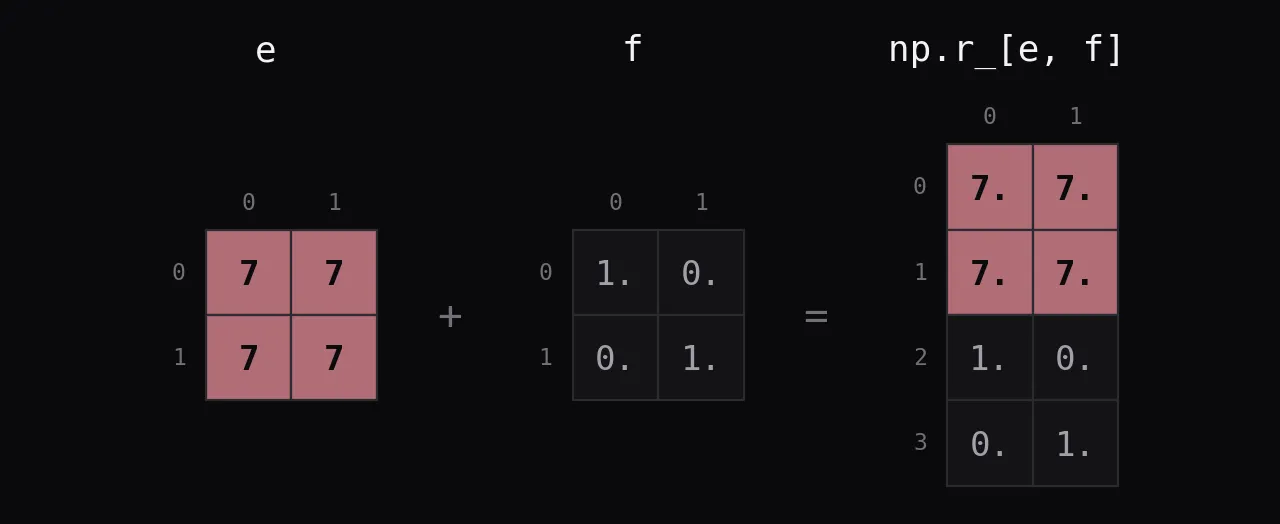
インデックス風の省略記法で、軸 0 に沿ってつなげます。ここでは np.vstack((e, f)) と同じです。

np.hstack

横に並べて、軸 1 に沿ってつなげます。

np.hstack((e, f))
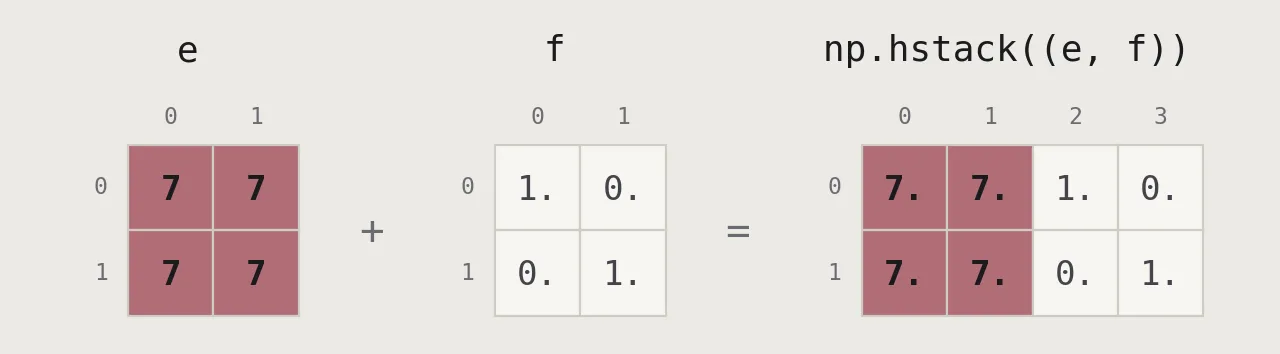
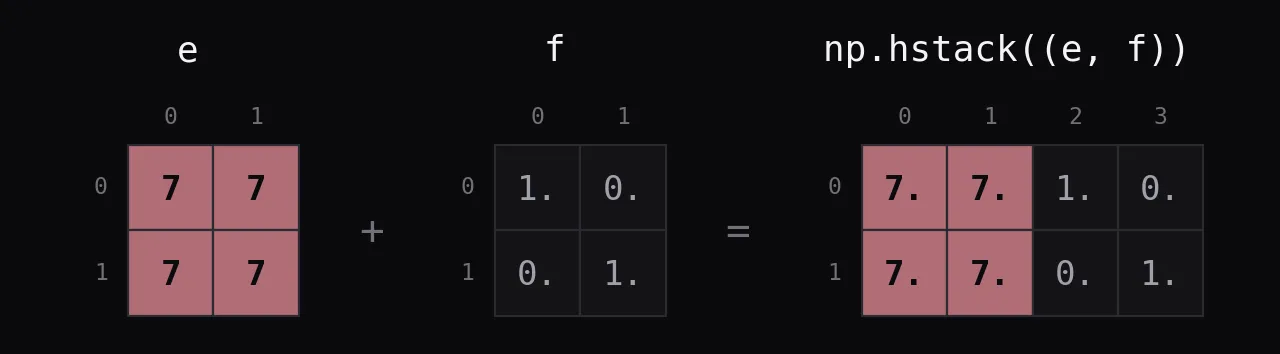
横に並べて、軸 1 に沿ってつなげます。

np.column_stack

1D 配列を列にして並べます。np.c_[a, d] も同じ結果です。

np.column_stack((a, d))
np.c_[a, d]
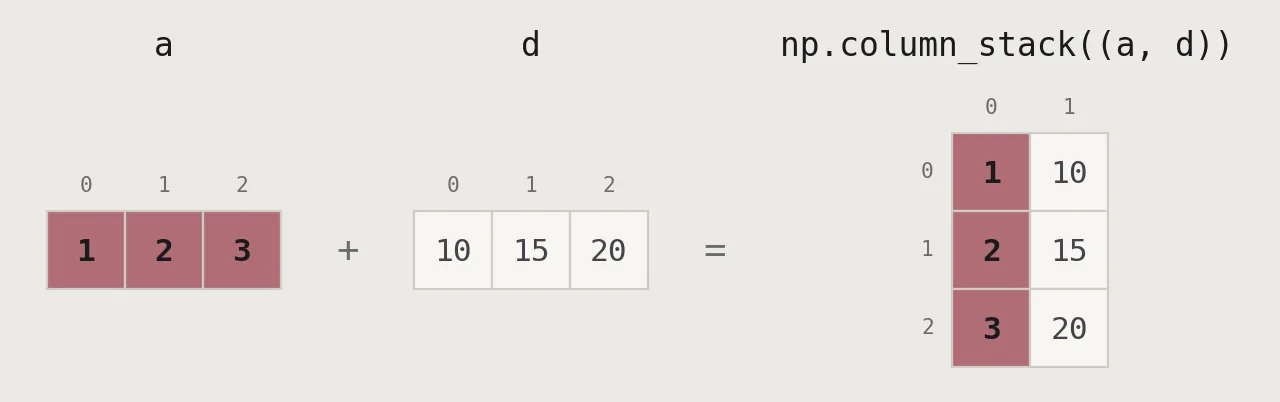
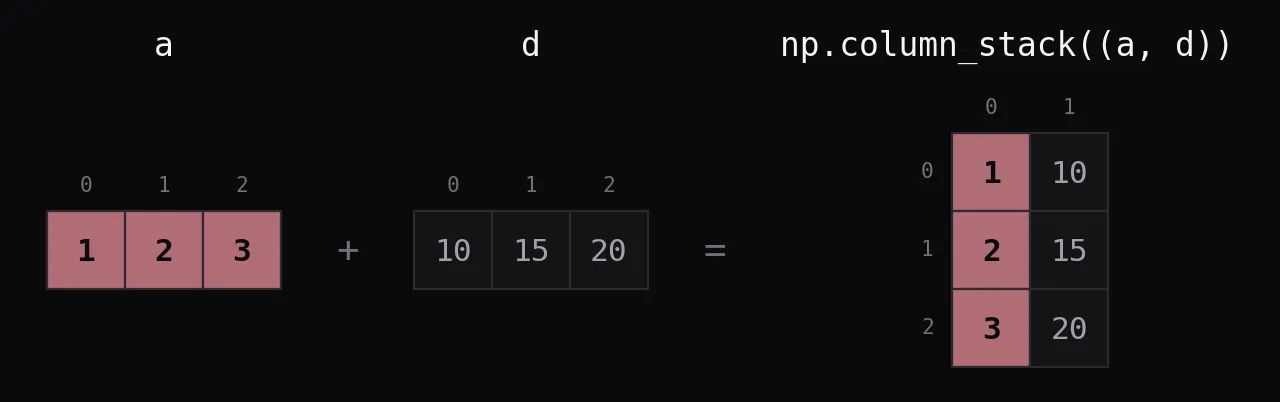
1D 配列を列にして並べます。np.c_[a, d] も同じ結果です。

配列の分割

np.hsplit

軸 1 に沿って 3 等分します。1D 配列ではそれが唯一の軸です。結果は配列のリストです。

np.hsplit(a, 3)
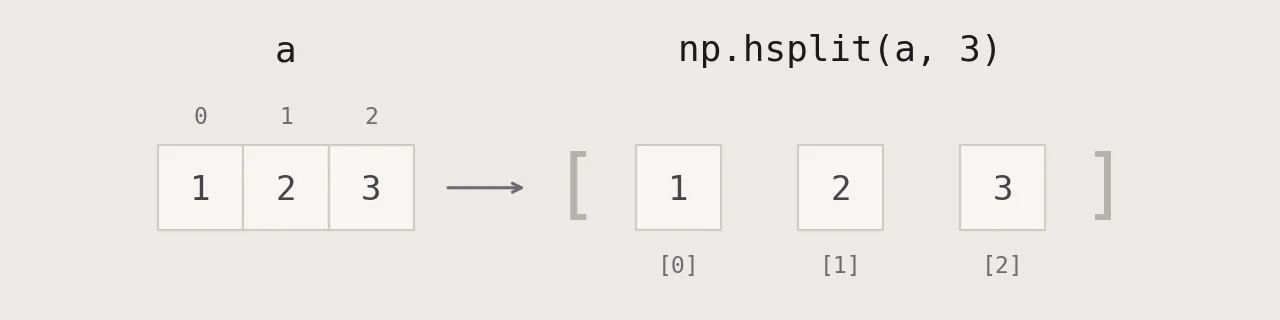
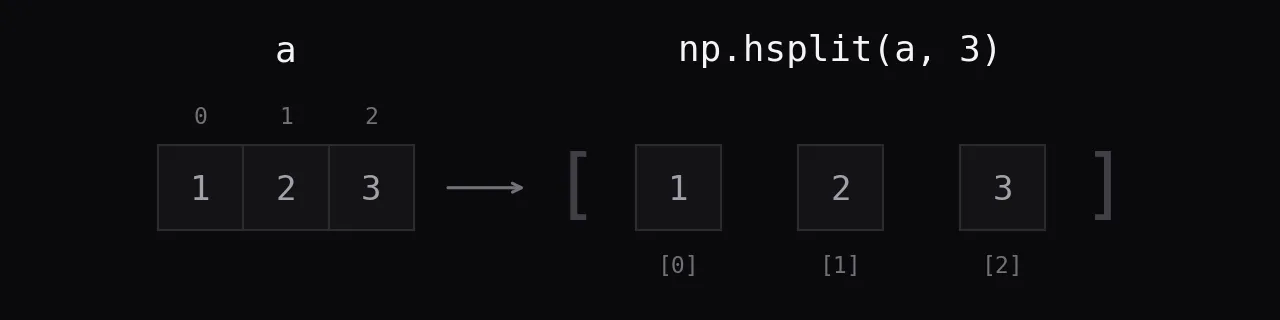
軸 1 に沿って 3 等分します。1D 配列ではそれが唯一の軸です。結果は配列のリストです。

np.vsplit

軸 0 に沿って 2 つに分けます。ここでは c の 2 つのブロックです。チートシートがこの行に印刷している値は誤りで、図が正しい値です。

np.vsplit(c, 2)
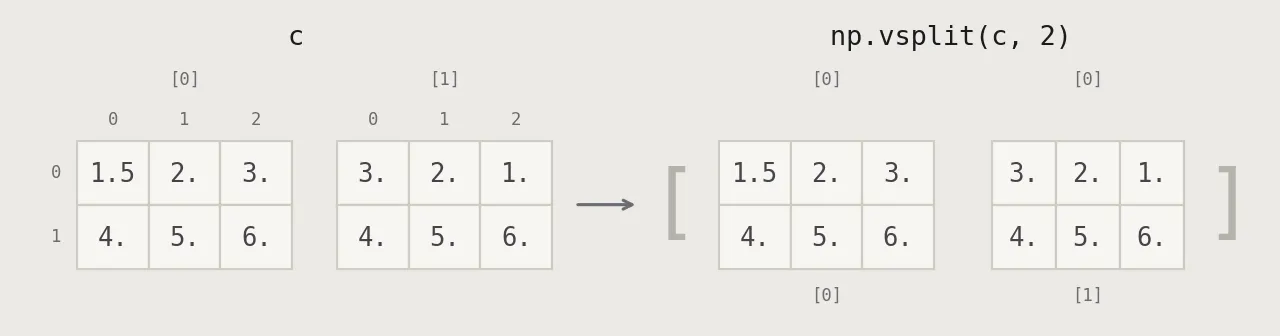
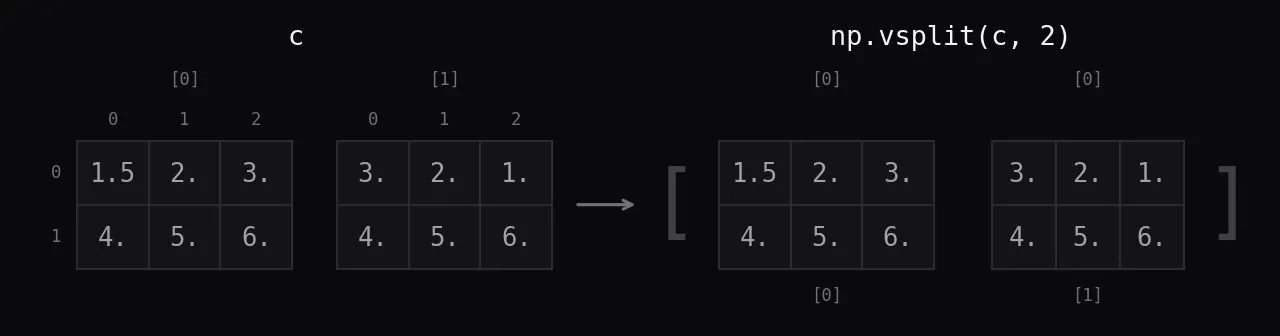
軸 0 に沿って 2 つに分けます。ここでは c の 2 つのブロックです。チートシートがこの行に印刷している値は誤りで、図が正しい値です。